Crawl4AI
Crawl4AI 是一款开源的网页爬取与抓取工具,旨在与大语言模型(LLM)、AI Agent 及数据管道无缝集成。它能够实现高速、实时的数据提取,同时保持灵活性且易于部署。
面向 AI 驱动网页抓取的核心特性包括:
- 专为 LLM 打造: 生成经过优化的结构化 Markdown,适用于检索增强生成(RAG)与微调。
- 灵活的浏览器控制: 支持会话管理、代理使用和自定义钩子。
- 启发式智能: 使用智能算法优化数据解析。
- 完全开源: 无需 API 密钥;可通过 Docker 和云平台部署。
在官方文档中了解更多信息。
为什么要将 Scrapeless 与 Crawl4AI 结合使用?
Crawl4AI 在结构化网页数据提取方面表现出色,并支持 LLM 驱动的解析和基于模式的抓取。然而,在应对高级反机器人机制时,它仍可能面临挑战,例如:
- 本地浏览器被 Cloudflare、AWS WAF 或 reCAPTCHA 拦截
- 大规模并发爬取时的性能瓶颈,浏览器启动缓慢
- 复杂的调试流程,使问题追踪变得困难
Scrapeless Cloud Browser 完美地解决了这些痛点:
- 一键绕过反机器人: 自动处理 reCAPTCHA、Cloudflare Turnstile/Challenge、AWS WAF 等。结合 Crawl4AI 强大的结构化提取能力,显著提升成功率。
- 无限并发扩展: 每个任务可在数秒内启动 50–1000+ 个浏览器实例,突破本地爬取性能限制,最大化 Crawl4AI 效率。
- 降低 40%–80% 成本: 与同类云服务相比,总成本降至仅 20%–60%。按量付费的定价即使对于小型项目也经济实惠。
- 可视化调试工具: 使用 Session Replay(会话回放)和 Live URL Monitoring(实时 URL 监控)实时观察 Crawl4AI 任务,快速定位失败原因,减少调试开销。
- 零成本集成: 原生兼容 Crawl4AI 所使用的 Playwright,仅需 一行代码 即可将 Crawl4AI 连接到云端——无需重构代码。
- 边缘节点服务(ENS): 遍布全球的多个节点带来比其他云浏览器 快 2–3 倍 的启动速度和稳定性,加速 Crawl4AI 执行。
- 隔离环境与持久会话: 每个 Scrapeless profile 都运行在独立环境中,具备持久登录和身份隔离,避免会话相互干扰,提升大规模场景下的稳定性。
- 灵活的指纹管理: Scrapeless 可生成随机浏览器指纹或使用自定义配置,有效降低被检测风险,提升 Crawl4AI 的成功率。
快速开始
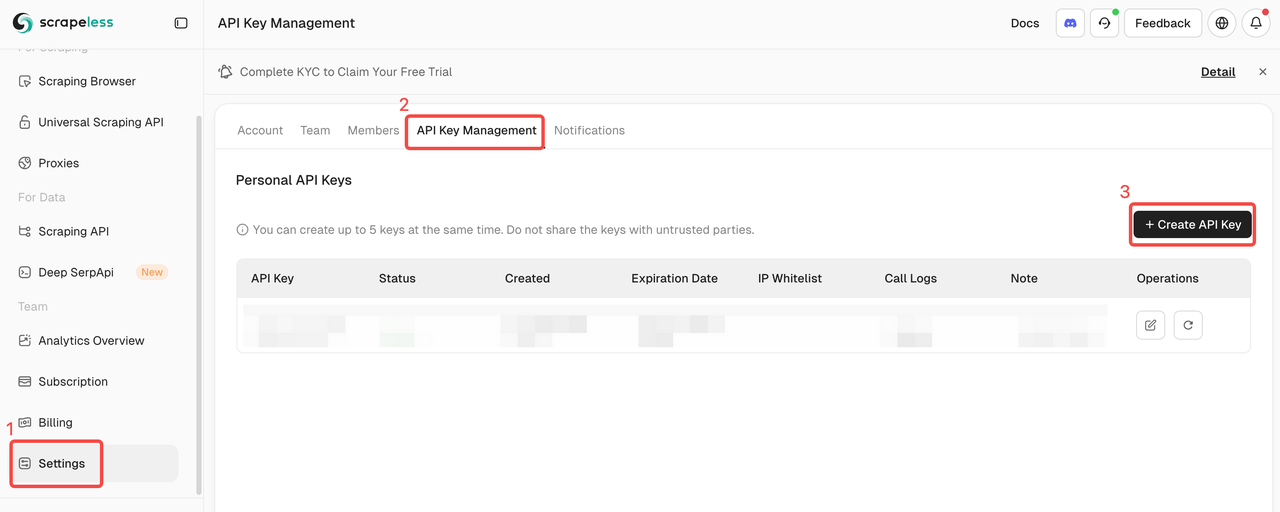
1. 获取你的 Scrapeless API 密钥
登录 Scrapeless 并获取你的 API Token。
2. 快速入门
下面的示例展示了如何快速、便捷地将 Crawl4AI 连接到 Scrapeless Cloud Browser:
有关更多功能和详细说明,请参阅介绍。
scrapeless_params = {
    "token": "get your token from https://www.scrapeless.com",
    "sessionName": "Scrapeless browser",
    "sessionTTL": 1000,
}

query_string = urlencode(scrapeless_params)
scrapeless_connection_url = f"wss://browser.scrapeless.com/api/v2/browser?{query_string}"

AsyncWebCrawler(
    config=BrowserConfig(
        headless=False,
        browser_mode="cdp",
        cdp_url=scrapeless_connection_url
    )
)
配置完成后,Crawl4AI 通过 CDP(Chrome DevTools Protocol) 模式连接到 Scrapeless Cloud Browser,无需本地浏览器环境即可进行网页抓取。用户还可以进一步配置 代理、指纹、会话复用 等功能,以满足高并发和复杂反机器人场景的需求。
3. 全球自动代理轮换
Scrapeless 支持覆盖 195 个国家/地区 的住宅 IP。用户可以使用 proxycountry 配置目标区域,使请求从特定位置发出。IP 会自动轮换,有效避免被封锁。
import asyncio
from urllib.parse import urlencode
from crawl4ai import CrawlerRunConfig, BrowserConfig, AsyncWebCrawler

async def main():
    scrapeless_params = {
        "token": "your token",
        "sessionTTL": 1000,
        "sessionName": "Proxy Demo",
# Sets the target country/region for the proxy, sending requests via an IP address from that region. You can specify a country code (e.g., US for the United States, GB for the United Kingdom, ANY for any country). See country codes for all supported options."proxyCountry": "ANY",
    }
    query_string = urlencode(scrapeless_params)
    scrapeless_connection_url = f"wss://browser.scrapeless.com/api/v2/browser?{query_string}"async with AsyncWebCrawler(
        config=BrowserConfig(
            headless=False,
            browser_mode="cdp",
            cdp_url=scrapeless_connection_url,
        )
    ) as crawler:
        result = await crawler.arun(
            url="https://www.scrapeless.com/en",
            config=CrawlerRunConfig(
                wait_for="css:.content",
                scan_full_page=True,
            ),
        )
        print("-" * 20)
        print(f'Status Code: {result.status_code}')
        print("-" * 20)
        print(f'Title: {result.metadata["title"]}')
        print(f'Description: {result.metadata["description"]}')
        print("-" * 20)
asyncio.run(main())
4. 自定义浏览器指纹
为了模拟真实用户行为,Scrapeless 支持 随机生成浏览器指纹,同时也允许 自定义指纹参数。这能有效降低被目标网站检测的风险。
import json
import asyncio
from urllib.parse import quote, urlencode
from crawl4ai import CrawlerRunConfig, BrowserConfig, AsyncWebCrawler

async def main():
# customize browser fingerprint
    fingerprint = {
        "userAgent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/134.1.2.3 Safari/537.36",
        "platform": "Windows",
        "screen": {
            "width": 1280, "height": 1024
        },
        "localization": {
            "languages": ["zh-HK", "en-US", "en"], "timezone": "Asia/Hong_Kong",
        }
    }

    fingerprint_json = json.dumps(fingerprint)
    encoded_fingerprint = quote(fingerprint_json)

    scrapeless_params = {
        "token": "your token",
        "sessionTTL": 1000,
        "sessionName": "Fingerprint Demo",
        "fingerprint": encoded_fingerprint,
    }
    query_string = urlencode(scrapeless_params)
    scrapeless_connection_url = f"wss://browser.scrapeless.com/api/v2/browser?{query_string}"async with AsyncWebCrawler(
        config=BrowserConfig(
            headless=False,
            browser_mode="cdp",
            cdp_url=scrapeless_connection_url,
        )
    ) as crawler:
        result = await crawler.arun(
            url="https://www.scrapeless.com/en",
            config=CrawlerRunConfig(
                wait_for="css:.content",
                scan_full_page=True,
            ),
        )
        print("-" * 20)
        print(f'Status Code: {result.status_code}')
        print("-" * 20)
        print(f'Title: {result.metadata["title"]}')
        print(f'Description: {result.metadata["description"]}')
        print("-" * 20)
asyncio.run(main())
5. Profile 复用
Scrapeless 为每个 profile 分配 独立的浏览器环境,实现 持久登录和身份隔离。用户只需提供 profileId 即可复用之前的会话。
import asyncio
from urllib.parse import urlencode
from crawl4ai import CrawlerRunConfig, BrowserConfig, AsyncWebCrawler

async def main():
    scrapeless_params = {
        "token": "your token",
        "sessionTTL": 1000,
        "sessionName": "Profile Demo",
        "profileId": "your profileId",# create profile on scrapeless
    }
    query_string = urlencode(scrapeless_params)
    scrapeless_connection_url = f"wss://browser.scrapeless.com/api/v2/browser?{query_string}"async with AsyncWebCrawler(
        config=BrowserConfig(
            headless=False,
            browser_mode="cdp",
            cdp_url=scrapeless_connection_url,
        )
    ) as crawler:
        result = await crawler.arun(
            url="https://www.scrapeless.com",
            config=CrawlerRunConfig(
                wait_for="css:.content",
                scan_full_page=True,
            ),
        )
        print("-" * 20)
        print(f'Status Code: {result.status_code}')
        print("-" * 20)
        print(f'Title: {result.metadata["title"]}')
        print(f'Description: {result.metadata["description"]}')
        print("-" * 20)
asyncio.run(main())