वेब स्क्रैपिंग में Cloudflare बायपास
Agent Browser और Cloudflare
यह तकनीकी दस्तावेज़ बताता है कि Cloudflare द्वारा सेट की गई विभिन्न सुरक्षा चुनौतियों को संभालने के लिए Scrapeless Agent Browser और Scrapeless Web Unlocker टूल का उपयोग कैसे करें। मुख्य विशेषताओं में Cloudflare JS Challenge, Cloudflare Turnstile को बायपास करना, और Cloudflare द्वारा सुरक्षित कंटेंट तक पहुँचने के लिए JavaScript रेंडरिंग को निष्पादित करना शामिल है। यह दस्तावेज़ संबंधित पृष्ठभूमि ज्ञान, फ़ीचर परिचय, परिचालन चरण, और कोड उदाहरण की व्याख्या प्रदान करेगा।
Cloudflare चुनौतियों और सुरक्षा परतों को समझना
Cloudflare, एक लोकप्रिय वेब सुरक्षा और परफ़ॉर्मेंस सेवा, मुख्य रूप से वेबसाइटों को दुर्भावनापूर्ण या अप्रत्याशित ट्रैफ़िक, जैसे बॉट्स और स्कैनर, से बचाती है। इसके लिए, Cloudflare विभिन्न पहचान और रक्षा तंत्र लागू करता है, जिनमें निम्नलिखित शामिल हैं, लेकिन इन्हीं तक सीमित नहीं हैं:
1. JS चुनौती (JavaScript चुनौती): आगंतुक के ब्राउज़र से यह सत्यापित करने के लिए विशिष्ट JavaScript कोड निष्पादित करने की माँग करता है कि यह मानक कार्यक्षमता वाला एक वैध ब्राउज़र वातावरण है।
2. Turnstile CAPTCHA विकल्प: मानव उपयोगकर्ताओं और बॉट्स के बीच अंतर करने के लिए एक कम दखलंदाज़ी वाला सत्यापन तंत्र।
3. ब्राउज़र फ़िंगरप्रिंटिंग: आगंतुकों की पहचान और ट्रैकिंग करने के लिए ब्राउज़र और डिवाइस की तकनीकी विशेषताओं (जैसे, User-Agent, स्क्रीन रिज़ॉल्यूशन, इंस्टॉल किए गए फ़ॉन्ट, प्लगइन्स) को एकत्रित और विश्लेषित करता है।
4. दर सीमा: ब्रूट-फ़ोर्सिंग या संसाधन दुरुपयोग को रोकने के लिए एक विशिष्ट समय के भीतर एकल स्रोत (जैसे, IP पता) से आने वाले अनुरोधों की संख्या की निगरानी और सीमित करता है।
ये सुरक्षा परतें बुनियादी HTTP अनुरोध लाइब्रेरियों, सरल स्क्रिप्ट्स, या अनुचित रूप से कॉन्फ़िगर किए गए हेडलेस ब्राउज़रों को Cloudflare-संरक्षित वेबसाइटों तक पहुँचने से रोकती हैं, जिसके परिणामस्वरूप सत्यापन विफलताएँ और पहुँच अस्वीकृति होती है।
Cloudflare JS Challenge और अन्य चुनौतियों के बीच अंतर
Cloudflare JS Challenge की विशिष्टता इसकी सत्यापन विधि में निहित है। यह केवल उपयोगकर्ताओं से एक सरल इंटरैक्टिव कार्य (जैसे, छवि पहचान) पूरा करने की माँग नहीं करता; यह माँग करता है कि क्लाइंट वातावरण (ब्राउज़र) Cloudflare से गतिशील रूप से जनरेट किए गए, अक्सर अस्पष्ट (obfuscated), JavaScript कोड को सफलतापूर्वक पार्स और निष्पादित करे। यह कोड एक वास्तविक ब्राउज़र की नकल करते हुए, क्लाइंट की जटिल व्यवहार क्षमताओं को सत्यापित करने के लिए वातावरण जाँच, गणना-गहन कार्य, या अन्य लॉजिक निष्पादित करता है।
JS Challenge को सफलतापूर्वक पार करने में एक वैध क्लीयरेंस टोकन जनरेट करना शामिल है (आमतौर पर cf_clearance कुकी के रूप में)। यह टोकन साबित करता है कि क्लाइंट ने JavaScript निष्पादन क्षमता सत्यापन पास किया। कई ऑटोमेशन टूल में एक संपूर्ण JavaScript निष्पादन इंजन और यथार्थवादी ब्राउज़र वातावरण सिमुलेशन की कमी होती है, इसलिए वे ऐसी चुनौतियों में विफल हो जाते हैं।
Scrapeless Agent Browser का उपयोग करके Cloudflare JS Challenge को बायपास करना
Scrapeless Agent Browser को जटिल वेबसाइट सुरक्षा उपायों, जिसमें Cloudflare JS Challenge शामिल है, को संभालने के लिए डिज़ाइन किया गया है।
चरण और कोड उदाहरण
वातावरण सेटअप
एक प्रोजेक्ट फ़ोल्डर बनाएँ
प्रोजेक्ट के लिए एक नया फ़ोल्डर बनाएँ, उदाहरण के लिए: scrapeless-bypass।
अपने टर्मिनल में फ़ोल्डर पर नेविगेट करें:
cd path/to/scrapeless-bypassNode.js प्रोजेक्ट को इनिशियलाइज़ करें
एक package.json फ़ाइल बनाने के लिए निम्नलिखित कमांड चलाएँ:
npm init -yआवश्यक निर्भरताएँ इंस्टॉल करें
Puppeteer-core इंस्टॉल करें, जो ब्राउज़र इंस्टेंस से रिमोट कनेक्शन की अनुमति देता है:
npm install puppeteer-coreयदि Puppeteer पहले से आपके सिस्टम पर इंस्टॉल नहीं है, तो पूर्ण संस्करण इंस्टॉल करें:
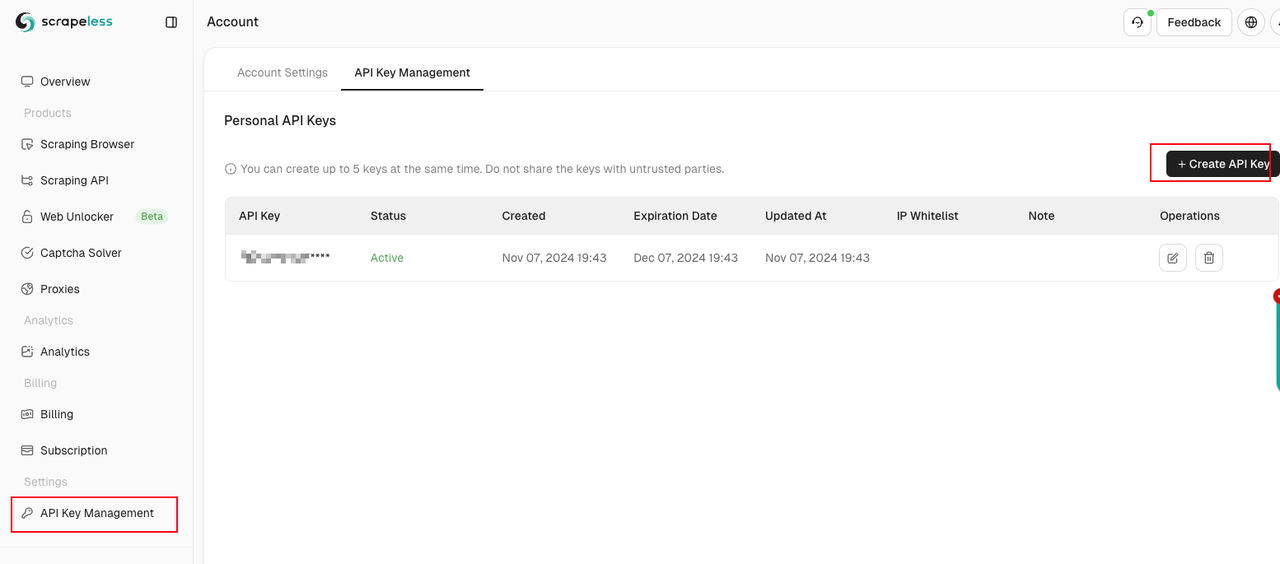
npm install puppeteer puppeteer-coreअपनी Scrapeless API Key प्राप्त करें और कॉन्फ़िगर करें।
कनेक्ट करें और सुनिश्चित करें कि CAPTCHA सफलतापूर्वक हल हो गया है
लक्ष्य वेबसाइट तक पहुँचने के लिए ब्राउज़र से कनेक्ट करते समय Scrapeless स्वतः ही CAPTCHA का पता लगाता है और उन्हें हल करता है। हालाँकि, हमें यह सुनिश्चित करने की आवश्यकता है कि CAPTCHA सफलतापूर्वक हल हो गया है। Scrapeless Agent Browser मानक CDP (Chrome DevTools Protocol) को कस्टम क्षमताओं के एक शक्तिशाली सेट के साथ विस्तारित करता है। CDP API से लौटाए गए परिणामों की जाँच करके CAPTCHA सॉल्वर की स्थिति को सीधे देखा जा सकता है:
Captcha.detected: CAPTCHA का पता चलाCaptcha.solveFinished: CAPTCHA सफलतापूर्वक हल हुआCaptcha.solveFailed: CAPTCHA हल करना विफल हुआ
import puppeteer from "puppeteer-core";
import EventEmitter from 'events';
import { Scrapeless } from '@scrapeless-ai/sdk';

const emitter = new EventEmitter();

const client = new Scrapeless({ apiKey: 'API Key' });

const { browserWSEndpoint } = client.browser.create({
    sessionName: 'sdk_test',
    sessionTTL: 180,
    proxyCountry: 'ANY',
    sessionRecording: true,
    fingerprint,
});

export async function example(url) {
  const browser = await puppeteer.connect({
    browserWSEndpoint,
    defaultViewport: null
  });
  console.log("Verbonden met Scrapeless browser");
  try {
    const page = await browser.newPage();
    // Listen for captcha events
    console.debug("addCaptchaListener: Start listening for captcha events");
    await addCaptchaListener(page);
    console.log("Navigated to URL:", url);
    await page.goto(url, { waitUntil: "domcontentloaded", timeout: 30000 });
    console.log("onCaptchaFinished: Waiting for captcha solving to finish...");
    await onCaptchaFinished()
    // Screenshot for debugging
    console.debug("Taking screenshot of the final page...");
    await page.screenshot({ path: 'screenshot.png', fullPage: true });
  } catch (error) {
    console.error(error);
  } finally {
    await browser.close();
    console.log("Browser closed");
  }
}

async function addCaptchaListener(page) {
  const client = await page.createCDPSession();
  client.on("Captcha.detected", (msg) => {
    console.debug("Captcha.detected: ", msg);
  });
  client.on("Captcha.solveFinished", async (msg) => {
    console.debug("Captcha.solveFinished: ", msg);
    emitter.emit("Captcha.solveFinished", msg);
    client.removeAllListeners()
  });
}

async function onCaptchaFinished(timeout = 60_000) {
  return Promise.race([
    new Promise((resolve) => {
      emitter.on("Captcha.solveFinished", (msg) => {
        resolve(msg);
      });
    }),
    new Promise((_, reject) => setTimeout(() => reject('Timeout'), timeout))
  ])
}यह उदाहरण वर्कफ़्लो लक्ष्य वेबसाइट तक पहुँचता है और Captcha.solveFinished CDP इवेंट को सुनकर पुष्टि करता है कि CAPTCHA सफलतापूर्वक हल हो गया है। अंत में, यह सत्यापन के लिए पेज का स्क्रीनशॉट कैप्चर करता है।
यह उदाहरण दो मुख्य विधियाँ परिभाषित करता है:
addCaptchaListener: ब्राउज़र सत्र के भीतर CAPTCHA इवेंट सुनने के लिएonCaptchaFinished: CAPTCHA के हल हो जाने तक प्रतीक्षा करने के लिए
उपरोक्त उदाहरण कोड का उपयोग इस लेख में चर्चा किए गए तीन सामान्य CAPTCHA प्रकारों के लिए CDP इवेंट सुनने के लिए किया जा सकता है: reCAPTCHA v2, Cloudflare Turnstile, और Cloudflare 5s Challenge।
ध्यान दें कि Cloudflare 5s Challenge कुछ हद तक विशेष है। कभी-कभी यह एक वास्तविक चुनौती को ट्रिगर नहीं करता, और सफलता के लिए केवल CDP इवेंट पहचान पर निर्भर रहने से टाइमआउट हो सकता है। इसलिए, चुनौती के बाद पेज पर किसी विशिष्ट एलिमेंट के प्रकट होने की प्रतीक्षा करना एक अधिक स्थिर समाधान है।
Scrapeless Browserless WebSocket से कनेक्ट करना
Scrapeless एक WebSocket कनेक्शन प्रदान करता है, जो Puppeteer को हेडलेस ब्राउज़र के साथ सीधे इंटरैक्ट करने की अनुमति देता है, Cloudflare चुनौतियों को बायपास करते हुए।
पूर्ण WebSocket कनेक्शन पता:
wss://browser.scrapeless.com/api/v2/browser?token=APIKey&sessionTTL=180&proxyCountry=ANYकोड उदाहरण: Cloudflare चुनौती को बायपास करना
Scrapeless की browserless सेवा से कनेक्ट करने के लिए हमें केवल निम्नलिखित कोड की आवश्यकता है।
import puppeteer from 'puppeteer-core';

const API_KEY = 'your_api_key'
const host = 'wss://browser.scrapeless.com/api/v2';
const query = new URLSearchParams({
  token: API_KEY,
  sessionTTL: '180', // The life cycle of a browser session, in seconds
  proxyCountry: 'GB', // Agent country
  proxySessionId: 'test_session_id', // The proxy session id is used to keep the proxy ip unchanged. The session time is 3 minutes by default, based on the proxySessionDuration setting.
  proxySessionDuration: '5' // Agent session time, unit minutes
}).toString();

const connectionURL = `${host}/browser?${query}`;
const browser = await puppeteer.connect({
    browserWSEndpoint: connectionURL,
    defaultViewport: null,
});
console.log('Connected!')
Cloudflare-संरक्षित वेबसाइटों तक पहुँच और स्क्रीनशॉट सत्यापन
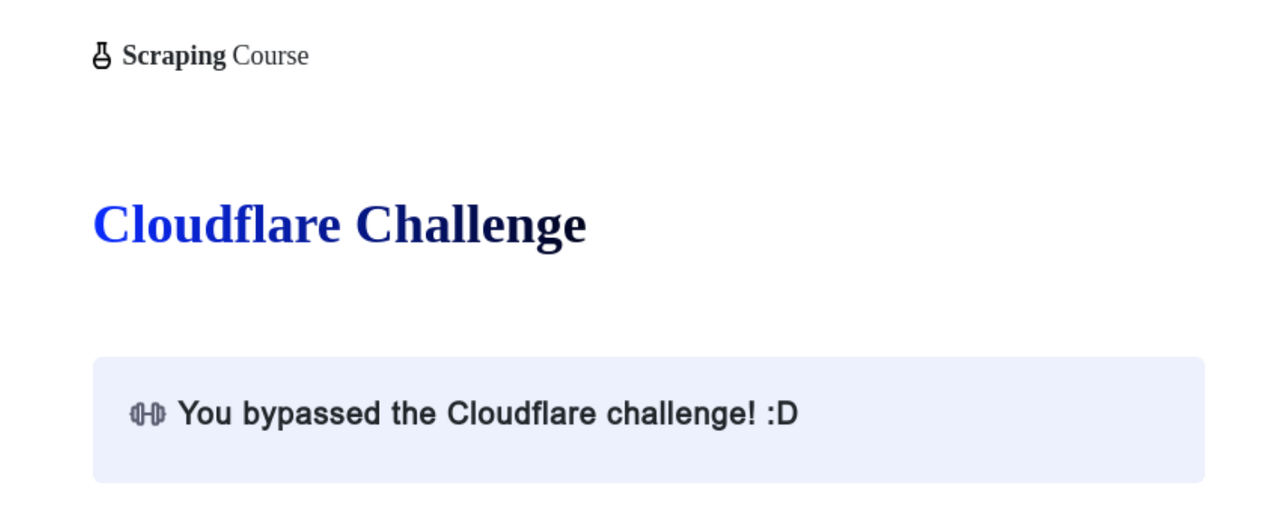
इसके बाद, हम scrapeless browserless का उपयोग करके सीधे cloudflare-challenge टेस्ट साइट तक पहुँचते हैं और एक स्क्रीनशॉट जोड़ते हैं, जिससे दृश्य सत्यापन की अनुमति मिलती है। स्क्रीनशॉट लेने से पहले, ध्यान दें कि आपको पेज पर एलिमेंट की प्रतीक्षा करने के लिए waitForSelector का उपयोग करना होगा, यह सुनिश्चित करते हुए कि Cloudflare चुनौती सफलतापूर्वक बायपास हो गई है।
const page = await browser.newPage();
await page.goto('https://www.scrapingcourse.com/cloudflare-challenge', {waitUntil: 'domcontentloaded'});
// By waiting for elements in the site page, ensuring that the Cloudflare challenge has been successfully bypassed.
await page.waitForSelector('main.page-content .challenge-info', {timeout: 30 * 1000})
await page.screenshot({path: 'challenge-bypass.png'});
इस बिंदु पर, आपने Scrapeless Browserless का उपयोग करके Cloudflare चुनौती को बायपास कर लिया है।
cf_clearance कुकी और Header प्राप्त करना
Cloudflare चुनौती पास करने के बाद, आप सफल पेज से अनुरोध हेडर और cf_clearance कुकी प्राप्त कर सकते हैं।
const cookies = await browser.cookies()
const cfClearance = cookies.find(cookie => cookie.name === 'cf_clearance')?.value
Cloudflare चुनौती के बाद अनुरोध हेडर कैप्चर करने और पेज अनुरोधों का मिलान करने के लिए अनुरोध इंटरसेप्शन सक्षम करें।
await page.setRequestInterception(true);
page.on('request', request => {
  // Match page requests after cloudflare challenge
  if (request.url().includes('https://www.scrapingcourse.com/cloudflare-challenge') && request.headers()?.['origin']) {
    const accessRequestHeaders = request.headers();
    console.log('[access_request_headers] =>', accessRequestHeaders);
  }
  request.continue();
});
Scrapeless Agent Browser का उपयोग करके Cloudflare Turnstile को बायपास करना
Scrapeless Agent Browser Cloudflare Turnstile चुनौतियों को भी संभालता है।
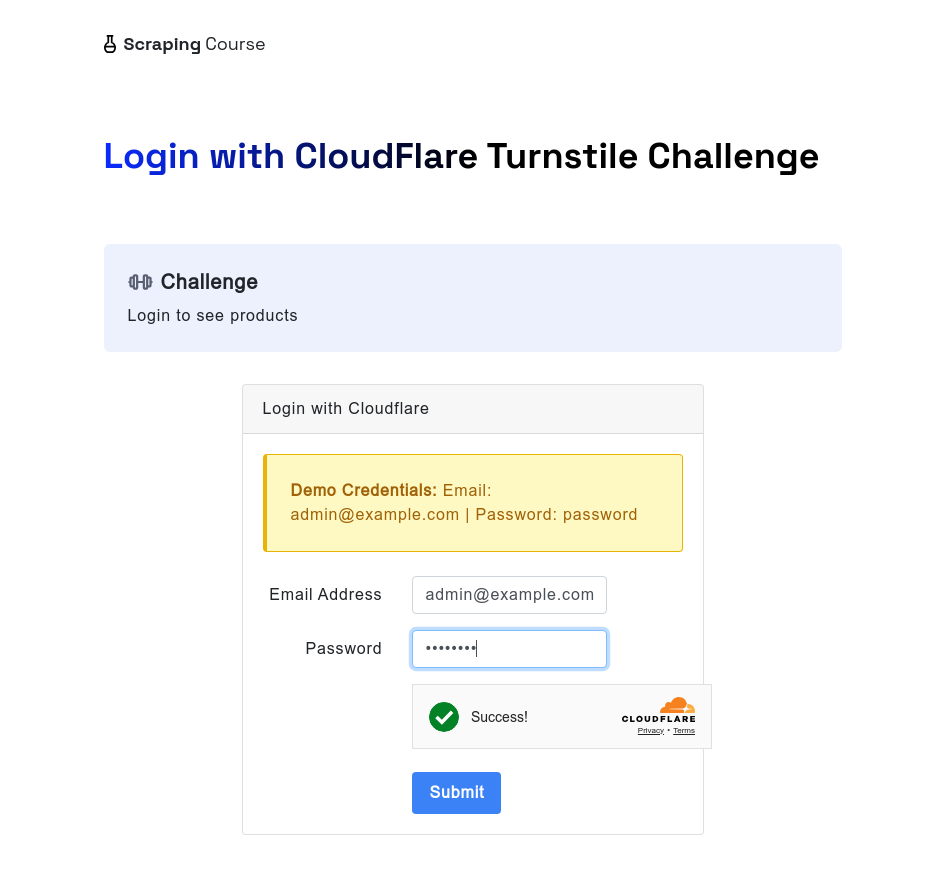
इसी तरह, Cloudflare Turnstile के सामने आने पर, ब्राउज़रलेस स्क्रैपिंग ब्राउज़र इसे अभी भी स्वचालित रूप से संभाल सकता है। निम्न उदाहरण cloudflare-turnstile परीक्षण साइट तक पहुँचता है। उपयोगकर्ता नाम और कूटशब्द दर्ज करने के बाद, यह चुनौती को सफलतापूर्वक बायपास करना सुनिश्चित करने के लिए waitForFunction विधि का उपयोग करके window.turnstile.getResponse() से डेटा के लिए प्रतीक्षा करता है। फिर, यह एक स्क्रीनशॉट लेता है और अगले पृष्ठ पर जाने के लिए लॉगिन बटन पर क्लिक करता है।
चरण और कोड उदाहरण:
const page = await browser.newPage();
await page.goto('https://www.scrapingcourse.com/login/cf-turnstile', { waitUntil: 'domcontentloaded' });
await page.locator('input[type="email"]').fill('admin@example.com')
await page.locator('input[type="password"]').fill('password')
// Wait for turnstile to unlock successfully
await page.waitForFunction(() => {
  return window.turnstile && window.turnstile.getResponse();
});
await page.screenshot({ path: 'challenge-bypass-success.png' });
await page.locator('button[type="submit"]').click()
await page.waitForNavigation()
await page.screenshot({ path: 'next-page.png' });
इस स्क्रिप्ट को चलाने के बाद, आप स्क्रीनशॉट के माध्यम से अनलॉकिंग प्रभाव देखेंगे।
JavaScript रेंडरिंग के लिए Scrapeless Web Unlocker का उपयोग करना
Cloudflare द्वारा संरक्षित उन वेबसाइटों के लिए जहाँ कोर कंटेंट पूर्ण लोडिंग और प्रदर्शन के लिए क्लाइंट-साइड JavaScript निष्पादन पर निर्भर करता है, Scrapeless Web Unlocker एक समर्पित समाधान प्रदान करता है।
Scrapeless Universal API, JavaScript रेंडरिंग और गतिशील इंटरैक्शन को सक्षम करता है, जो इसे Cloudflare को बायपास करने के लिए एक प्रभावी टूल बनाता है।
JavaScript रेंडरिंग
JavaScript रेंडरिंग गतिशील रूप से लोड किए गए कंटेंट और SPAs (Single-Page Applications) को संभालने का समर्थन करता है। यह एक संपूर्ण ब्राउज़र वातावरण का समर्थन करता है, अधिक जटिल पेज इंटरैक्शन और रेंडरिंग आवश्यकताओं को संभालता है।
input.jsRender.enabled=true के साथ, हम अनुरोध के लिए ब्राउज़र का उपयोग करेंगे
{
  "actor": "unlocker.webunlocker",
  "input": {
    "url": "https://www.google.com/",
    "jsRender": {
      "enabled": true
    }
  },
  "proxy": {
    "country": "US"
  }
}
JavaScript निर्देश
JavaScript निर्देशों का एक व्यापक सेट प्रदान करता है, जो वेब पेजों के साथ गतिशील इंटरैक्शन की अनुमति देता है।
ये निर्देश एलिमेंट पर क्लिक करने, फ़ॉर्म भरने, फ़ॉर्म सबमिट करने, या विशिष्ट एलिमेंट के प्रकट होने की प्रतीक्षा करने को सक्षम करते हैं, जो “Read More” बटन पर क्लिक करने या फ़ॉर्म सबमिट करने जैसे कार्यों के लिए लचीलापन प्रदान करते हैं।
{
  "actor": "unlocker.webunlocker",
  "input": {
    "url": "https://example.com",
    "jsRender": {
      "enabled": true,
      "instructions": [
        {
          "waitFor": [
            ".dynamic-content",
            30000
          ]
          // Wait for element
        },
        {
          "click": [
            "#load-more",
            1000
          ]
          // Click element
        },
        {
          "fill": [
            "#search-input",
            "search term"
          ]
          // Fill form
        },
        {
          "keyboard": [
            "press",
            "Enter"
          ]
          // Simulate key press
        },
        {
          "evaluate": "window.scrollTo(0, document.body.scrollHeight)"
          // Execute custom JS
        }
      ]
    }
  }
}
चुनौती बायपास उदाहरण
निम्न उदाहरण axios का उपयोग Scrapeless की Web Unlocker सेवा पर अनुरोध भेजने के लिए करता है। यह input.jsRender.enabled को सक्षम करता है और Cloudflare चुनौती को बायपास करने के बाद पृष्ठ पर एक तत्व के लिए प्रतीक्षा करने के लिए waitFor निर्देश का उपयोग input.jsRender.instructions पैरामीटर में करता है:
import axios from 'axios'

async function sendRequest() {
  const host = "api.scrapeless.com";
  const url = `https://${host}/api/v2/unlocker/request`;
  const API_KEY = 'your_api_key'

  const payload = {
    actor: "unlocker.webunlocker",
    proxy: {
      country: "US"
    },
    input: {
      url: "https://www.scrapingcourse.com/cloudflare-challenge",
      jsRender: {
        enabled: true,
        instructions: [
          {
            waitFor: [
              "main.page-content .challenge-info",
              30000
            ]
          }
        ]
      }
    }
  }

  try {
    const response = await axios.post(url, payload, {
      headers: {
        'Content-Type': 'application/json',
        'x-api-token': API_KEY
      }
    });
    console.log("[page_html_body] =>", response.data);
  } catch (error) {
    console.error('Error:', error);
  }
}
sendRequest();
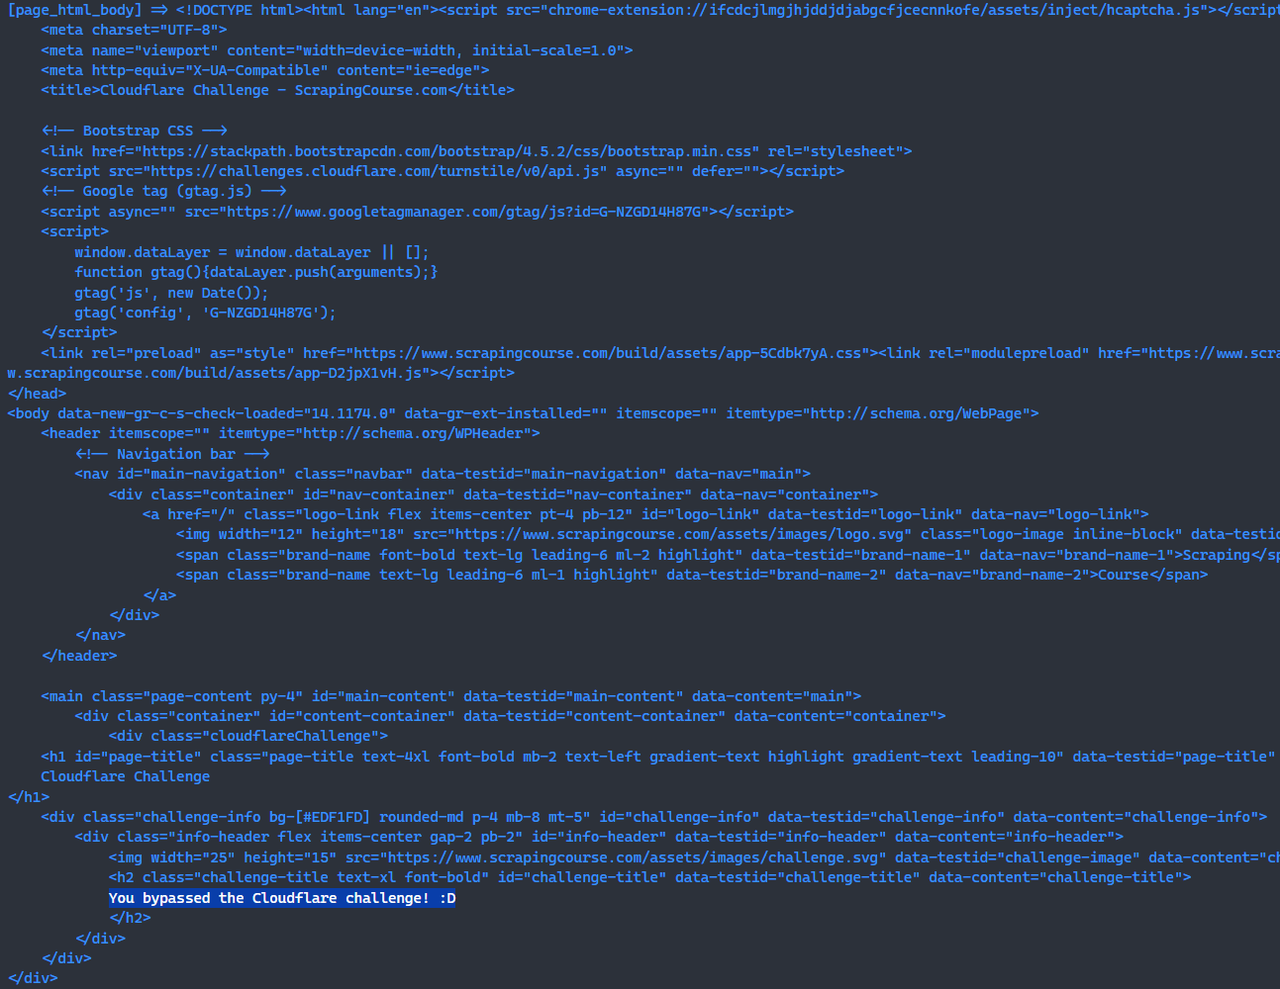
उपरोक्त स्क्रिप्ट को चलाने के बाद, आप कंसोल में उस पेज का HTML देख पाएँगे जिसने Cloudflare चुनौती को सफलतापूर्वक बायपास कर दिया।