अवलोकन
Scrapeless MCP सर्वर Scrapeless के लिए आधिकारिक मॉडल कॉन्टेक्स्ट प्रोटोकॉल एकीकरण है। यह LLMs, AI एजेंट्स और AI-नेटिव उपकरणों — ChatGPT, Claude, Cursor, Windsurf और किसी भी MCP-संगत क्लाइंट को एकल, एकीकृत सर्वर के माध्यम से वेब तक वास्तविक समय में पहुँच प्रदान करता है।
एक सर्वर के साथ आप कर सकते हैं:
- खोजें गूगल SERP, ट्रेंड्स, स्कॉलर, फ्लाइट्स और अधिक
- किसी भी पृष्ठ को HTML, Markdown या स्क्रीनशॉट के रूप में स्क्रैप करें — Cloudflare और अन्य एंटी-बॉट सुरक्षा को बायपास करते हुए
- क्रॉल करें पूरी साइट को कॉन्फ़िगर करने योग्य गहराई और सीमित URL लक्ष्यीकरण के साथ
- स्वचालित करें एक स्केलेबल क्लाउड ब्राउज़र: नेविगेट करें, क्लिक करें, टाइप करें, स्क्रॉल करें और निकालें
Scrapeless MCP क्यों
स्थानीय ब्राउज़र-स्वचालन MCP सर्वर के विपरीत, Scrapeless पूरी तरह से क्लाउड में चलता है, जो डेवलपर्स और AI एजेंट्स को उत्पादन-ग्रेड स्केल और विश्वसनीयता प्रदान करता है:
- शून्य स्थानीय सेटअप — कोई ब्राउज़र बाइनरी, ड्राइवर या हेडलेस कॉन्फ़िगरेशन बनाए रखने की आवश्यकता नहीं।
- असीमित समवर्तीता — ऑटो-स्केलिंग बुनियादी ढांचे के साथ 50–1000+ समानांतर सत्र लॉन्च करें।
- अंतर्निहित एंटी-डिटेक्शन — reCAPTCHA, Cloudflare Turnstile और AWS WAF को स्वचालित रूप से संभाला जाता है।
- वैश्विक IP कवरेज — 195+ देशों में रेज़िडेंशियल, ISP और असीमित पूल।
- एक API टोकन — एकल Scrapeless कुंजी समान सर्वर के माध्यम से प्रत्येक उत्पाद को अनलॉक करती है।
Scrapeless MCP बनाम तृतीय-पक्ष ब्राउज़र MCP
Scrapeless MCP Scrapeless का स्वयं का बहु-उत्पाद सर्वर है। यह तृतीय-पक्ष ब्राउज़र MCP सर्वर से भिन्न है जो पृष्ठभूमि के रूप में Scrapeless क्लाउड ब्राउज़र से जुड़ते हैं:
| MCP सर्वर | टेक स्टैक | सर्वोत्तम उपयोगी है |
|---|---|---|
| Scrapeless MCP | क्लाउड सेवा | किसी भी MCP क्लाइंट से प्रत्येक Scrapeless उत्पाद में खोज, स्क्रैप, क्रॉल और ब्राउज़र स्वचालन। |
| Chrome DevTools MCP | Node.js / Puppeteer | CI/CD स्वचालन, क्रॉस-IDE कार्यप्रवाह और गहन प्रदर्शन ऑडिट। |
| Playwright MCP | Node.js / Playwright | निर्धारक, पहुंच-वृक्ष स्वचालन जो मामूली यूआई परिवर्तनों का प्रतिरोध करता है। |
Chrome DevTools MCP और Playwright MCP एकीकरण हैं जो Scrapeless क्लाउड ब्राउज़र के खिलाफ तृतीय-पक्ष MCP चलाते हैं। यह खंड Scrapeless के स्वयं के MCP सर्वर के बारे में दस्तावेज़ीकरण प्रदान करता है। तृतीय-पक्ष विकल्पों के लिए संबंधित एकीकरण देखें।
इस खंड में क्या है
- त्वरित शुरुआत — दो मिनट से कम समय में एक क्लाइंट को जोड़ें।
- उत्पाद अनुसार उपकरण — ब्राउज़र, क्रॉल, AI Scraper, Web Unlocker, Scraping API और Proxies के अनुसार समूहित पूर्ण उपकरण कैटलॉग।
- प्रमाणीकरण और ट्रांसपोर्ट — API टोकन के साथ-साथ Stdio और Streamable HTTP मोड।
- क्लाइंट सेटअप — क्लॉड, कर्सर, क्लाइन, कोडेक्स, विंडसर्फ और कस्टम क्लाइंट के लिए चरण-दर-चरण मार्गदर्शिका।
- कॉन्फ़िगरेशन — सत्र, प्रोफ़ाइल और व्यवहार विकल्प।
प्रदर्शन
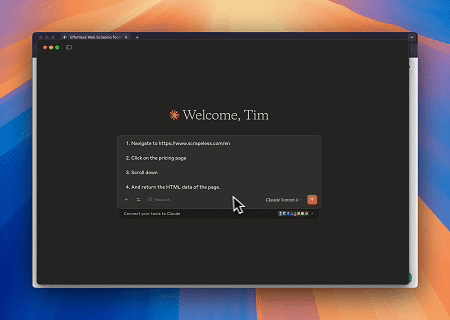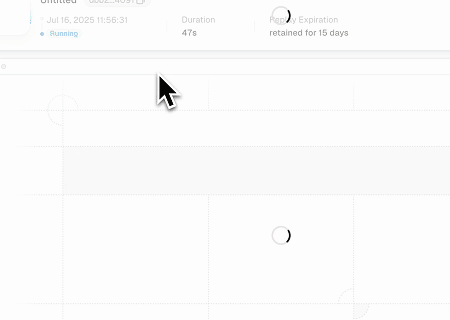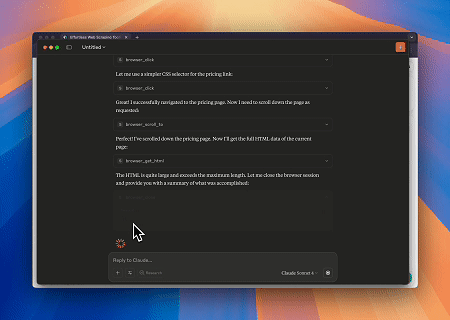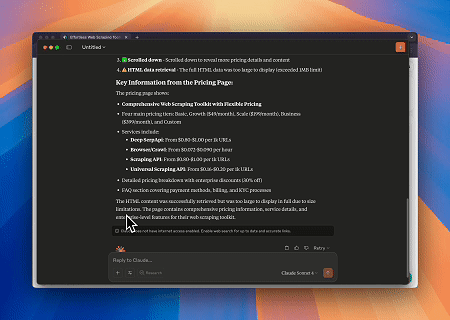
केस 1: क्लॉड के साथ वेब इंटरैक्शन और डेटा निष्कर्षण
Scrapeless MCP सर्वर का उपयोग करके, क्लॉड जटिल वेब ऑपरेशन — नेविगेशन, क्लिकिंग, स्क्रॉलिंग और डेटा स्क्रैपिंग — संवादात्मक कमांड के माध्यम से कर सकता है, जिसकी वास्तविक समय में लाइव सत्र के माध्यम से निष्पादन पूर्वावलोकन उपलब्ध होता है।
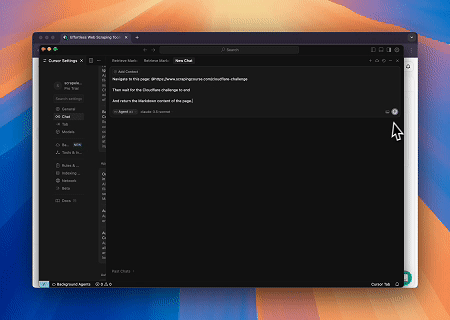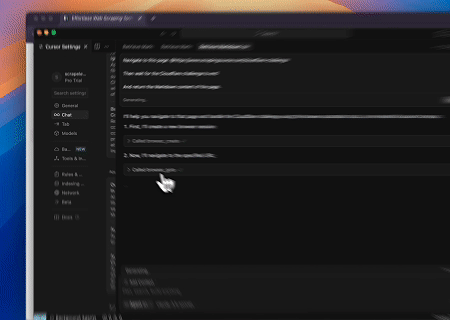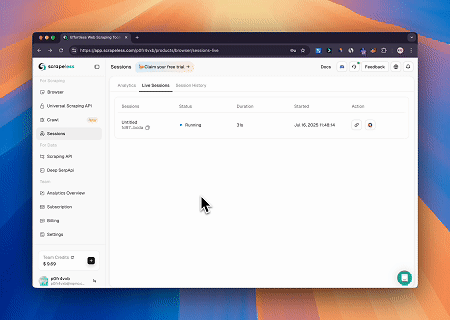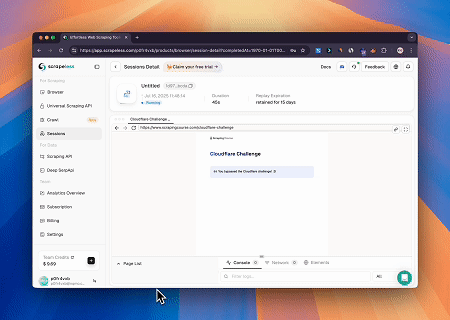
केस 2: लक्ष्य पृष्ठ सामग्री प्राप्त करने के लिए Cloudflare को बायपास करना
Scrapeless MCP सर्वर का उपयोग करके, Cloudflare-सुरक्षित पृष्ठों तक स्वचालित रूप से पहुंचा जाता है, और पूरा होने पर पृष्ठ की सामग्री निकाल ली जाती है और Markdown प्रारूप में लौटा दी जाती है।