Crawl4AI
Crawl4AI は、大規模言語モデル(LLM)、AIエージェント、データパイプラインとシームレスに統合できるよう設計されたオープンソースのウェブクローリングおよびスクレイピングツールです。柔軟性と容易な展開を維持しつつ、高速でリアルタイムのデータ抽出を可能にします。
AI駆動型ウェブスクレイピングの主な機能は以下の通りです:
- LLM向けに構築: Retrieval-Augmented Generation(RAG)やファインチューニングに最適化された構造化されたMarkdownを生成します。
- 柔軟なブラウザ制御: セッション管理、プロキシ使用、カスタムフックをサポートします。
- ヒューリスティックな知能: データ解析を最適化するスマートアルゴリズムを使用します。
- 完全なオープンソース: APIキーは不要で、Dockerやクラウドプラットフォームにデプロイできます。
詳細は 公式ドキュメントでご確認ください。
なぜ Crawl4AI と Scrapeless を併用するのか?
Crawl4AI は構造化されたウェブデータの抽出に優れており、LLM駆動の解析やパターンベースのスクレイピングをサポートしています。しかし、以下のような高度なアンチボット対策に対処する際には依然として課題があります:
- ローカルブラウザが Cloudflare、AWS WAF、または reCAPTCHA によってブロックされる
- 大規模な同時並行クローリング中にパフォーマンスのボトルネックが発生し、ブラウザの起動が遅くなる
- 複雑なデバッグプロセスにより、問題の追跡が困難になる
Scrapeless Cloud Browser はこれらの課題を完璧に解決します:
- ワンクリックでアンチボットバイパス: reCAPTCHA、CloudflareTurnstile/Challenge、AWS WAFなどを自動的に処理します。Crawl4AIの構造化抽出機能と組み合わせることで、成功確率が大幅に向上します。
- 無制限の同時スケーリング: 1つのタスクに対して数秒で50~1000以上のブラウザインスタンスを起動可能。ローカルクローリングのパフォーマンス制限を排除し、Crawl4AIの効率を最大化します。
- 40%~80%のコスト削減: 類似のクラウドサービスと比較して、総コストはわずか20%~60%に低下します。従量課金制のため、小規模プロジェクトでも手頃な価格で利用できます。
- ビジュアルデバッグツール: セッションリプレイ と ライブURLモニタリング を使用して、Crawl4AIタスクをリアルタイムで確認し、失敗の原因をすばやく特定してデバッグのオーバーヘッドを削減できます。
- ゼロコストでの統合: Crawl4AIで使用されている Playwright とネイティブ互換。Crawl4AIをクラウドに接続するには 1行のコード だけで済み、コードのリファクタリングは不要です。
- エッジノードサービス(ENS): 複数のグローバルノードが起動速度と安定性を提供し、他のクラウドブラウザよりも 2~3倍高速 で、Crawl4AIの実行を加速します。
- 分離された環境と永続的なセッション: 各Scrapelessプロファイルは、永続的なログインとアイデンティティ分離を持つ独自の環境で実行され、セッションの干渉を防ぎ、大規模運用時の安定性を向上させます。
- 柔軟なフィンガープリント管理: Scrapelessはランダムなブラウザフィンガープリントを生成したり、カスタム設定を使用したりでき、検出リスクを効果的に低減し、Crawl4AIの成功率を向上させます。
はじめに
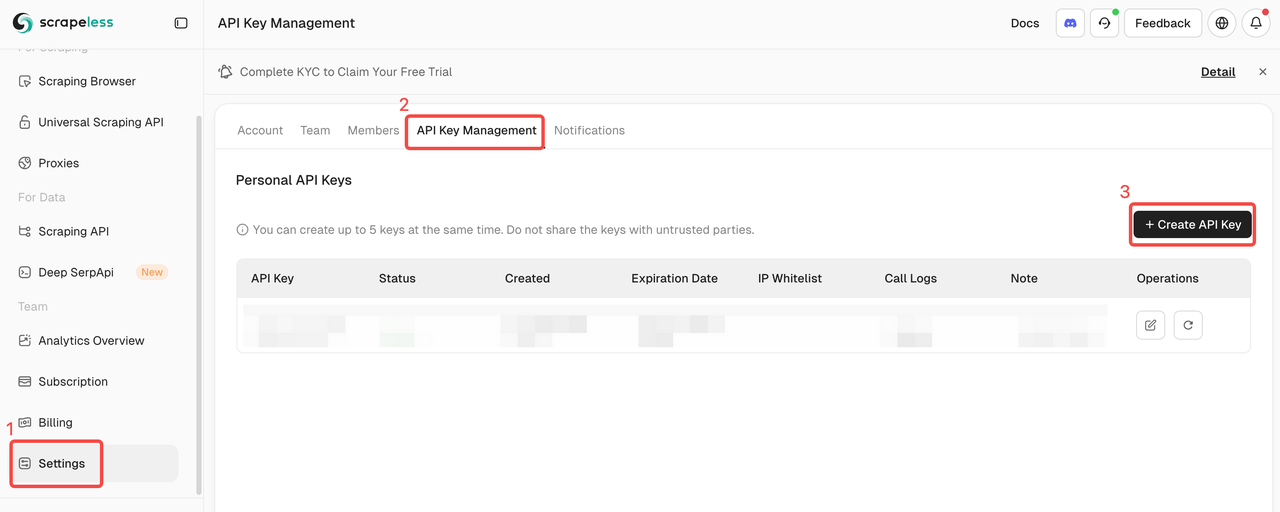
1. ご自身の Scrapeless API キーを取得
Scrapeless にログインして、 APIトークンを取得します。
2. クイックスタート
以下の例は、Crawl4AIを Scrapelessクラウドブラウザに迅速かつ簡単に接続する方法を示しています。
さらに多くの機能や詳細な手順については、 紹介ページをご覧ください。
scrapeless_params = {
    "token": "get your token from https://www.scrapeless.com",
    "sessionName": "Scrapeless browser",
    "sessionTTL": 1000,
}

query_string = urlencode(scrapeless_params)
scrapeless_connection_url = f"wss://browser.scrapeless.com/api/v2/browser?{query_string}"

AsyncWebCrawler(
    config=BrowserConfig(
        headless=False,
        browser_mode="cdp",
        cdp_url=scrapeless_connection_url
    )
)
設定後、Crawl4AIはScrapelessクラウドブラウザに CDP(Chrome DevTools Protocol) モードで接続し、ローカルのブラウザ環境なしでウェブスクレイピングを可能にします。ユーザーはさらに、 プロキシ、フィンガープリント、セッションの再利用などの機能を設定して、高同時接続数や複雑なアンチボット対策のニーズに対応できます。
3. グローバル自動プロキシローテーション
Scrapelessは、 195か国の住宅用IPに対応しています。対象地域は proxycountryで設定でき、特定の地域からリクエストを送信できます。 IPは自動的にローテーションされるため、ブロックを効果的に回避できます。
import asyncio
from urllib.parse import urlencode
from crawl4ai import CrawlerRunConfig, BrowserConfig, AsyncWebCrawler

async def main():
    scrapeless_params = {
        "token": "your token",
        "sessionTTL": 1000,
        "sessionName": "Proxy Demo",
# Sets the target country/region for the proxy, sending requests via an IP address from that region. You can specify a country code (e.g., US for the United States, GB for the United Kingdom, ANY for any country). See country codes for all supported options."proxyCountry": "ANY",
    }
    query_string = urlencode(scrapeless_params)
    scrapeless_connection_url = f"wss://browser.scrapeless.com/api/v2/browser?{query_string}"async with AsyncWebCrawler(
        config=BrowserConfig(
            headless=False,
            browser_mode="cdp",
            cdp_url=scrapeless_connection_url,
        )
    ) as crawler:
        result = await crawler.arun(
            url="https://www.scrapeless.com/en",
            config=CrawlerRunConfig(
                wait_for="css:.content",
                scan_full_page=True,
            ),
        )
        print("-" * 20)
        print(f'Status Code: {result.status_code}')
        print("-" * 20)
        print(f'Title: {result.metadata["title"]}')
        print(f'Description: {result.metadata["description"]}')
        print("-" * 20)
asyncio.run(main())
4. カスタムブラウザフィンガープリント
実際のユーザーの動作を再現するため、Scrapelessは ランダムに生成されたブラウザフィンガープリント に対応し、 フィンガープリントパラメータのカスタマイズも可能です。これにより、対象ウェブサイトに検出されるリスクを効果的に低減できます。
import json
import asyncio
from urllib.parse import quote, urlencode
from crawl4ai import CrawlerRunConfig, BrowserConfig, AsyncWebCrawler

async def main():
# customize browser fingerprint
    fingerprint = {
        "userAgent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/134.1.2.3 Safari/537.36",
        "platform": "Windows",
        "screen": {
            "width": 1280, "height": 1024
        },
        "localization": {
            "languages": ["zh-HK", "en-US", "en"], "timezone": "Asia/Hong_Kong",
        }
    }

    fingerprint_json = json.dumps(fingerprint)
    encoded_fingerprint = quote(fingerprint_json)

    scrapeless_params = {
        "token": "your token",
        "sessionTTL": 1000,
        "sessionName": "Fingerprint Demo",
        "fingerprint": encoded_fingerprint,
    }
    query_string = urlencode(scrapeless_params)
    scrapeless_connection_url = f"wss://browser.scrapeless.com/api/v2/browser?{query_string}"async with AsyncWebCrawler(
        config=BrowserConfig(
            headless=False,
            browser_mode="cdp",
            cdp_url=scrapeless_connection_url,
        )
    ) as crawler:
        result = await crawler.arun(
            url="https://www.scrapeless.com/en",
            config=CrawlerRunConfig(
                wait_for="css:.content",
                scan_full_page=True,
            ),
        )
        print("-" * 20)
        print(f'Status Code: {result.status_code}')
        print("-" * 20)
        print(f'Title: {result.metadata["title"]}')
        print(f'Description: {result.metadata["description"]}')
        print("-" * 20)
asyncio.run(main())
5. プロファイルの再利用
Scrapelessは各プロファイルに 独立したブラウザ環境を割り当て、 ログイン状態の永続化とIDの分離を実現します。ユーザーは profileId を指定するだけで、以前のセッションを再利用できます。
import asyncio
from urllib.parse import urlencode
from crawl4ai import CrawlerRunConfig, BrowserConfig, AsyncWebCrawler

async def main():
    scrapeless_params = {
        "token": "your token",
        "sessionTTL": 1000,
        "sessionName": "Profile Demo",
        "profileId": "your profileId",# create profile on scrapeless
    }
    query_string = urlencode(scrapeless_params)
    scrapeless_connection_url = f"wss://browser.scrapeless.com/api/v2/browser?{query_string}"async with AsyncWebCrawler(
        config=BrowserConfig(
            headless=False,
            browser_mode="cdp",
            cdp_url=scrapeless_connection_url,
        )
    ) as crawler:
        result = await crawler.arun(
            url="https://www.scrapeless.com",
            config=CrawlerRunConfig(
                wait_for="css:.content",
                scan_full_page=True,
            ),
        )
        print("-" * 20)
        print(f'Status Code: {result.status_code}')
        print("-" * 20)
        print(f'Title: {result.metadata["title"]}')
        print(f'Description: {result.metadata["description"]}')
        print("-" * 20)
asyncio.run(main())