Crawl4AI
Crawl4AI là một công cụ thu thập và trích xuất dữ liệu web mã nguồn mở được thiết kế để tích hợp liền mạch với các Mô hình Ngôn ngữ Lớn (LLM), AI Agent và các pipeline dữ liệu. Nó cho phép trích xuất dữ liệu tốc độ cao, theo thời gian thực, đồng thời vẫn linh hoạt và dễ triển khai.
Các tính năng chính cho việc thu thập dữ liệu web bằng AI bao gồm:
- Được xây dựng cho LLM: Tạo ra Markdown có cấu trúc được tối ưu hóa cho Retrieval-Augmented Generation (RAG) và tinh chỉnh mô hình.
- Kiểm soát trình duyệt linh hoạt: Hỗ trợ quản lý phiên, sử dụng proxy và các hook tùy chỉnh.
- Trí tuệ heuristic: Sử dụng các thuật toán thông minh để tối ưu hóa việc phân tích dữ liệu.
- Hoàn toàn mã nguồn mở: Không yêu cầu API key; có thể triển khai qua Docker và các nền tảng đám mây.
Tìm hiểu thêm trong tài liệu chính thức.
Tại sao nên dùng Scrapeless với Crawl4AI?
Crawl4AI vượt trội trong việc trích xuất dữ liệu web có cấu trúc và hỗ trợ phân tích cú pháp do LLM điều khiển cũng như thu thập dữ liệu theo mẫu. Tuy nhiên, nó vẫn có thể gặp thách thức khi đối mặt với các cơ chế chống bot nâng cao, chẳng hạn như:
- Trình duyệt cục bộ bị chặn bởi Cloudflare, AWS WAF hoặc reCAPTCHA
- Nút thắt cổ chai về hiệu suất trong quá trình thu thập đồng thời quy mô lớn, với việc khởi động trình duyệt chậm
- Quy trình gỡ lỗi phức tạp khiến việc theo dõi sự cố trở nên khó khăn
Scrapeless Cloud Browser giải quyết những điểm khó khăn này một cách hoàn hảo:
- Vượt qua chống bot chỉ với một cú nhấp: Tự động xử lý reCAPTCHA, Cloudflare Turnstile/Challenge, AWS WAF, và nhiều hơn nữa. Kết hợp với sức mạnh trích xuất có cấu trúc của Crawl4AI, nó nâng cao đáng kể tỷ lệ thành công.
- Mở rộng đồng thời không giới hạn: Khởi chạy 50–1000+ instance trình duyệt cho mỗi tác vụ trong vòng vài giây, loại bỏ giới hạn hiệu suất thu thập dữ liệu cục bộ và tối đa hóa hiệu quả của Crawl4AI.
- Giảm 40%–80% chi phí: So với các dịch vụ đám mây tương tự, tổng chi phí giảm xuống chỉ còn 20%–60%. Định giá trả theo mức sử dụng khiến nó có giá phải chăng ngay cả đối với các dự án quy mô nhỏ.
- Công cụ gỡ lỗi trực quan: Sử dụng Session Replay và Live URL Monitoring để theo dõi các tác vụ Crawl4AI theo thời gian thực, nhanh chóng xác định nguyên nhân thất bại và giảm chi phí gỡ lỗi.
- Tích hợp không tốn chi phí: Tương thích nguyên bản với Playwright (được Crawl4AI sử dụng), chỉ cần một dòng mã để kết nối Crawl4AI với đám mây — không cần tái cấu trúc mã.
- Edge Node Service (ENS): Nhiều nút toàn cầu mang lại tốc độ khởi động và độ ổn định nhanh gấp 2–3 lần so với các trình duyệt đám mây khác, tăng tốc quá trình thực thi Crawl4AI.
- Môi trường cô lập & phiên bền vững: Mỗi profile Scrapeless chạy trong môi trường riêng của nó với đăng nhập bền vững và cô lập danh tính, ngăn chặn sự can thiệp giữa các phiên và cải thiện độ ổn định ở quy mô lớn.
- Quản lý dấu vân tay linh hoạt: Scrapeless có thể tạo dấu vân tay trình duyệt ngẫu nhiên hoặc sử dụng cấu hình tùy chỉnh, giảm hiệu quả rủi ro bị phát hiện và cải thiện tỷ lệ thành công của Crawl4AI.
Bắt đầu
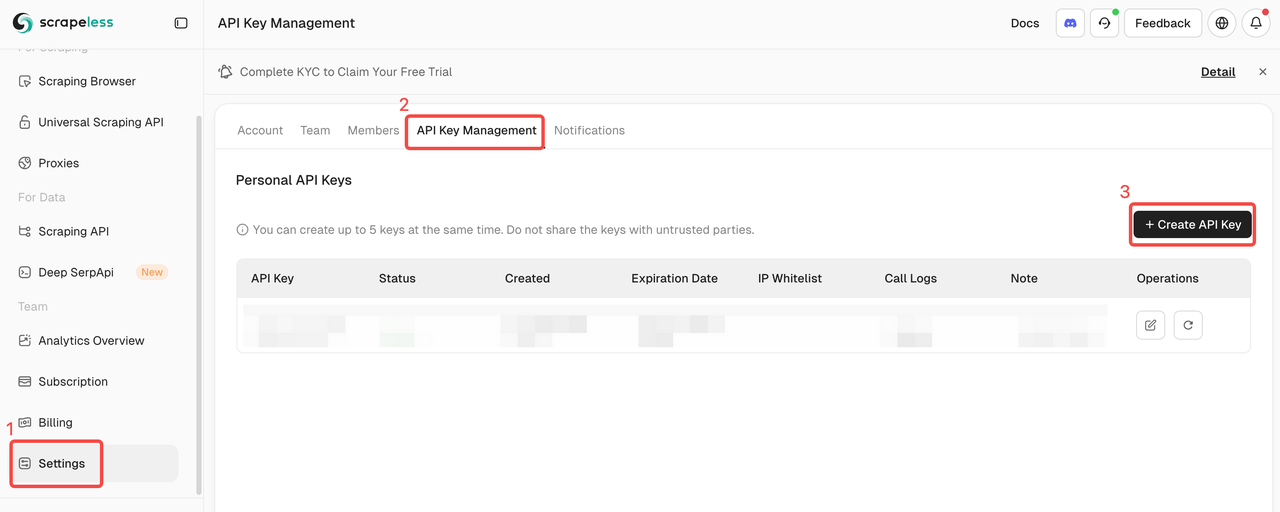
1. Lấy Scrapeless API Key của bạn
Đăng nhập vào Scrapeless và lấy API Token của bạn.
2. Bắt đầu nhanh
Ví dụ bên dưới cho thấy cách kết nối Crawl4AI với Scrapeless Cloud Browser một cách nhanh chóng và dễ dàng:
Để biết thêm tính năng và hướng dẫn chi tiết, hãy xem phần giới thiệu.
scrapeless_params = {
    "token": "get your token from https://www.scrapeless.com",
    "sessionName": "Scrapeless browser",
    "sessionTTL": 1000,
}

query_string = urlencode(scrapeless_params)
scrapeless_connection_url = f"wss://browser.scrapeless.com/api/v2/browser?{query_string}"

AsyncWebCrawler(
    config=BrowserConfig(
        headless=False,
        browser_mode="cdp",
        cdp_url=scrapeless_connection_url
    )
)
Sau khi cấu hình, Crawl4AI kết nối với Scrapeless Cloud Browser thông qua chế độ CDP (Chrome DevTools Protocol), cho phép thu thập dữ liệu web mà không cần môi trường trình duyệt cục bộ. Người dùng có thể cấu hình thêm proxy, dấu vân tay, tái sử dụng phiên, và các tính năng khác để đáp ứng nhu cầu của các kịch bản đồng thời cao và chống bot phức tạp.
3. Tự động xoay vòng proxy toàn cầu
Scrapeless hỗ trợ IP dân cư trên 195 quốc gia. Người dùng có thể cấu hình khu vực mục tiêu bằng cách sử dụng proxycountry, cho phép gửi các yêu cầu từ những vị trí cụ thể. IP được tự động xoay vòng, giúp tránh bị chặn một cách hiệu quả.
import asyncio
from urllib.parse import urlencode
from crawl4ai import CrawlerRunConfig, BrowserConfig, AsyncWebCrawler

async def main():
    scrapeless_params = {
        "token": "your token",
        "sessionTTL": 1000,
        "sessionName": "Proxy Demo",
# Sets the target country/region for the proxy, sending requests via an IP address from that region. You can specify a country code (e.g., US for the United States, GB for the United Kingdom, ANY for any country). See country codes for all supported options."proxyCountry": "ANY",
    }
    query_string = urlencode(scrapeless_params)
    scrapeless_connection_url = f"wss://browser.scrapeless.com/api/v2/browser?{query_string}"async with AsyncWebCrawler(
        config=BrowserConfig(
            headless=False,
            browser_mode="cdp",
            cdp_url=scrapeless_connection_url,
        )
    ) as crawler:
        result = await crawler.arun(
            url="https://www.scrapeless.com/en",
            config=CrawlerRunConfig(
                wait_for="css:.content",
                scan_full_page=True,
            ),
        )
        print("-" * 20)
        print(f'Status Code: {result.status_code}')
        print("-" * 20)
        print(f'Title: {result.metadata["title"]}')
        print(f'Description: {result.metadata["description"]}')
        print("-" * 20)
asyncio.run(main())
4. Dấu vân tay trình duyệt tùy chỉnh
Để mô phỏng hành vi người dùng thực, Scrapeless hỗ trợ dấu vân tay trình duyệt được tạo ngẫu nhiên và cũng cho phép các tham số dấu vân tay tùy chỉnh. Điều này giảm hiệu quả rủi ro bị các trang web mục tiêu phát hiện.
import json
import asyncio
from urllib.parse import quote, urlencode
from crawl4ai import CrawlerRunConfig, BrowserConfig, AsyncWebCrawler

async def main():
# customize browser fingerprint
    fingerprint = {
        "userAgent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/134.1.2.3 Safari/537.36",
        "platform": "Windows",
        "screen": {
            "width": 1280, "height": 1024
        },
        "localization": {
            "languages": ["zh-HK", "en-US", "en"], "timezone": "Asia/Hong_Kong",
        }
    }

    fingerprint_json = json.dumps(fingerprint)
    encoded_fingerprint = quote(fingerprint_json)

    scrapeless_params = {
        "token": "your token",
        "sessionTTL": 1000,
        "sessionName": "Fingerprint Demo",
        "fingerprint": encoded_fingerprint,
    }
    query_string = urlencode(scrapeless_params)
    scrapeless_connection_url = f"wss://browser.scrapeless.com/api/v2/browser?{query_string}"async with AsyncWebCrawler(
        config=BrowserConfig(
            headless=False,
            browser_mode="cdp",
            cdp_url=scrapeless_connection_url,
        )
    ) as crawler:
        result = await crawler.arun(
            url="https://www.scrapeless.com/en",
            config=CrawlerRunConfig(
                wait_for="css:.content",
                scan_full_page=True,
            ),
        )
        print("-" * 20)
        print(f'Status Code: {result.status_code}')
        print("-" * 20)
        print(f'Title: {result.metadata["title"]}')
        print(f'Description: {result.metadata["description"]}')
        print("-" * 20)
asyncio.run(main())
5. Tái sử dụng Profile
Scrapeless gán cho mỗi profile một môi trường trình duyệt độc lập riêng, cho phép đăng nhập bền vững và cô lập danh tính. Người dùng chỉ cần cung cấp profileId để tái sử dụng một phiên trước đó.
import asyncio
from urllib.parse import urlencode
from crawl4ai import CrawlerRunConfig, BrowserConfig, AsyncWebCrawler

async def main():
    scrapeless_params = {
        "token": "your token",
        "sessionTTL": 1000,
        "sessionName": "Profile Demo",
        "profileId": "your profileId",# create profile on scrapeless
    }
    query_string = urlencode(scrapeless_params)
    scrapeless_connection_url = f"wss://browser.scrapeless.com/api/v2/browser?{query_string}"async with AsyncWebCrawler(
        config=BrowserConfig(
            headless=False,
            browser_mode="cdp",
            cdp_url=scrapeless_connection_url,
        )
    ) as crawler:
        result = await crawler.arun(
            url="https://www.scrapeless.com",
            config=CrawlerRunConfig(
                wait_for="css:.content",
                scan_full_page=True,
            ),
        )
        print("-" * 20)
        print(f'Status Code: {result.status_code}')
        print("-" * 20)
        print(f'Title: {result.metadata["title"]}')
        print(f'Description: {result.metadata["description"]}')
        print("-" * 20)
asyncio.run(main())