概述
Scrapeless MCP Server 是 Scrapeless 官方的 Model Context Protocol 集成。它通过一个统一的服务器,为 LLM、AI 智能体以及 AI 原生工具——ChatGPT、Claude、Cursor、Windsurf 以及任意兼容 MCP 的客户端——提供对网络的实时访问能力。
只需一个服务器,你就可以:
- 搜索 Google SERP、Trends、Scholar、Flights 等
- 抓取 任意页面为 HTML、Markdown 或截图——并绕过 Cloudflare 及其他反爬保护
- 爬取 整个站点,支持可配置的深度和限定范围的 URL 目标
- 自动化 可扩展的云端浏览器:导航、点击、输入、滚动和提取
为什么选择 Scrapeless MCP
与本地的浏览器自动化 MCP 服务器不同,Scrapeless 完全运行在云端,为开发者和 AI 智能体提供生产级的规模和可靠性:
- 零本地配置 —— 无需维护浏览器二进制文件、驱动程序或无头模式配置。
- 无限并发 —— 借助自动扩缩容基础设施,启动 50–1000+ 个并行会话。
- 内置反检测 —— 自动处理 reCAPTCHA、Cloudflare Turnstile 和 AWS WAF。
- 全球 IP 覆盖 —— 覆盖 195+ 个国家/地区的住宅、ISP 和无限量代理池。
- 单一 API 令牌 —— 一个 Scrapeless 密钥即可通过同一服务器解锁所有产品。
Scrapeless MCP 与第三方浏览器 MCP 的对比
Scrapeless MCP 是 Scrapeless 自有的多产品服务器。它与那些将 Scrapeless Cloud Browser 作为后端连接的第三方浏览器 MCP 服务器不同:
| MCP Server | 技术栈 | 最适用于 |
|---|---|---|
| Scrapeless MCP | 云服务 | 从任意 MCP 客户端跨所有 Scrapeless 产品进行搜索、抓取、爬取和浏览器自动化。 |
| Chrome DevTools MCP | Node.js / Puppeteer | CI/CD 自动化、跨 IDE 工作流以及深入的性能审计。 |
| Playwright MCP | Node.js / Playwright | 确定性的、基于无障碍树的自动化,能够抵御细微的 UI 变化。 |
Chrome DevTools MCP 和 Playwright MCP 是集成方案,它们针对 Scrapeless Cloud Browser 运行第三方 MCP。本节介绍的是 Scrapeless 自有的 MCP 服务器。有关第三方选项,请参阅 相关集成。
本节内容
- 快速开始 —— 在两分钟内连接一个客户端。
- 按产品分类的工具 —— 按 Browser、Crawl、AI Scraper、Web Unlocker、Scraping API 和 Proxies 分组的完整工具目录。
- 认证与传输方式 —— API 令牌以及 Stdio 和 Streamable HTTP 模式。
- 客户端设置 —— 针对 Claude、Cursor、Cline、Codex、Windsurf 以及自定义客户端的分步指南。
- 配置 —— 会话、配置文件和行为选项。
案例展示
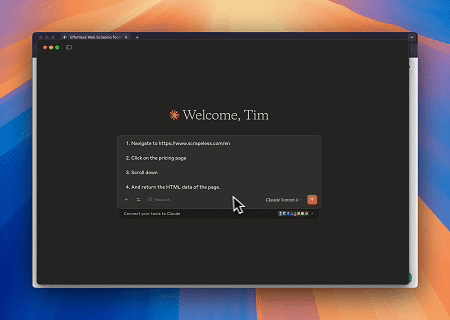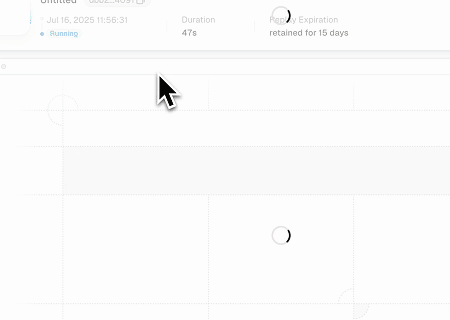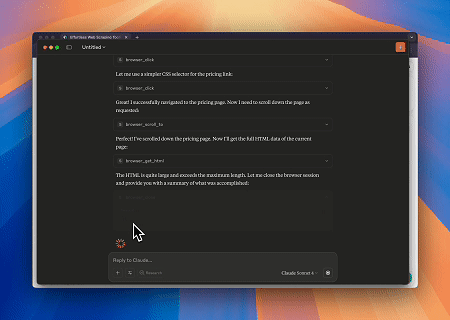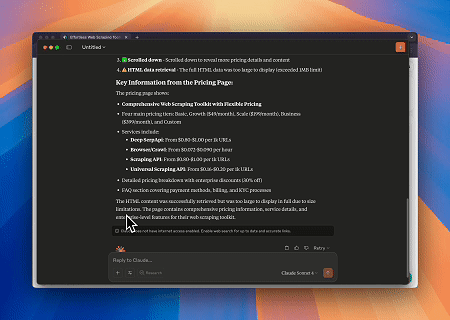
案例 1:使用 Claude 进行网页交互和数据提取
借助 Scrapeless MCP Server,Claude 可以通过对话式指令执行复杂的网页操作——导航、点击、滚动和数据抓取——并通过实时会话进行执行过程的实时预览。
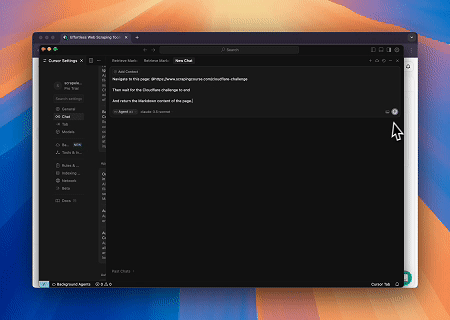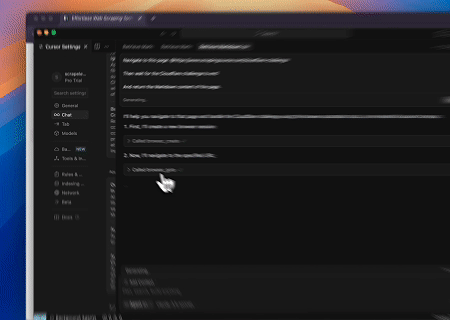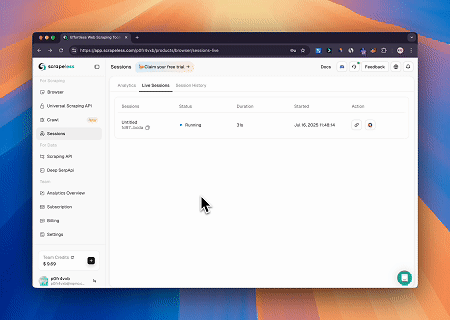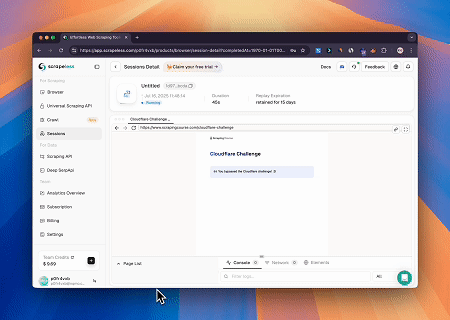
案例 2:绕过 Cloudflare 以获取目标页面内容
借助 Scrapeless MCP Server,可自动访问受 Cloudflare 保护的页面,并在完成后提取页面内容并以 Markdown 格式返回。