JS Render
Web Unlocker API 是一项功能强大的网页内容获取服务,支持复杂的网页渲染与 交互场景。
请参阅我们的 API 文档 以获取详细内容。
请求结构
{
  "actor": "unlocker.webunlocker",
  "proxy": {
    "country": "ANY",
    "url": ""
  },
  "input": {
    "url": "string",
    "jsRender": {
      "enabled": true,
      "headless": true,
      "waitUntil": "domcontentloaded",
      "instructions": [],
      "block": {
        "resources": [],
        "urls": []
      },
      "response": {
        "type": "html",
        "options": {}
      }
    }
  }
}
核心功能
JavaScript 渲染
JavaScript 渲染支持处理动态加载的内容以及 SPA(单页应用)。它会启用 完整的浏览器环境,支持更复杂的页面交互与渲染需求。
input.jsRender.enabled=true,我们将使用浏览器发起请求。
{
  "actor": "unlocker.webunlocker",
  "proxy": {
    "country": "ANY"
  },
  "input": {
    "url": "https://example.com/",
    "jsRender": {
      "enabled": true
    }
  }
}
JavaScript 指令
提供一套丰富的 JavaScript 指令,让你能够动态地与网页进行交互。
这些指令使你能够点击元素、填写表单、提交表单,或等待特定元素出现, 为诸如点击”阅读更多”按钮或提交表单等任务提供了灵活性。
{
  "actor": "unlocker.webunlocker",
  "input": {
    "url": "https://example.com",
    "jsRender": {
      "enabled": true,
      "instructions": [
        {
          "waitFor": [
            ".dynamic-content",
            30000
          ]
          // Wait for element
        },
        {
          "click": [
            "#load-more",
            1000
          ]
          // Click element
        },
        {
          "fill": [
            "#search-input",
            "search term"
          ]
          // Fill form
        },
        {
          "keyboard": [
            "press",
            "Enter"
          ]
          // Simulate key press
        },
        {
          "evaluate": "window.scrollTo(0, document.body.scrollHeight)"
          // Execute custom JS
        }
      ]
    }
  }
}
以下是你可以使用 JavaScript 指令执行的一些常见操作:
JavaScript 指令参考
| 指令 | 语法 | 说明 | 示例 |
|---|---|---|---|
waitFor | [selector, timeout] | 等待元素出现 | {"waitFor": [".content", 30000]} |
click | [selector, delay] | 点击元素 | {"click": [".button", 1000]} |
fill | [selector, value] | 填写表单 | {"fill": ["#input", "text"]} |
wait | milliseconds | 固定等待时间 | {"wait": 2000} |
evaluate | javascript code | 执行 JS 代码 | {"evaluate": "console.log('test')"} |
keyboard | [action, value, delay?] | 键盘操作 | 参见下方键盘操作表 |
键盘操作
| 操作 | 语法 | 说明 | 示例 |
|---|---|---|---|
| 按下按键 | ["press", keyInput] | 按下特定的 keyInput | {"keyboard": ["press", "Enter"]} |
| 输入文本 | ["type", text, delay?] | 输入文本,可选设置延迟 | {"keyboard": ["type", "Hello", 20]} |
| 按下键位 | ["down", key] | 按住某个按键 | {"keyboard": ["down", "Shift"]} |
| 松开键位 | ["up", key] | 释放某个按键 | {"keyboard": ["up", "Shift"]} |
支持的特殊 KeyInput 类型: https://pptr.dev/api/puppeteer.keyinput
响应类型
你可以通过参数 input.jsRender.response.type 指定响应类型,可选值为:
html | plaintext | markdown | png | jpeg | network | content,默认值为 html:
| type | 说明 |
|---|---|
| html | 页面经转义的原始 HTML 字符串,支持 CSS 选择器 |
| plaintext | 页面的纯文本字符串,支持 CSS 选择器 |
| markdown | 页面经转义的 Markdown 字符串,支持 CSS 选择器 |
| png | 页面 png 格式的 base64 编码字符串,支持 CSS 选择器 |
| jpeg | 页面 jpeg 格式的 base64 编码字符串,支持 CSS 选择器 |
| network | 启用网络请求捕获,将收集页面加载期间发起的所有 XHR 和 fetch 请求,并以转义的 JSON 字符串格式返回其详情,不支持 CSS 选择器 |
| content | 从页面内容中过滤数据,以转义的 JSON 字符串格式返回结果 |
详情如下
HTML
用于提取页面的 HTML 内容,最适合纯静态页面,返回经转义的 HTML 字符串格式内容。
在请求中添加 input.jsRender.response.type=html:
const axios = require('axios');
const fs = require('fs');

(async () => {
    const payload = {
        actor: "unlocker.webunlocker",
        proxy: {
            country: "ANY"
        },
        input: {
            url: "https://www.example.com",
            jsRender: {
                enabled: true,
                response: {
                    type: "html"
                }
            }
        }
    };

    const response = await axios.post("https://api.scrapeless.com/api/v2/unlocker/request", payload, {
        headers: {
            "x-api-token": "API Key",
            "Content-Type": "application/json"
        },
        timeout: 60000
    });

    if (response.data?.code === 200) {
        fs.writeFileSync('response.html', response.data.data, 'utf8');
    }
})();以 HTML 格式返回文本内容。
{
    "code": 200,
    "data": "<!DOCTYPE html><html><head>\n    <title>Example Domain</title>\n\n    <meta charset=\"utf-8\">\n    <meta http-equiv=\"Content-type\" content=\"text/html; charset=utf-8\">\n    <meta name=\"viewport\" content=\"width=device-width, initial-scale=1\">\n    <style type=\"text/css\">\n    body {\n        background-color: #f0f0f2;\n        margin: 0;\n        padding: 0;\n        font-family: -apple-system, system-ui, BlinkMacSystemFont, \"Segoe UI\", \"Open Sans\", \"Helvetica Neue\", Helvetica, Arial, sans-serif;\n        \n    }\n    div {\n        width: 600px;\n        margin: 5em auto;\n        padding: 2em;\n        background-color: #fdfdff;\n        border-radius: 0.5em;\n        box-shadow: 2px 3px 7px 2px rgba(0,0,0,0.02);\n    }\n    a:link, a:visited {\n        color: #38488f;\n        text-decoration: none;\n    }\n    @media (max-width: 700px) {\n        div {\n            margin: 0 auto;\n            width: auto;\n        }\n    }\n    </style>    \n</head>\n\n<body>\n<div>\n    <h1>Example Domain</h1>\n    <p>This domain is for use in illustrative examples in documents. You may use this\n    domain in literature without prior coordination or asking for permission.</p>\n    <p><a href=\"https://www.iana.org/domains/example\">More information...</a></p>\n</div>\n\n\n</body></html>"
}
保存后 HTML 文件的示例内容:
<!DOCTYPE html><html><head>
    <title>Example Domain</title>

    <meta charset="utf-8">
    <meta http-equiv="Content-type" content="text/html; charset=utf-8">
    <meta name="viewport" content="width=device-width, initial-scale=1">
    <style type="text/css">
    body {
        background-color: #f0f0f2;
        margin: 0;
        padding: 0;
        font-family: -apple-system, system-ui, BlinkMacSystemFont, "Segoe UI", "Open Sans", "Helvetica Neue", Helvetica, Arial, sans-serif;

    }
    div {
        width: 600px;
        margin: 5em auto;
        padding: 2em;
        background-color: #fdfdff;
        border-radius: 0.5em;
        box-shadow: 2px 3px 7px 2px rgba(0,0,0,0.02);
    }
    a:link, a:visited {
        color: #38488f;
        text-decoration: none;
    }
    @media (max-width: 700px) {
        div {
            margin: 0 auto;
            width: auto;
        }
    }
    </style>
</head>

<body>
<div>
    <h1>Example Domain</h1>
    <p>This domain is for use in illustrative examples in documents. You may use this
    domain in literature without prior coordination or asking for permission.</p>
    <p><a href="https://www.iana.org/domains/example">More information...</a></p>
</div>

</body></html>
Plaintext
纯文本功能是一种输出选项,它以纯文本格式返回抓取的内容,而非 HTML 或 Markdown。当需要一份干净、无格式的内容版本(不含任何 HTML 标签或 Markdown 格式)时,该功能非常实用。它简化了内容提取流程,让文本处理或分析更加 便捷。
在请求中添加 input.jsRender.response.type=plaintext:
const axios = require('axios');
const fs = require('fs');

(async () => {
    const payload = {
        actor: "unlocker.webunlocker",
        proxy: {
            country: "ANY"
        },
        input: {
            url: "https://www.example.com",
            jsRender: {
                enabled: true,
                response: {
                    type: "plaintext"
                }
            }
        }
    };

    const response = await axios.post("https://api.scrapeless.com/api/v2/unlocker/request", payload, {
        headers: {
            "x-api-token": "API Key",
            "Content-Type": "application/json"
        },
        timeout: 60000
    });

    if (response.data?.code === 200) {
        fs.writeFileSync('response.txt', response.data.data, 'utf8');
    }
})();以字符串形式返回页面的纯文本内容。参见下方示例。
{
    "code": 200,
    "data": "Example Domain\n\nThis domain is for use in illustrative examples in documents. You may use this domain in literature without prior coordination or asking for permission.\n\nMore information..."
}
保存后 txt 文件的示例内容:
Example Domain

This domain is for use in illustrative examples in documents. You may use this domain in literature without prior coordination or asking for permission.

More information...
Markdown
用于以 Markdown 格式提取页面内容,纯静态 Markdown 页面效果最佳,Web Unlocker API 将 以 Markdown 格式返回内容, 使其更易于阅读和处理。
在请求中添加 input.jsRender.response.type=markdown:
const axios = require('axios');
const fs = require('fs');

(async () => {
    const payload = {
        actor: "unlocker.webunlocker",
        proxy: {
            country: "ANY"
        },
        input: {
            url: "https://www.example.com",
            jsRender: {
                enabled: true,
                response: {
                    type: "markdown"
                }
            }
        }
    };

    const response = await axios.post("https://api.scrapeless.com/api/v2/unlocker/request", payload, {
        headers: {
            "x-api-token": "API Key",
            "Content-Type": "application/json"
        },
        timeout: 60000
    });

    if (response.data?.code === 200) {
        fs.writeFileSync('response.md', response.data.data, 'utf8');
    }
})();以 Markdown 格式返回文本内容。
{
    "code": 200,
    "data": "# Example Domain\n\nThis domain is for use in illustrative examples in documents. You may use this domain in literature without prior coordination or asking for permission.\n\n[More information...](https://www.iana.org/domains/example)"
}
保存 Markdown 文件后的示例内容:
# Example Domain

This domain is for use in illustrative examples in documents. You may use this domain in literature without prior coordination or asking for permission.

[More information...](https://www.iana.org/domains/example)
PNG/JPEG
你可以截取目标页面的屏幕截图,并返回
PNG 或 JPEG 格式的图像。当响应结果设置为 PNG 或 JPEG 时,你可以使用
input.jsRender.response.options.fullPage=true
参数来指定返回结果是否为整页截图。
通过在请求中添加 input.jsRender.response.type=png or jpeg:
const axios = require('axios');
const fs = require('fs');

(async () => {
    const payload = {
        actor: "unlocker.webunlocker",
        proxy: {
            country: "ANY"
        },
        input: {
            url: "https://www.example.com",
            jsRender: {
                enabled: true,
                response: {
                    type: "png" // png or jpeg
                }
            }
        }
    };

    const response = await axios.post("https://api.scrapeless.com/api/v2/unlocker/request", payload, {
        headers: {
            "x-api-token": "API Key",
            "Content-Type": "application/json"
        },
        timeout: 60000
    });

    if (response.data?.code === 200) {
        fs.writeFileSync('response.png', Buffer.from(response.data.data, 'base64'));
    }
})();以 PNG 或 JPEG 格式返回 base64 编码的字符串。
{
    "code": 200,
    "data": "JVBERi0xLjQKJdPr6eEKM..."
}
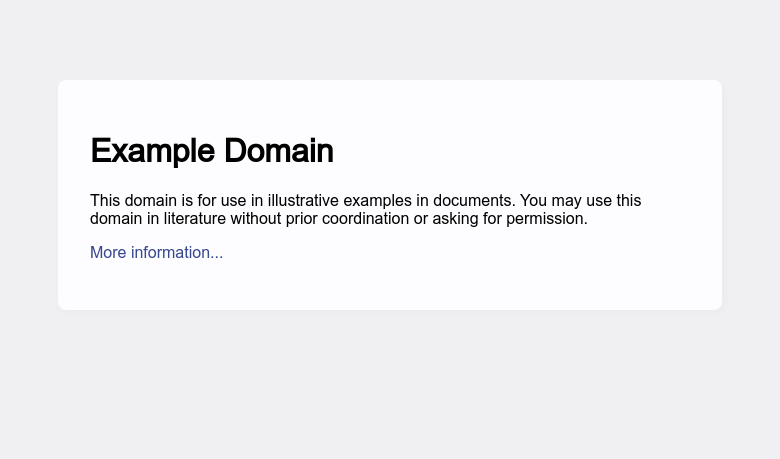
以 png/jpeg 格式保存后的示例文件:
Network
当 input.jsRender.response.type=network 时,页面加载期间会捕获所有 XHR 和 fetch 类型的网络请求。
随后,
网络请求数据将以转义的 JSON 字符串格式返回。此响应数据包括 URL、请求
方法、响应状态码、请求头、响应体等。
如果请求体或响应体包含二进制内容、超大响应体或非文本数据,则不会直接返回原始
内容。取而代之的是使用占位字符串 [Preview not available ...] 进行标记
。你可以使用
input.jsRender.response.options
参数,按 URL、请求方法和状态码条件过滤结果。
const axios = require('axios');
const fs = require('fs');

(async () => {
    const payload = {
        actor: "unlocker.webunlocker",
        proxy: {
            country: "ANY"
        },
        input: {
            url: "https://www.example.com",
            jsRender: {
                enabled: true,
                response: {
                    type: "network",
                    options: {
                        "urls": [
                            "/example"
                        ],
                        "status": [
                            200
                        ],
                        "methods": [
                            "get"
                        ]
                    }
                }
            }
        }
    };

    const response = await axios.post("https://api.scrapeless.com/api/v2/unlocker/request", payload, {
        headers: {
            "x-api-token": "API Key",
            "Content-Type": "application/json"
        },
        timeout: 60000
    });

    if (response.data?.code === 200) {
        fs.writeFileSync('response.json', response.data.data, 'utf8');
    }
})();以转义的 JSON 字符串返回数据:
{
    "code": 200,
    "data": "[{\"url\":\"https://www.tiktok.com/api/explore/item_list/...]"
}
示例 JSON 结果如下所示:
[
{
"url": "https://www.tiktok.com/api/explore/item_list/?WebIdLastTime=1752724401&aid=1988&app_language=en&app_name=tiktok_web&browser_language=en&browser_name=Mozilla&browser_online=true&browser_platform=Win32&browser_version=5.0%20%28Windows%20NT%2010.0%3B%20Win64%3B%20x64%29%20AppleWebKit%2F537.36%20%28KHTML%2C%20like%20Gecko%29%20Chrome%2F135.0.0.0%20Safari%2F537.36&categoryType=120&channel=tiktok_web&clientABVersions=70508271%2C73485602%2C73547759%2C73720540%2C73810951%2C73814854%2C73848867%2C73866686%2C73944035%2C73969557%2C73990102%2C74048200%2C74129613%2C74148345%2C74157215%2C74163128%2C74176097%2C74195789%2C74213192%2C74241848%2C70405643%2C71057832%2C71200802%2C72361743%2C73171280%2C73208420&cookie_enabled=true&count=8&data_collection_enabled=false&device_id=7527893946556515853&device_platform=web_pc&enable_cache=true&focus_state=true&history_len=2&is_fullscreen=false&is_page_visible=true&language=en&odinId=7527893969448764429&os=windows&priority_region=&referer=®ion=US&screen_height=1440&screen_width=3440&tz_name=America%2FNew_York&user_is_login=false&webcast_language=en",
"method": "GET",
"resourceType": "fetch",
"status": 200,
"timestamp": 1752724403206,
"payload": null,
"requestReaders": {
"sec-ch-ua-platform": "\"Windows\"",
"referer": "https://www.tiktok.com/explore",
"user-agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/135.0.0.0 Safari/537.36",
"sec-ch-ua": "\"Google Chrome\";v=\"135\", \"Not-A.Brand\";v=\"8\", \"Chromium\";v=\"135\"",
"sec-ch-ua-mobile": "?0",
"accept": "*/*",
"cookie": "tt_csrf_token=KO5LUsj8-r2G0Lcbmx_RqngSiFd_VRcPiaeY; ttwid=1%7CQapzXhCnEqiLXypjvNK3iX65g9iXPk_Jpj4GGLdqNRY%7C1752724401%7Cfb5daf3940529652ba613376c011e990b0afede828ad52c4e0c14f1c422bea61; tt_chain_token=jIGTF0ppLEuXKFGayjhpyg=="
},
"responseHeaders": {
"access-control-expose-headers": "x-tt-traceflag,x-tt-logid",
"bd-tt-error-code": "0",
"cache-control": "max-age=1800, must-revalidate",
"content-encoding": "br",
"content-length": "30900",
"content-type": "application/json; charset=utf-8",
"date": "Thu, 17 Jul 2025 03:53:23 GMT",
"expires": "Thu, 17 Jul 2025 03:53:23 GMT",
"pragma": "no-cache",
"server": "nginx",
"server-timing": "cdn-cache; desc=HIT, edge; dur=0, origin; dur=0\ninner; dur=387",
"tt_stable": "1",
"x-akamai-request-id": "42a8e99d",
"x-cache": "TCP_MEM_HIT from a23-47-221-69.deploy.akamaitechnologies.com (AkamaiGHost/22.2.0-c471f2b4819e3aa253dfcc21bfdfd452) (-)",
"x-ms-token": "YAOuylbpReZ5gTM1PP8mwsmWMCxWprQ4oHRNuZQgKsADY7HTftSBu6W9raVm6PKyp-1mXt9Q6CIs0BHLRxozI_uNNEOWSvkaxFyunXX-54aBUvkuHBe2id6bY0cB",
"x-tt-logid": "20250717035100C13E2314287BF101E7D9",
"x-tt-trace-host": "0102b37aa413a15dcf9191a3f676ab4b78d5ba03a6d109c921ad21a607e80d7a40dbc340eb8c009458e52488a06a1b874047a91b63eb21ce08d01175dca60742a8bdf12f766710e93ed82ca68be07bf95a053639c5cedca212d37246317d611b65",
"x-tt-trace-id": "00-250717035100C13E2314287BF101E7D9-729F56051B790290-00",
"x-tt-trace-tag": "id=16;cdn-cache=hit;type=static"
},
"responseBody": {
"data": "omitted"
},
"responseSize": 249297,
"error": null
}
]Content
当 input.jsRender.response.type=content 时,它会从页面内容中过滤 JSON 格式的数据,响应将
固定为 JSON
字符串格式。input.jsRender.response.options.outputs 参数允许你精确定义要从抓取的页面内容中提取哪些数据类型,
从而高效地仅获取所需信息。这样,你可以减少处理时间,并聚焦于对你的用例
最相关的数据。
如果 input.jsRender.response.options.outputs 为空,则返回所有输出,可选的输出包括:
phone_numbers、headings、images、audios、videos、links、menus、hashtags、emails、metadata、tables、
favicon。
有关详细用法,请查看下方代码。
const axios = require('axios');
const fs = require('fs');

(async () => {
    // Configuration
    const url = "https://api.scrapeless.com/api/v2/unlocker/request";
    const token = "API Key";

    const headers = {"x-api-token": token, "Content-Type": "application/json"};

    const payload = {
        actor: "unlocker.webunlocker",
        proxy: {
            country: "ANY"
        },
        input: {
            url: "https://www.example.com",
            jsRender: {
                enabled: true,
                response: {
                    type: "content",
                    options: {
                        outputs: [
                            "phone_numbers",
                            "headings",
                            "images",
                            "audios",
                            "videos",
                            "links",
                            "menus",
                            "hashtags",
                            "emails",
                            "metadata",
                            "tables",
                            "favicon"
                        ]
                    }
                }
            }
        }
    };

    try {
        const response = await axios.post(url, payload, {headers, timeout: 60000});

        if (response.status !== 200) {
            throw newError(`HTTP Error: ${response.status}`);
        }

        const data = response.data;
        if (data.code !== 200) {
            throw newError(`API Error: ${data}`);
        }

        const content = data.data || '';

        // Save and return result
        fs.writeFileSync('response.json', content, 'utf8');
        console.log('✅ Success! Content saved as response.json');

        returnJSON.parse(content);

    } catch (error) {
        console.error('❌ Error:', error.message);
        throw error;
    }
})()以下是一些示例:
Emails
使用 CSS 选择器和正则表达式提取标准格式的电子邮件地址,例如 example@example.com。
{
    "code": 200,
    "data": "{\"emails\":[\"market@scrapeless.com\"]}"
}
Phone Numbers
使用 CSS 选择器和正则表达式提取电话号码,重点关注包含 tel:
协议的链接。
示例:outputs=phone_numbers
{
    "code": 200,
    "data": "{ \"phone_numbers\": [ \"+1-111-111-111\" ] }"
}
Headings
提取 HTML 中从 H1 到 H6 的标题文本。
示例:outputs=headings
{
    "code": 200,
    "data": "{\"headings\":[\"Example Domain\"]}"
}
Images
从 img 标签中提取图片来源。仅返回 src 属性。
示例:outputs=images
{
    "code": 200,
    "data": "{\"images\":[\"https://www.scrapeless.com/_next/image?url=%2Fassets%2Fimages%2Ftoolkit%2Flight%2Fimg-2.png&w=750&q=100\"]}"
}
Audios
从 audio 标签内的 source 元素中提取音频来源。仅返回 src 属性。
示例:outputs=audios
{
    "code": 200,
    "data": "{\"audios\":[\"https://example.com/audio.mp3\"]}"
}
Videos
从 video 标签内的 source 元素中提取视频来源。仅返回 src 属性。
示例:outputs=videos
{
    "code": 200,
    "data": "{\"videos\":[\"https://example.com/video.mp4\"]}"
}
Links
从 a 标签中提取 URL。仅返回 href 属性。
示例:outputs=links
{
    "code": 200,
    "data": "{\"links\":[\"https://app.scrapeless.com/landing/guide\",\"https://www.scrapeless.com/en\",\"https://www.scrapeless.com/en/pricing\",\"https://docs.scrapeless.com/\",\"https://backend.scrapeless.com/app/api\",\"https://www.producthunt.com/posts/scrapeless-deep-serpapi\",\"https://www.g2.com/products/scrapeless/reviews\",\"https://www.trustpilot.com/review/scrapeless.com\",\"https://slashdot.org/software/p/Scrapeless/\",\"https://tekpon.com/software/scrapeless/reviews/\",\"https://www.scrapeless.com/en/product/deep-serp-api\",\"https://www.scrapeless.com/en/product/scraping-browser\",\"https://www.scrapeless.com/en/product/scraping-api\",\"https://www.scrapeless.com/en/product/universal-scraping-api\",\"https://www.scrapeless.com/en/solutions/e-commerce\",\"https://www.scrapeless.com/en/solutions/seo\",\"https://www.scrapeless.com/en/solutions/real-estate\",\"https://www.scrapeless.com/en/solutions/travel-hotel-airline\",\"https://www.scrapeless.com/en/solutions/social-media\",\"https://www.scrapeless.com/en/solutions/market-research\",\"https://www.scrapeless.com/en/blog\",\"https://www.scrapeless.com/en/blog/deep-serp-api-online\",\"https://www.scrapeless.com/en/blog/scrapeless-web-scraping-toolkit\",\"https://www.scrapeless.com/en/blog/google-shopping-scrape\",\"https://backend.scrapeless.com/app/api/v1/public/links/github\",\"https://backend.scrapeless.com/app/api/v1/public/links/youtube\",\"mailto:market@scrapeless.com\",\"https://www.scrapeless.com/en/ai-agent\",\"https://browserless.scrapeless.com/\",\"https://www.scrapeless.com/en/solutions/temu\",\"https://www.scrapeless.com/en/solutions/walmart\",\"https://www.scrapeless.com/en/solutions/shopee\",\"https://www.scrapeless.com/en/solutions/lazada\",\"https://www.scrapeless.com/en/solutions/amazon\",\"https://www.scrapeless.com/en/solutions/google-trends\",\"https://www.scrapeless.com/en/solutions/google-search\",\"https://www.scrapeless.com/en/solutions/airbnb\",\"https://www.scrapeless.com/en/solutions/scoot\",\"https://www.scrapeless.com/en/solutions/latam\",\"https://www.scrapeless.com/en/solutions/localiza\",\"https://www.scrapeless.com/en/solutions/tiktok\",\"https://www.scrapeless.com/en/solutions/instagram\",\"https://www.scrapeless.com/en/integration\",\"https://www.scrapeless.com/en/faq\",\"https://www.scrapeless.com/en/glossary\",\"https://www.scrapeless.com/en/legal/privacy-policy\",\"https://www.scrapeless.com/en/legal/terms\",\"https://www.scrapeless.com/en/legal/terms#refund-policy\",\"https://www.scrapeless.com/en/legal/check-your-data\",\"https://backend.scrapeless.com/app/api/v1/public/links/discord\"]}"
}
Menus
从菜单标签内的 li 元素中提取菜单项。
示例:outputs=menus
{
    "code": 200,
    "data": "{\"links\":[ \"Coffee\", \"Tea\", \"Milk\" ]}"
}
Hashtags
使用正则表达式提取话题标签格式,以匹配典型的话题标签模式,例如 #example。
示例:outputs = hashtags
{
    "code": 200,
    "data": "{\"hashtags\":[\"#docsearch\",\"#search\"]}"
}
Metadata
从 head 部分的 meta 标签中提取元信息,以
name: content 的格式返回 name 和 content 属性。
示例:outputs=metadata
{
    "code": 200,
    "data": "{\"metadata\":[\"viewport: width=device-width, initial-scale=1\",\"description: Scrapeless is the best full-stack web scraping toolkit offering Scraping API, Agent Browser\"]}"
}
Tables
从表格元素中提取数据,并以 JSON 格式返回表格数据,包括维度、表头和内容。
示例:outputs=tables
{
    "code": 200,
    "data": "{\"tables\":[{\"dimensions\":{\"rows\":7,\"columns\":3,\"heading\":true},\"heading\":[\"Company\",\"Contact\",\"Country\"],\"content\":[{\"Company\":\"Alfreds Futterkiste\",\"Contact\":\"Maria Anders\",\"Country\":\"Germany\"},{\"Company\":\"Centro comercial Moctezuma\",\"Contact\":\"Francisco Chang\",\"Country\":\"Mexico\"},{\"Company\":\"Ernst Handel\",\"Contact\":\"Roland Mendel\",\"Country\":\"Austria\"},{\"Company\":\"Island Trading\",\"Contact\":\"Helen Bennett\",\"Country\":\"UK\"},{\"Company\":\"Laughing Bacchus Winecellars\",\"Contact\":\"Yoshi Tannamuri\",\"Country\":\"Canada\"},{\"Company\":\"Magazzini Alimentari Riuniti\",\"Contact\":\"Giovanni Rovelli\",\"Country\":\"Italy\"}]},{\"dimensions\":{\"rows\":11,\"columns\":2,\"heading\":true},\"heading\":[\"Tag\",\"Description\"],\"content\":[{\"Tag\":\"<table>\",\"Description\":\"Defines a table\"},{\"Tag\":\"<th>\",\"Description\":\"Defines a header cell in a table\"},{\"Tag\":\"<tr>\",\"Description\":\"Defines a row in a table\"},{\"Tag\":\"<td>\",\"Description\":\"Defines a cell in a table\"},{\"Tag\":\"<caption>\",\"Description\":\"Defines a table caption\"},{\"Tag\":\"<colgroup>\",\"Description\":\"Specifies a group of one or more columns in a table for formatting\"},{\"Tag\":\"<col>\",\"Description\":\"Specifies column properties for each column within a <colgroup> element\"},{\"Tag\":\"<thead>\",\"Description\":\"Groups the header content in a table\"},{\"Tag\":\"<tbody>\",\"Description\":\"Groups the body content in a table\"},{\"Tag\":\"<tfoot>\",\"Description\":\"Groups the footer content in a table\"}]}]}"
}
Favicon
从 HTML head 部分的 link 元素中提取 favicon URL。
示例:outputs=favicon
{
    "code": 200,
    "data": "{\"favicon\":\"https://www.scrapeless.com/favicon.ico\"}"
}
资源控制
资源加载控制系统,用于优化性能和带宽使用。
{
  "actor": "unlocker.webunlocker",
  "proxy": {
    "country": "ANY",
    "url": ""
  },
  "input": {
    "url": "string",
    "jsRender": {
      "enabled": true,
      "block": {
        "resources": [
          "Image",
          "Font",
          "Stylesheet",
          "Script"
        ],
        "urls": [
          // Optional, URL pattern-based blocking
          "*.analytics.com/*",
          "*/ads/*"
        ]
      }
    }
  }
}
完整资源类型参考:
| 资源类型 | 说明 | 影响 |
|---|---|---|
Document | 主文档和 iframe | 核心页面内容 |
Stylesheet | CSS 文件 | 页面样式与布局 |
Image | 图片和图标 | 视觉内容 |
Media | 音频和视频资源 | 多媒体内容 |
Font | Web 字体 | 文本渲染 |
Script | JavaScript 文件 | 页面功能 |
TextTrack | 视频字幕和说明文字 | 媒体无障碍访问 |
XHR | XMLHttpRequest 调用 | 传统异步请求 |
Fetch | Fetch API 请求 | 现代异步请求 |
Prefetch | 预取资源 | 性能优化 |
EventSource | 服务器发送事件 | 实时更新 |
WebSocket | WebSocket 连接 | 双向通信 |
Manifest | Web 应用清单 | PWA 配置 |
SignedExchange | 签名的 HTTP 交换 | 内容真实性 |
Ping | Ping 请求 | 分析与跟踪 |
CSPViolationReport | CSP 违规报告 | 安全监控 |
Preflight | CORS 预检请求 | 跨域安全 |
Other | 未分类资源 | 杂项 |
使用示例:
{
  "actor": "unlocker.webunlocker",
  "proxy": {
    "country": "ANY",
    "url": ""
  },
  "input": {
    "url": "string",
    "jsRender": {
      "enabled": true,
      "block": {
        "resources": [
          "Image",
          "Font",
          "Stylesheet",
          "Script",
          "Media",
          "Ping",
          "Prefetch"
        ]
      }
    }
  }
}
资源拦截的最佳实践:
-
性能优化
- 明智地使用资源拦截,拦截非必要资源以加快加载速度
- 考虑拦截
Prefetch和Ping以减少网络使用 - 保持
Document和关键Script资源不被拦截
-
带宽管理
- 对带宽消耗大的页面拦截
Image和Media - 考虑拦截
Font以改用系统字体
- 对带宽消耗大的页面拦截
-
稳定性增强
- 实现请求重试机制
- 添加错误处理逻辑
- 使用
waitFor而非固定的wait
-
资源效率
- 按需加载资源
- 及时关闭不必要的连接
注意: 资源类型字符串区分大小写。请使用参考表中所示的精确匹配值。