Bypass de Cloudflare en extracción de datos
Agent Browser y Cloudflare
Este documento técnico explica cómo utilizar las herramientas Scrapeless Agent Browser y Scrapeless Web Unlocker para manejar diversos desafíos de seguridad establecidos por Cloudflare. Las características clave incluyen el bypass del JS Challenge de Cloudflare, Cloudflare Turnstile y la ejecución de renderizado de JavaScript para acceder a contenido protegido por Cloudflare. Este documento proporcionará conocimientos generales, introducción a funciones, pasos operativos y explicaciones de ejemplos de código.
Comprensión de los desafíos y capas de seguridad de Cloudflare
Cloudflare, un servicio popular de seguridad y rendimiento web, protege principalmente sitios web contra tráfico malicioso o inesperado, como bots y escáneres. Con este fin, Cloudflare implementa varios mecanismos de detección y defensa, entre otros:
1. JS Challenge (Desafío de JavaScript): Requiere que el navegador del visitante ejecute un código JavaScript específico para verificar que se trata de un entorno de navegador legítimo con funcionalidad estándar.
2. Alternativa a Turnstile CAPTCHA: A un mecanismo de verificación menos intrusivo para distinguir entre usuarios humanos y bots.
3. Huella digital del navegador: Recopila y analiza las características técnicas del navegador y del dispositivo (por ejemplo, agente de usuario, resolución de pantalla, fuentes instaladas, complementos) para identificar y rastrear a los visitantes.
4. Limitación de tasa: Supervisa y limita el número de solicitudes provenientes de una misma fuente (por ejemplo, dirección IP) dentro de un período específico para prevenir ataques de fuerza bruta o el abuso de recursos.
Estas capas de seguridad impiden que bibliotecas básicas de solicitudes HTTP, scripts simples o navegadores sin cabeza mal configurados accedan a sitios web protegidos por Cloudflare, lo que resulta en fallos de verificación y denegación de acceso.
Diferencias entre el desafío JS de Cloudflare y otros desafíos
La singularidad del desafío JS de Cloudflare radica en su método de verificación. No solo requiere que el usuario complete una tarea interactiva sencilla (por ejemplo, reconocimiento de imágenes); exige que el entorno cliente (navegador) analice y ejecute correctamente código JavaScript generado dinámicamente, a menudo ofuscado, proveniente de Cloudflare. Este código realiza comprobaciones del entorno, tareas computacionalmente intensivas u otra lógica para verificar las capacidades de comportamiento complejo del cliente, simulando un navegador real.
Superar con éxito el desafío JS implica generar un token de autorización válido (normalmente en forma de una cf_clearance cookie). Este token demuestra que el cliente superó la verificación de capacidad de ejecución de JavaScript. Muchas herramientas de automatización carecen de un motor de ejecución de JavaScript completo y de una simulación realista del entorno del navegador, por lo que no logran superar estos desafíos.
Evitar el desafío JS de Cloudflare usando Scrapeless Agent Browser
Scrapeless Agent Browser está diseñado para manejar medidas complejas de protección de sitios web, incluido el desafío JS de Cloudflare.
Pasos y ejemplo de código
Configuración del entorno
Crear una carpeta de proyecto
Cree una nueva carpeta para el proyecto, por ejemplo: scrapeless-bypass.
Navegue a la carpeta desde su terminal:
cd path/to/scrapeless-bypassInicializar proyecto Node.js
Ejecute el siguiente comando para crear un archivo package.json:
npm init -yInstalar dependencias requeridas
Instale Puppeteer-core, que permite la conexión remota a instancias del navegador:
npm install puppeteer-coreSi Puppeteer aún no está instalado en su sistema, instale la versión completa:
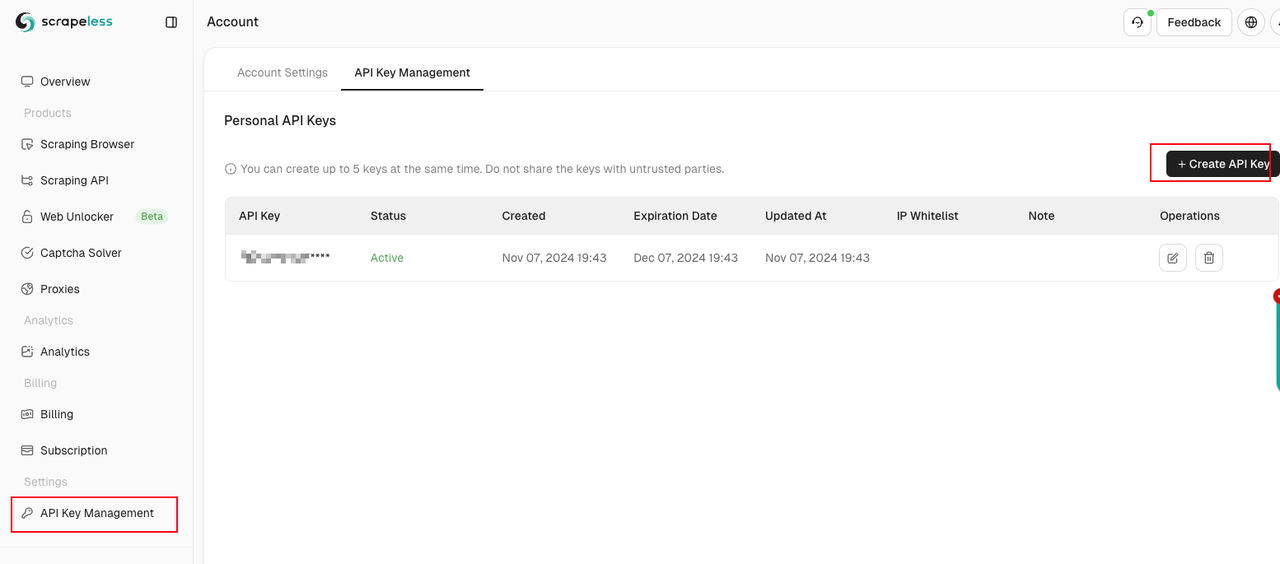
npm install puppeteer puppeteer-coreObtenga y configure su clave de API de Scrapeless.
Conectarse y asegurar que el CAPTCHA se resuelve correctamente
Scrapeless detecta y resuelve automáticamente los CAPTCHA al conectarse al navegador para acceder al sitio web objetivo. Sin embargo, debemos asegurarnos de que el CAPTCHA se resuelva correctamente. Scrapeless Agent Browser amplía el protocolo CDP estándar (Chrome DevTools Protocol) con un conjunto potente de capacidades personalizadas. El estado del solucionador de CAPTCHA se puede observar directamente revisando los resultados devueltos por la API CDP:
Captcha.detected: CAPTCHA detectadoCaptcha.solveFinished: CAPTCHA resuelto correctamenteCaptcha.solveFailed: Error al resolver el CAPTCHA
import puppeteer from "puppeteer-core";
import EventEmitter from 'events';
import { Scrapeless } from '@scrapeless-ai/sdk';

const emitter = new EventEmitter();

const client = new Scrapeless({ apiKey: 'API Key' });

const { browserWSEndpoint } = client.browser.create({
    sessionName: 'sdk_test',
    sessionTTL: 180,
    proxyCountry: 'ANY',
    sessionRecording: true,
    fingerprint,
});

export async function example(url) {
  const browser = await puppeteer.connect({
    browserWSEndpoint,
    defaultViewport: null
  });
  console.log("Verbonden met Scrapeless browser");
  try {
    const page = await browser.newPage();
    // Listen for captcha events
    console.debug("addCaptchaListener: Start listening for captcha events");
    await addCaptchaListener(page);
    console.log("Navigated to URL:", url);
    await page.goto(url, { waitUntil: "domcontentloaded", timeout: 30000 });
    console.log("onCaptchaFinished: Waiting for captcha solving to finish...");
    await onCaptchaFinished()
    // Screenshot for debugging
    console.debug("Taking screenshot of the final page...");
    await page.screenshot({ path: 'screenshot.png', fullPage: true });
  } catch (error) {
    console.error(error);
  } finally {
    await browser.close();
    console.log("Browser closed");
  }
}

async function addCaptchaListener(page) {
  const client = await page.createCDPSession();
  client.on("Captcha.detected", (msg) => {
    console.debug("Captcha.detected: ", msg);
  });
  client.on("Captcha.solveFinished", async (msg) => {
    console.debug("Captcha.solveFinished: ", msg);
    emitter.emit("Captcha.solveFinished", msg);
    client.removeAllListeners()
  });
}

async function onCaptchaFinished(timeout = 60_000) {
  return Promise.race([
    new Promise((resolve) => {
      emitter.on("Captcha.solveFinished", (msg) => {
        resolve(msg);
      });
    }),
    new Promise((_, reject) => setTimeout(() => reject('Timeout'), timeout))
  ])
}Este flujo de trabajo de ejemplo accede al sitio web objetivo y confirma que el CAPTCHA se resolvió correctamente escuchando el evento Captcha.solveFinished de CDP. Finalmente, captura una imagen de la página para verificación.
Este ejemplo define dos métodos principales:
addCaptchaListener: para escuchar eventos de CAPTCHA dentro de la sesión del navegadoronCaptchaFinished: para esperar hasta que el CAPTCHA haya sido resuelto
El código de ejemplo anterior puede utilizarse para escuchar eventos CDP de tres tipos comunes de CAPTCHA tratados en este artículo: reCAPTCHA v2, Cloudflare Turnstile y Cloudflare 5s Challenge.
Tenga en cuenta que el Cloudflare 5s Challenge es algo especial. A veces no desencadena un desafío real, y confiar únicamente en la detección de eventos CDP para determinar el éxito podría provocar tiempos de espera. Por lo tanto, esperar a que aparezca un elemento específico en la página tras el desafío es una solución más estable.
Conexión al WebSocket de Scrapeless Browserless
Scrapeless proporciona una conexión WebSocket, lo que permite a Puppeteer interactuar directamente con el navegador sin cabeza, evitando los desafíos de Cloudflare.
La dirección completa de la conexión WebSocket:
wss://browser.scrapeless.com/api/v2/browser?token=APIKey&sessionTTL=180&proxyCountry=ANYEjemplo de código: Evitar el desafío de Cloudflare
Solo necesitamos el siguiente código para conectarnos al servicio browserless de Scrapeless.
import puppeteer from 'puppeteer-core';

const API_KEY = 'your_api_key'
const host = 'wss://browser.scrapeless.com/api/v2';
const query = new URLSearchParams({
  token: API_KEY,
  sessionTTL: '180', // The life cycle of a browser session, in seconds
  proxyCountry: 'GB', // Agent country
  proxySessionId: 'test_session_id', // The proxy session id is used to keep the proxy ip unchanged. The session time is 3 minutes by default, based on the proxySessionDuration setting.
  proxySessionDuration: '5' // Agent session time, unit minutes
}).toString();

const connectionURL = `${host}/browser?${query}`;
const browser = await puppeteer.connect({
    browserWSEndpoint: connectionURL,
    defaultViewport: null,
});
console.log('Connected!')
Acceso a sitios web protegidos por Cloudflare y verificación mediante captura de pantalla
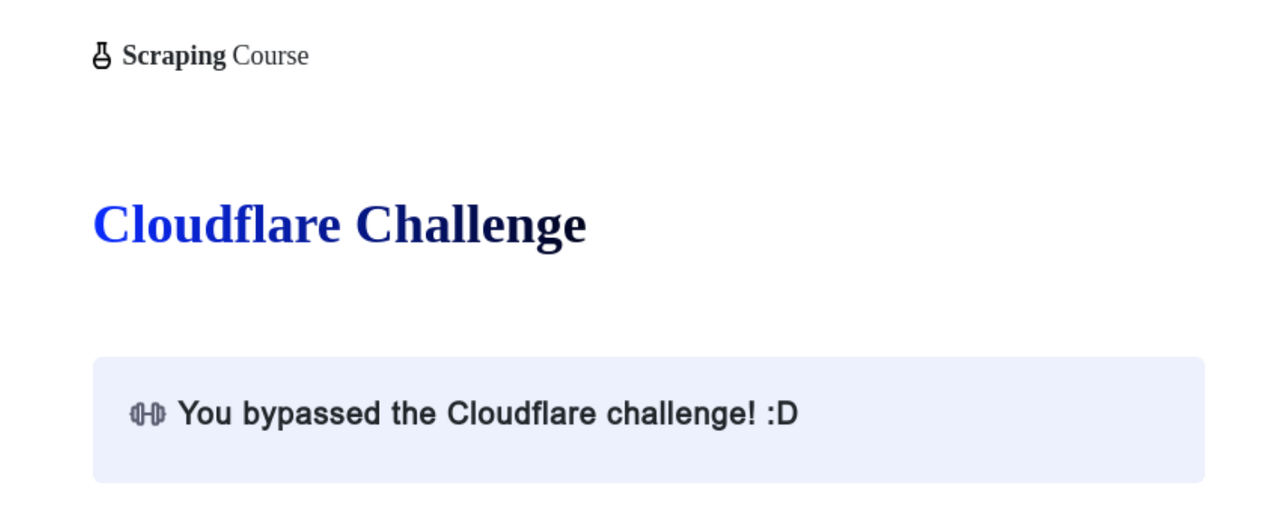
A continuación, utilizamos scrapeless browserless para acceder directamente al sitio de prueba cloudflare-challenge y agregamos una captura de pantalla, lo que permite una verificación visual. Antes de tomar la captura, tenga en cuenta que debe usar waitForSelector para esperar a que los elementos de la página carguen, asegurando así que el desafío de Cloudflare se haya superado correctamente.
const page = await browser.newPage();
await page.goto('https://www.scrapingcourse.com/cloudflare-challenge', {waitUntil: 'domcontentloaded'});
// By waiting for elements in the site page, ensuring that the Cloudflare challenge has been successfully bypassed.
await page.waitForSelector('main.page-content .challenge-info', {timeout: 30 * 1000})
await page.screenshot({path: 'challenge-bypass.png'});
En este punto, ya ha evitado el desafío de Cloudflare utilizando Scrapeless Browserless.
Recuperación de la cookie cf_clearance y del encabezado
Después de superar el desafío de Cloudflare, puede recuperar los encabezados de la solicitud y la cookie cf_clearance desde la página cargada correctamente.
const cookies = await browser.cookies()
const cfClearance = cookies.find(cookie => cookie.name === 'cf_clearance')?.value
Habilite la interceptación de solicitudes para capturar los encabezados y coincidir con las solicitudes de la página tras superar el desafío de Cloudflare.
await page.setRequestInterception(true);
page.on('request', request => {
  // Match page requests after cloudflare challenge
  if (request.url().includes('https://www.scrapingcourse.com/cloudflare-challenge') && request.headers()?.['origin']) {
    const accessRequestHeaders = request.headers();
    console.log('[access_request_headers] =>', accessRequestHeaders);
  }
  request.continue();
});
Evasión de Cloudflare Turnstile mediante el Agent Browser de Scrapeless
Scrapeless Agent Browser también maneja automáticamente los desafíos de Cloudflare Turnstile.
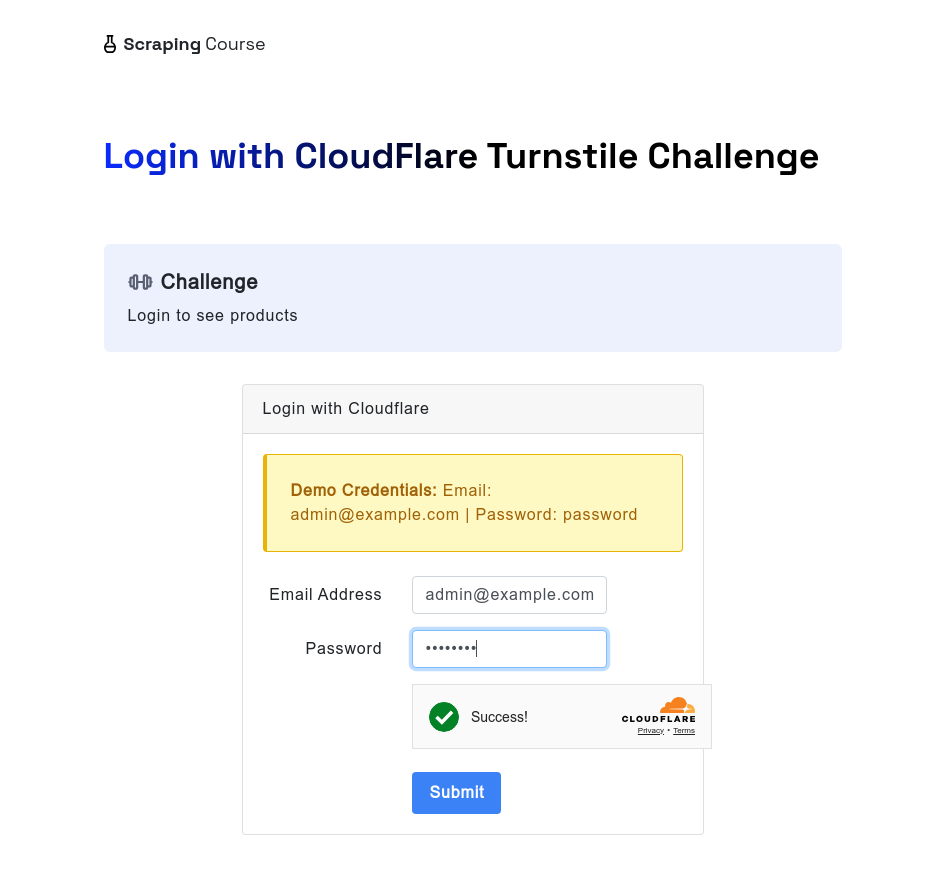
De manera similar, cuando se enfrenta al desafío Cloudflare Turnstile, el navegador browserless de extracción de datos aún puede gestionarlo automáticamente. El siguiente ejemplo accede al sitio de prueba cloudflare-turnstile. Después de ingresar el nombre de usuario y la contraseña, utiliza el método waitForFunction para esperar datos de window.turnstile.getResponse(), asegurando que el desafío se haya superado correctamente. Luego, toma una captura de pantalla y hace clic en el botón de inicio de sesión para navegar a la siguiente página.
Pasos y ejemplo de código:
const page = await browser.newPage();
await page.goto('https://www.scrapingcourse.com/login/cf-turnstile', { waitUntil: 'domcontentloaded' });
await page.locator('input[type="email"]').fill('admin@example.com')
await page.locator('input[type="password"]').fill('password')
// Wait for turnstile to unlock successfully
await page.waitForFunction(() => {
  return window.turnstile && window.turnstile.getResponse();
});
await page.screenshot({ path: 'challenge-bypass-success.png' });
await page.locator('button[type="submit"]').click()
await page.waitForNavigation()
await page.screenshot({ path: 'next-page.png' });
Después de ejecutar este script, podrá observar el efecto de desbloqueo mediante las capturas de pantalla.
Uso del Web Unlocker de Scrapeless para renderizado de JavaScript
Para sitios web protegidos por Cloudflare donde el contenido principal depende de la ejecución de JavaScript en el cliente para cargarse y mostrarse completamente, Scrapeless Web Unlocker ofrece una solución especializada.
La API Universal de Scrapeless permite el renderizado de JavaScript y la interacción dinámica, convirtiéndose en una herramienta eficaz para evadir Cloudflare.
Renderizado de JavaScript
El renderizado de JavaScript admite el manejo de contenido cargado dinámicamente y aplicaciones de una sola página (SPA). Soporta un entorno de navegador completo, gestionando interacciones y requisitos de renderizado más complejos.
Con input.jsRender.enabled=true, utilizaremos el navegador para realizar la solicitud
{
  "actor": "unlocker.webunlocker",
  "input": {
    "url": "https://www.google.com/",
    "jsRender": {
      "enabled": true
    }
  },
  "proxy": {
    "country": "US"
  }
}
Instrucciones de JavaScript
Proporciona un amplio conjunto de instrucciones de JavaScript, permitiendo la interacción dinámica con páginas web.
Estas instrucciones permiten hacer clic en elementos, rellenar formularios, enviarlos o esperar a que aparezcan elementos específicos, ofreciendo flexibilidad para tareas como hacer clic en un botón “Leer más” o enviar un formulario.
{
  "actor": "unlocker.webunlocker",
  "input": {
    "url": "https://example.com",
    "jsRender": {
      "enabled": true,
      "instructions": [
        {
          "waitFor": [
            ".dynamic-content",
            30000
          ]
          // Wait for element
        },
        {
          "click": [
            "#load-more",
            1000
          ]
          // Click element
        },
        {
          "fill": [
            "#search-input",
            "search term"
          ]
          // Fill form
        },
        {
          "keyboard": [
            "press",
            "Enter"
          ]
          // Simulate key press
        },
        {
          "evaluate": "window.scrollTo(0, document.body.scrollHeight)"
          // Execute custom JS
        }
      ]
    }
  }
}
Ejemplo de evasión de desafío
El siguiente ejemplo utiliza axios para enviar una solicitud al servicio Web Unlocker de Scrapeless. Habilita input.jsRender.enabled y utiliza la instrucción waitFor en el parámetro input.jsRender.instructions para esperar a que aparezca un elemento en la página tras superar el desafío de Cloudflare:
import axios from 'axios'

async function sendRequest() {
  const host = "api.scrapeless.com";
  const url = `https://${host}/api/v2/unlocker/request`;
  const API_KEY = 'your_api_key'

  const payload = {
    actor: "unlocker.webunlocker",
    proxy: {
      country: "US"
    },
    input: {
      url: "https://www.scrapingcourse.com/cloudflare-challenge",
      jsRender: {
        enabled: true,
        instructions: [
          {
            waitFor: [
              "main.page-content .challenge-info",
              30000
            ]
          }
        ]
      }
    }
  }

  try {
    const response = await axios.post(url, payload, {
      headers: {
        'Content-Type': 'application/json',
        'x-api-token': API_KEY
      }
    });
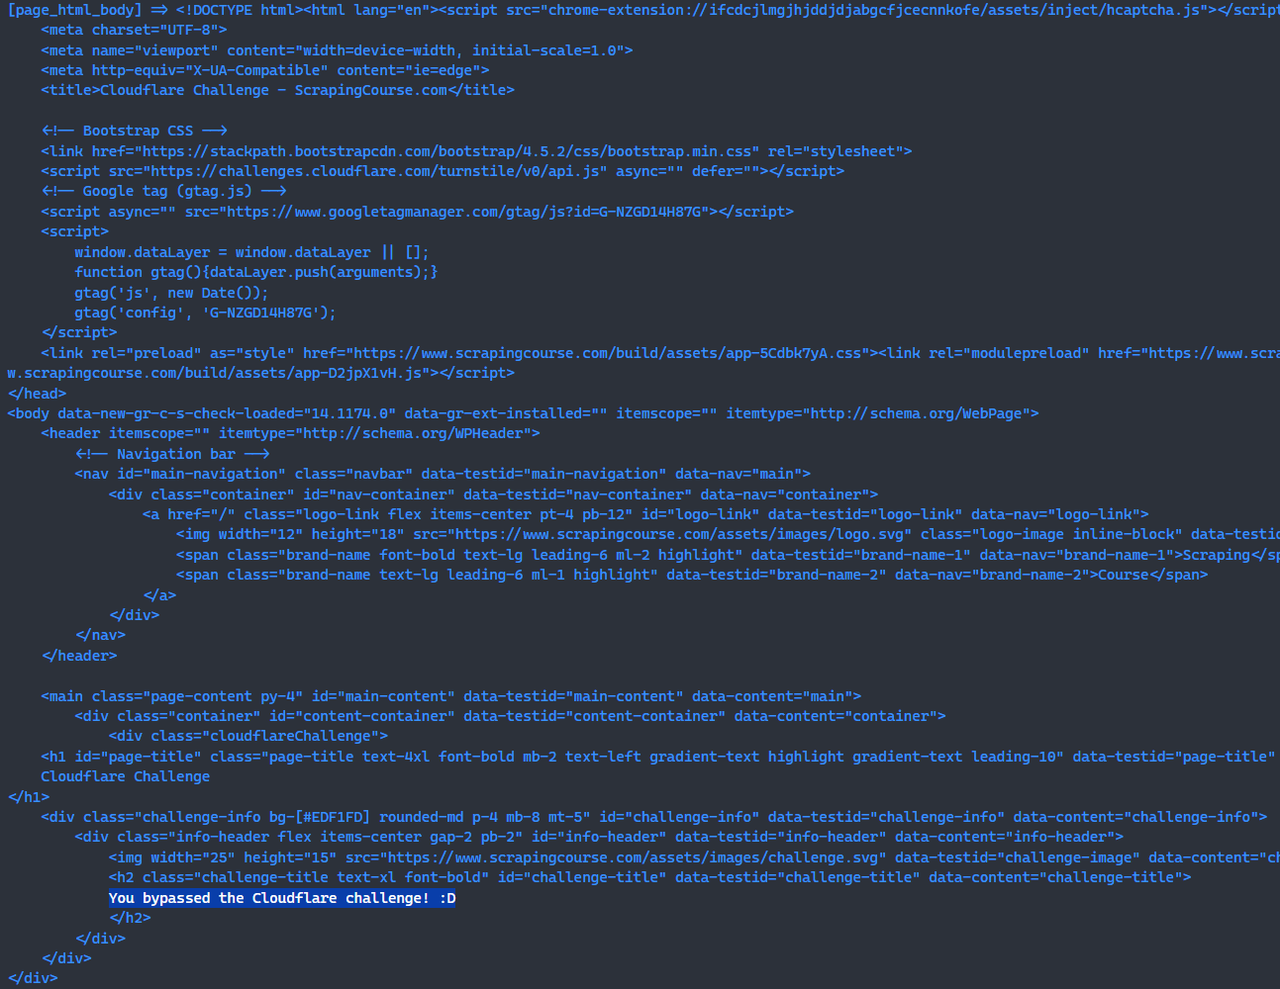
    console.log("[page_html_body] =>", response.data);
  } catch (error) {
    console.error('Error:', error);
  }
}
sendRequest();
Después de ejecutar el script anterior, podrá ver en la consola el HTML de la página que superó correctamente el desafío de Cloudflare.