Descripción general
El Servidor MCP de Scrapeless es la integración oficial del Model Context Protocol para Scrapeless. Brinda a los modelos de lenguaje grandes (LLM), agentes de inteligencia artificial y herramientas nativas de IA —como ChatGPT, Claude, Cursor, Windsurf y cualquier cliente compatible con MCP— acceso en tiempo real a la web a través de un único servidor unificado.
Con un solo servidor, puede:
- Buscar en Google SERP, Trends, Scholar, Vuelos y más
- Extraer cualquier página como HTML, Markdown o captura de pantalla, evitando Cloudflare y otras protecciones anti-bot
- Rastrear sitios completos con profundidad configurable y objetivos de URL específicos
- Automatizar un navegador en la nube escalable: navegar, hacer clic, escribir, desplazarse y extraer datos
Por qué Scrapeless MCP
A diferencia de los servidores MCP de automatización de navegador locales, Scrapeless funciona completamente en la nube, ofreciendo a desarrolladores y agentes de IA escalabilidad y fiabilidad de nivel de producción:
- Sin configuración local — sin binarios de navegador, controladores ni configuración headless que mantener.
- Concurrencia ilimitada — inicie entre 50 y más de 1000 sesiones paralelas con infraestructura de autoescalado.
- Detección anti-bot integrada — reCAPTCHA, Cloudflare Turnstile y AWS WAF gestionados automáticamente.
- Cobertura global de IPs — piscinas ilimitadas de IPs residenciales, ISP y dinámicas en más de 195 países.
- Una sola clave de API — una única clave de Scrapeless desbloquea todos los productos a través del mismo servidor.
Scrapeless MCP frente a navegadores MCP de terceros
Scrapeless MCP es el servidor multi-producto propio de Scrapeless. Es distinto de los servidores MCP de navegador de terceros que se conectan al Scrapeless Cloud Browser como backend:
| Servidor MCP | Tecnologías | Mejor para |
|---|---|---|
| Scrapeless MCP | Servicio en la nube | Búsqueda, extracción de datos, rastreo y automatización de navegadores en todos los productos de Scrapeless desde cualquier cliente MCP. |
| Chrome DevTools MCP | Node.js / Puppeteer | Automatización CI/CD, flujos de trabajo entre IDEs y auditorías detalladas de rendimiento. |
| Playwright MCP | Node.js / Playwright | Automatización determinista basada en el árbol de accesibilidad que resiste cambios menores en la interfaz de usuario. |
Chrome DevTools MCP y Playwright MCP son integraciones que ejecutan un MCP de terceros contra el Scrapeless Cloud Browser. Esta sección documenta el servidor MCP propio de Scrapeless. Consulte Integraciones relacionadas para ver las opciones de terceros.
Qué hay en esta sección
- Inicio rápido — conéctese a un cliente en menos de dos minutos.
- Herramientas por producto — el catálogo completo de herramientas agrupado por Navegador, Rastreo, AI Scraper, Web Unlocker, Scraping API y Proxies.
- Autenticación y transportes — tokens de API más modos Stdio y HTTP transmisible.
- Configuración del cliente — guías paso a paso para Claude, Cursor, Cline, Codex, Windsurf y clientes personalizados.
- Configuración — opciones de sesión, perfil y comportamiento.
Ejemplos destacados
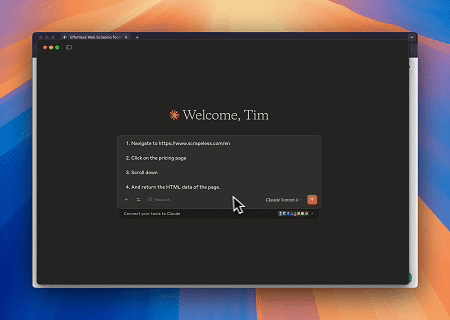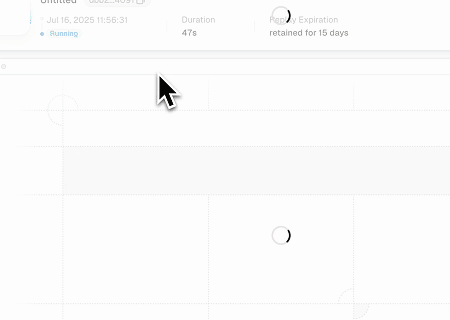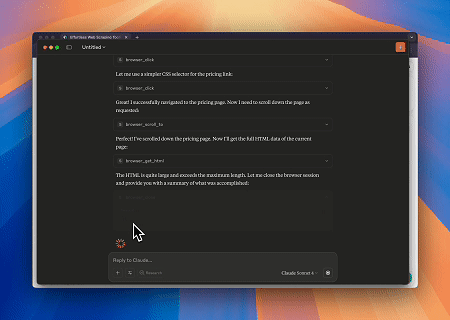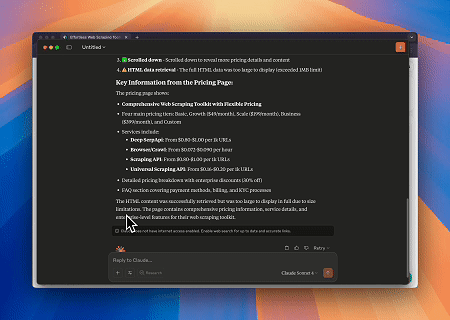
Caso 1: Interacción web y extracción de datos con Claude
Usando el servidor Scrapeless MCP, Claude puede realizar operaciones web complejas —navegación, clics, desplazamiento y extracción de datos— mediante comandos conversacionales, con vista previa en tiempo real de la ejecución a través de sesiones activas.
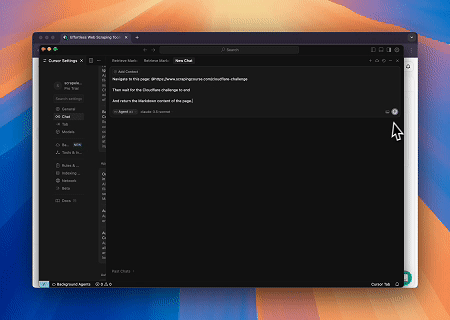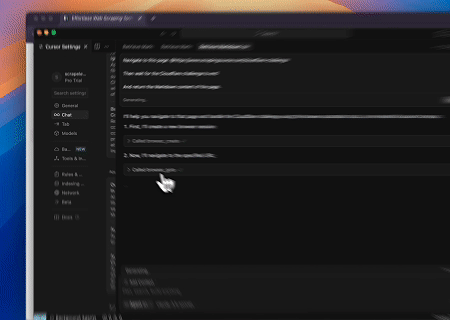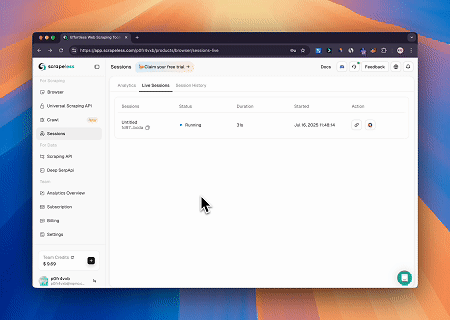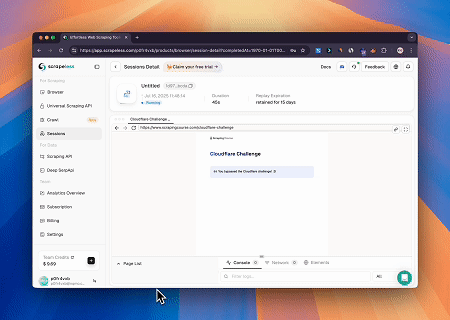
Caso 2: Evitar Cloudflare para recuperar el contenido de la página objetivo
Usando el servidor Scrapeless MCP, se accede automáticamente a páginas protegidas por Cloudflare, y al completarse, se extrae el contenido de la página y se devuelve en formato Markdown.