Representación de JS
La API Web Unlocker es un potente servicio de recuperación de contenido web que admite la representación compleja de páginas web y escenarios de interacción.
Consulte nuestra documentación de la API para obtener contenido detallado.
Estructura de la solicitud
{
  "actor": "unlocker.webunlocker",
  "proxy": {
    "country": "ANY",
    "url": ""
  },
  "input": {
    "url": "string",
    "jsRender": {
      "enabled": true,
      "headless": true,
      "waitUntil": "domcontentloaded",
      "instructions": [],
      "block": {
        "resources": [],
        "urls": []
      },
      "response": {
        "type": "html",
        "options": {}
      }
    }
  }
}
Características principales
Renderizado de JavaScript
La renderizado de JavaScript permite manejar contenido cargado dinámicamente y SPAs (aplicaciones de una sola página). Habilita un entorno de navegador completo, compatible con requisitos más complejos de interacción y renderizado de páginas.
input.jsRender.enabled=true, utilizaremos el navegador para realizar la solicitud.
{
  "actor": "unlocker.webunlocker",
  "proxy": {
    "country": "ANY"
  },
  "input": {
    "url": "https://example.com/",
    "jsRender": {
      "enabled": true
    }
  }
}
Instrucciones de JavaScript
Proporciona un amplio conjunto de instrucciones de JavaScript que le permiten interactuar dinámicamente con páginas web.
Estas instrucciones le permiten hacer clic en elementos, rellenar formularios, enviar formularios o esperar a que aparezcan elementos específicos, brindando flexibilidad para tareas como hacer clic en un botón “leer más” o enviar un formulario.
{
  "actor": "unlocker.webunlocker",
  "input": {
    "url": "https://example.com",
    "jsRender": {
      "enabled": true,
      "instructions": [
        {
          "waitFor": [
            ".dynamic-content",
            30000
          ]
          // Wait for element
        },
        {
          "click": [
            "#load-more",
            1000
          ]
          // Click element
        },
        {
          "fill": [
            "#search-input",
            "search term"
          ]
          // Fill form
        },
        {
          "keyboard": [
            "press",
            "Enter"
          ]
          // Simulate key press
        },
        {
          "evaluate": "window.scrollTo(0, document.body.scrollHeight)"
          // Execute custom JS
        }
      ]
    }
  }
}
A continuación se indican algunas acciones comunes que puede realizar con las instrucciones de JavaScript:
Referencia de instrucciones de JavaScript
| Instrucción | Sintaxis | Descripción | Ejemplo |
|---|---|---|---|
waitFor | [selector, timeout] | Esperar a que aparezca un elemento | {"waitFor": [".content", 30000]} |
click | [selector, delay] | Hacer clic en un elemento | {"click": [".button", 1000]} |
fill | [selector, value] | Rellenar un formulario | {"fill": ["#input", "text"]} |
wait | milliseconds | Tiempo de espera fijo | {"wait": 2000} |
evaluate | javascript code | Ejecutar código JS | {"evaluate": "console.log('test')"} |
keyboard | [action, value, delay?] | Operación de teclado | Consulte la tabla de operaciones de teclado a continuación |
Operaciones de teclado
| Operación | Sintaxis | Descripción | Ejemplo |
|---|---|---|---|
| Presionar tecla | ["press", keyInput] | Presionar una tecla específica keyInput | {"keyboard": ["press", "Enter"]} |
| Escribir texto | ["type", text, delay?] | Escribir texto con retraso opcional | {"keyboard": ["type", "Hello", 20]} |
| Tecla abajo | ["down", key] | Mantener pulsada una tecla | {"keyboard": ["down", "Shift"]} |
| Tecla arriba | ["up", key] | Soltar una tecla | {"keyboard": ["up", "Shift"]} |
Tipos de teclas especiales compatibles: https://pptr.dev/api/puppeteer.keyinput
Tipo de respuesta
Puede especificar el tipo de respuesta mediante el parámetro input.jsRender.response.type, los valores opcionales son:
html | plaintext | markdown | png | jpeg | network | content, siendo el valor predeterminado html:
| type | descripción |
|---|---|
| html | cadena HTML sin formato escapada de la página, compatible con selectores CSS |
| plaintext | cadena de texto plano de la página, compatible con selectores CSS |
| markdown | cadena Markdown escapada de la página, compatible con selectores CSS |
| png | cadena codificada en base64 de la página con formato png , compatible con selectores CSS |
| jpeg | cadena codificada en base64 de la página con formato jpeg , compatible con selectores CSS |
| network | habilitar la captura de solicitudes de red, recopilará todas las solicitudes XHR y fetch realizadas durante la carga de la página y devolverá sus detalles en formato de cadena JSON escapada, no compatible con selectores CSS |
| content | filtrar datos del contenido de la página, devuelve los resultados en formato de cadena JSON escapada |
Los detalles son los siguientes
HTML
Se utiliza para extraer el contenido HTML de una página, lo que funciona mejor para páginas puramente estáticas, y devuelve el contenido en formato de cadena HTML escapada.
Agregue input.jsRender.response.type=html a la solicitud:
const axios = require('axios');
const fs = require('fs');

(async () => {
    const payload = {
        actor: "unlocker.webunlocker",
        proxy: {
            country: "ANY"
        },
        input: {
            url: "https://www.example.com",
            jsRender: {
                enabled: true,
                response: {
                    type: "html"
                }
            }
        }
    };

    const response = await axios.post("https://api.scrapeless.com/api/v2/unlocker/request", payload, {
        headers: {
            "x-api-token": "API Key",
            "Content-Type": "application/json"
        },
        timeout: 60000
    });

    if (response.data?.code === 200) {
        fs.writeFileSync('response.html', response.data.data, 'utf8');
    }
})();Devuelve el contenido de texto en formato HTML.
{
    "code": 200,
    "data": "<!DOCTYPE html><html><head>\n    <title>Example Domain</title>\n\n    <meta charset=\"utf-8\">\n    <meta http-equiv=\"Content-type\" content=\"text/html; charset=utf-8\">\n    <meta name=\"viewport\" content=\"width=device-width, initial-scale=1\">\n    <style type=\"text/css\">\n    body {\n        background-color: #f0f0f2;\n        margin: 0;\n        padding: 0;\n        font-family: -apple-system, system-ui, BlinkMacSystemFont, \"Segoe UI\", \"Open Sans\", \"Helvetica Neue\", Helvetica, Arial, sans-serif;\n        \n    }\n    div {\n        width: 600px;\n        margin: 5em auto;\n        padding: 2em;\n        background-color: #fdfdff;\n        border-radius: 0.5em;\n        box-shadow: 2px 3px 7px 2px rgba(0,0,0,0.02);\n    }\n    a:link, a:visited {\n        color: #38488f;\n        text-decoration: none;\n    }\n    @media (max-width: 700px) {\n        div {\n            margin: 0 auto;\n            width: auto;\n        }\n    }\n    </style>    \n</head>\n\n<body>\n<div>\n    <h1>Example Domain</h1>\n    <p>This domain is for use in illustrative examples in documents. You may use this\n    domain in literature without prior coordination or asking for permission.</p>\n    <p><a href=\"https://www.iana.org/domains/example\">More information...</a></p>\n</div>\n\n\n</body></html>"
}
El contenido de ejemplo del archivo HTML después de guardarlo:
<!DOCTYPE html><html><head>
    <title>Example Domain</title>

    <meta charset="utf-8">
    <meta http-equiv="Content-type" content="text/html; charset=utf-8">
    <meta name="viewport" content="width=device-width, initial-scale=1">
    <style type="text/css">
    body {
        background-color: #f0f0f2;
        margin: 0;
        padding: 0;
        font-family: -apple-system, system-ui, BlinkMacSystemFont, "Segoe UI", "Open Sans", "Helvetica Neue", Helvetica, Arial, sans-serif;

    }
    div {
        width: 600px;
        margin: 5em auto;
        padding: 2em;
        background-color: #fdfdff;
        border-radius: 0.5em;
        box-shadow: 2px 3px 7px 2px rgba(0,0,0,0.02);
    }
    a:link, a:visited {
        color: #38488f;
        text-decoration: none;
    }
    @media (max-width: 700px) {
        div {
            margin: 0 auto;
            width: auto;
        }
    }
    </style>
</head>

<body>
<div>
    <h1>Example Domain</h1>
    <p>This domain is for use in illustrative examples in documents. You may use this
    domain in literature without prior coordination or asking for permission.</p>
    <p><a href="https://www.iana.org/domains/example">More information...</a></p>
</div>

</body></html>
Texto plano
La función de texto plano es una opción de salida que devuelve el contenido extraído en formato de texto sin formato en lugar de HTML o Markdown. Esta función es muy práctica cuando se requiere una versión limpia y sin formato del contenido (libre de cualquier etiqueta HTML o formato Markdown). Simplifica el proceso de extracción de contenido, haciendo que el procesamiento o análisis del texto sea más cómodo.
Agregue input.jsRender.response.type=plaintext a la solicitud:
const axios = require('axios');
const fs = require('fs');

(async () => {
    const payload = {
        actor: "unlocker.webunlocker",
        proxy: {
            country: "ANY"
        },
        input: {
            url: "https://www.example.com",
            jsRender: {
                enabled: true,
                response: {
                    type: "plaintext"
                }
            }
        }
    };

    const response = await axios.post("https://api.scrapeless.com/api/v2/unlocker/request", payload, {
        headers: {
            "x-api-token": "API Key",
            "Content-Type": "application/json"
        },
        timeout: 60000
    });

    if (response.data?.code === 200) {
        fs.writeFileSync('response.txt', response.data.data, 'utf8');
    }
})();Devuelve el contenido de texto plano de la página como una cadena. Vea el ejemplo a continuación.
{
    "code": 200,
    "data": "Example Domain\n\nThis domain is for use in illustrative examples in documents. You may use this domain in literature without prior coordination or asking for permission.\n\nMore information..."
}
El contenido de ejemplo del archivo txt después de guardarlo:
Example Domain

This domain is for use in illustrative examples in documents. You may use this domain in literature without prior coordination or asking for permission.

More information...
Markdown
Para extraer el contenido de una página en formato Markdown, las páginas Markdown puramente estáticas ofrecen los mejores resultados. La API de Web Unlocker devolverá el contenido en formato Markdown, lo que facilita su lectura y procesamiento.
Añada input.jsRender.response.type=markdown a la solicitud:
const axios = require('axios');
const fs = require('fs');

(async () => {
    const payload = {
        actor: "unlocker.webunlocker",
        proxy: {
            country: "ANY"
        },
        input: {
            url: "https://www.example.com",
            jsRender: {
                enabled: true,
                response: {
                    type: "markdown"
                }
            }
        }
    };

    const response = await axios.post("https://api.scrapeless.com/api/v2/unlocker/request", payload, {
        headers: {
            "x-api-token": "API Key",
            "Content-Type": "application/json"
        },
        timeout: 60000
    });

    if (response.data?.code === 200) {
        fs.writeFileSync('response.md', response.data.data, 'utf8');
    }
})();Devuelve el contenido de texto en formato Markdown.
{
    "code": 200,
    "data": "# Example Domain\n\nThis domain is for use in illustrative examples in documents. You may use this domain in literature without prior coordination or asking for permission.\n\n[More information...](https://www.iana.org/domains/example)"
}
El contenido de ejemplo tras guardar un archivo Markdown:
# Example Domain

This domain is for use in illustrative examples in documents. You may use this domain in literature without prior coordination or asking for permission.

[More information...](https://www.iana.org/domains/example)
PNG/JPEG
Puede realizar una captura de pantalla de la página de destino y devolver
una imagen en formato PNG
o JPEG. Cuando el resultado de la respuesta se establece en PNG o JPEG, puede utilizar el parámetro
input.jsRender.response.options.fullPage=true
para especificar si el resultado devuelto es una captura de toda la página.
Al añadir input.jsRender.response.type=png or jpeg a la solicitud:
const axios = require('axios');
const fs = require('fs');

(async () => {
    const payload = {
        actor: "unlocker.webunlocker",
        proxy: {
            country: "ANY"
        },
        input: {
            url: "https://www.example.com",
            jsRender: {
                enabled: true,
                response: {
                    type: "png" // png or jpeg
                }
            }
        }
    };

    const response = await axios.post("https://api.scrapeless.com/api/v2/unlocker/request", payload, {
        headers: {
            "x-api-token": "API Key",
            "Content-Type": "application/json"
        },
        timeout: 60000
    });

    if (response.data?.code === 200) {
        fs.writeFileSync('response.png', Buffer.from(response.data.data, 'base64'));
    }
})();Devuelve una cadena codificada en base64 en formato PNG o JPEG.
{
    "code": 200,
    "data": "JVBERi0xLjQKJdPr6eEKM..."
}
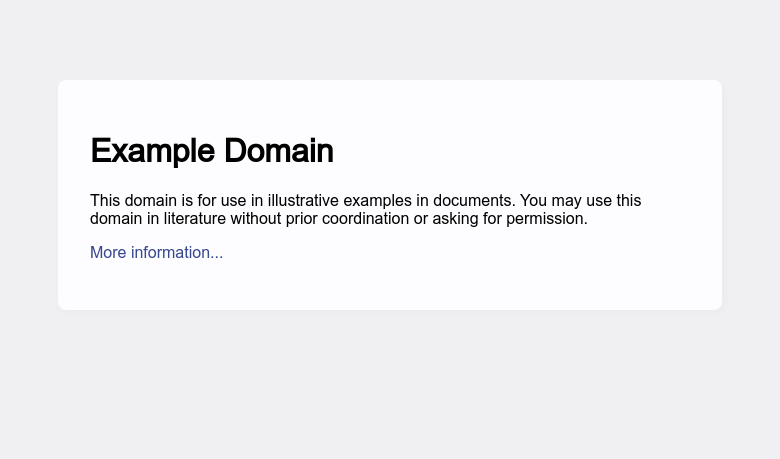
El archivo de ejemplo tras guardarlo en png/jpeg:
Red
Cuando input.jsRender.response.type=network, se capturan todas las solicitudes de red de los tipos XHR y fetch durante
la carga de la página. A continuación, los
datos de las solicitudes de red se devuelven como una cadena JSON con caracteres de escape. Estos datos de respuesta incluyen la URL, el método
de la solicitud, el código de estado de la respuesta, los encabezados, el cuerpo de la respuesta, etc.
Si el cuerpo de la solicitud o de la respuesta contiene contenido binario, un cuerpo de respuesta demasiado grande o datos no textuales, el contenido
original no se devolverá directamente. En su lugar, se marca con la cadena de marcador de posición [Preview not available ...]
. Puede filtrar los resultados por URL, método de solicitud y código de estado utilizando
input.jsRender.response.options
como parámetro.
const axios = require('axios');
const fs = require('fs');

(async () => {
    const payload = {
        actor: "unlocker.webunlocker",
        proxy: {
            country: "ANY"
        },
        input: {
            url: "https://www.example.com",
            jsRender: {
                enabled: true,
                response: {
                    type: "network",
                    options: {
                        "urls": [
                            "/example"
                        ],
                        "status": [
                            200
                        ],
                        "methods": [
                            "get"
                        ]
                    }
                }
            }
        }
    };

    const response = await axios.post("https://api.scrapeless.com/api/v2/unlocker/request", payload, {
        headers: {
            "x-api-token": "API Key",
            "Content-Type": "application/json"
        },
        timeout: 60000
    });

    if (response.data?.code === 200) {
        fs.writeFileSync('response.json', response.data.data, 'utf8');
    }
})();Devuelve datos con cadena JSON con caracteres escapados:
{
    "code": 200,
    "data": "[{\"url\":\"https://www.tiktok.com/api/explore/item_list/...]"
}
El resultado JSON de ejemplo será así:
[
{
"url": "https://www.tiktok.com/api/explore/item_list/?WebIdLastTime=1752724401&aid=1988&app_language=en&app_name=tiktok_web&browser_language=en&browser_name=Mozilla&browser_online=true&browser_platform=Win32&browser_version=5.0%20%28Windows%20NT%2010.0%3B%20Win64%3B%20x64%29%20AppleWebKit%2F537.36%20%28KHTML%2C%20like%20Gecko%29%20Chrome%2F135.0.0.0%20Safari%2F537.36&categoryType=120&channel=tiktok_web&clientABVersions=70508271%2C73485602%2C73547759%2C73720540%2C73810951%2C73814854%2C73848867%2C73866686%2C73944035%2C73969557%2C73990102%2C74048200%2C74129613%2C74148345%2C74157215%2C74163128%2C74176097%2C74195789%2C74213192%2C74241848%2C70405643%2C71057832%2C71200802%2C72361743%2C73171280%2C73208420&cookie_enabled=true&count=8&data_collection_enabled=false&device_id=7527893946556515853&device_platform=web_pc&enable_cache=true&focus_state=true&history_len=2&is_fullscreen=false&is_page_visible=true&language=en&odinId=7527893969448764429&os=windows&priority_region=&referer=®ion=US&screen_height=1440&screen_width=3440&tz_name=America%2FNew_York&user_is_login=false&webcast_language=en",
"method": "GET",
"resourceType": "fetch",
"status": 200,
"timestamp": 1752724403206,
"payload": null,
"requestReaders": {
"sec-ch-ua-platform": "\"Windows\"",
"referer": "https://www.tiktok.com/explore",
"user-agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/135.0.0.0 Safari/537.36",
"sec-ch-ua": "\"Google Chrome\";v=\"135\", \"Not-A.Brand\";v=\"8\", \"Chromium\";v=\"135\"",
"sec-ch-ua-mobile": "?0",
"accept": "*/*",
"cookie": "tt_csrf_token=KO5LUsj8-r2G0Lcbmx_RqngSiFd_VRcPiaeY; ttwid=1%7CQapzXhCnEqiLXypjvNK3iX65g9iXPk_Jpj4GGLdqNRY%7C1752724401%7Cfb5daf3940529652ba613376c011e990b0afede828ad52c4e0c14f1c422bea61; tt_chain_token=jIGTF0ppLEuXKFGayjhpyg=="
},
"responseHeaders": {
"access-control-expose-headers": "x-tt-traceflag,x-tt-logid",
"bd-tt-error-code": "0",
"cache-control": "max-age=1800, must-revalidate",
"content-encoding": "br",
"content-length": "30900",
"content-type": "application/json; charset=utf-8",
"date": "Thu, 17 Jul 2025 03:53:23 GMT",
"expires": "Thu, 17 Jul 2025 03:53:23 GMT",
"pragma": "no-cache",
"server": "nginx",
"server-timing": "cdn-cache; desc=HIT, edge; dur=0, origin; dur=0\ninner; dur=387",
"tt_stable": "1",
"x-akamai-request-id": "42a8e99d",
"x-cache": "TCP_MEM_HIT from a23-47-221-69.deploy.akamaitechnologies.com (AkamaiGHost/22.2.0-c471f2b4819e3aa253dfcc21bfdfd452) (-)",
"x-ms-token": "YAOuylbpReZ5gTM1PP8mwsmWMCxWprQ4oHRNuZQgKsADY7HTftSBu6W9raVm6PKyp-1mXt9Q6CIs0BHLRxozI_uNNEOWSvkaxFyunXX-54aBUvkuHBe2id6bY0cB",
"x-tt-logid": "20250717035100C13E2314287BF101E7D9",
"x-tt-trace-host": "0102b37aa413a15dcf9191a3f676ab4b78d5ba03a6d109c921ad21a607e80d7a40dbc340eb8c009458e52488a06a1b874047a91b63eb21ce08d01175dca60742a8bdf12f766710e93ed82ca68be07bf95a053639c5cedca212d37246317d611b65",
"x-tt-trace-id": "00-250717035100C13E2314287BF101E7D9-729F56051B790290-00",
"x-tt-trace-tag": "id=16;cdn-cache=hit;type=static"
},
"responseBody": {
"data": "omitted"
},
"responseSize": 249297,
"error": null
}
]Contenido
Cuando input.jsRender.response.type=content, se filtran los datos con formato JSON del contenido de la página; la respuesta se devuelve
siempre como una cadena
JSON. Mediante input.jsRender.response.options.outputs puede definir con precisión qué tipos de datos
extraer del contenido recopilado de la página, lo que permite
obtener de manera eficiente únicamente la información necesaria. De este modo, puede reducir el tiempo de procesamiento y centrarse en los
datos más relevantes para su caso de uso.
Se devolverán todas las salidas si input.jsRender.response.options.outputs está vacío. Las opciones de salida incluyen:
phone_numbers, headings, images, audios, videos, links, menus, hashtags, emails, metadata, tables,
favicon.
Para uso detallado, revise el código a continuación.
const axios = require('axios');
const fs = require('fs');

(async () => {
    // Configuration
    const url = "https://api.scrapeless.com/api/v2/unlocker/request";
    const token = "API Key";

    const headers = {"x-api-token": token, "Content-Type": "application/json"};

    const payload = {
        actor: "unlocker.webunlocker",
        proxy: {
            country: "ANY"
        },
        input: {
            url: "https://www.example.com",
            jsRender: {
                enabled: true,
                response: {
                    type: "content",
                    options: {
                        outputs: [
                            "phone_numbers",
                            "headings",
                            "images",
                            "audios",
                            "videos",
                            "links",
                            "menus",
                            "hashtags",
                            "emails",
                            "metadata",
                            "tables",
                            "favicon"
                        ]
                    }
                }
            }
        }
    };

    try {
        const response = await axios.post(url, payload, {headers, timeout: 60000});

        if (response.status !== 200) {
            throw newError(`HTTP Error: ${response.status}`);
        }

        const data = response.data;
        if (data.code !== 200) {
            throw newError(`API Error: ${data}`);
        }

        const content = data.data || '';

        // Save and return result
        fs.writeFileSync('response.json', content, 'utf8');
        console.log('✅ Success! Content saved as response.json');

        returnJSON.parse(content);

    } catch (error) {
        console.error('❌ Error:', error.message);
        throw error;
    }
})()Aquí hay algunos ejemplos:
Correos electrónicos
Utilice selectores CSS y expresiones regulares para extraer direcciones de correo electrónico con formato estándar, como example@example.com.
{
    "code": 200,
    "data": "{\"emails\":[\"market@scrapeless.com\"]}"
}
Números de teléfono
Utilice selectores CSS y expresiones regulares para extraer números de teléfono, centrándose en los enlaces que contienen tel:
como protocolo.
ejemplo:outputs=phone_numbers
{
    "code": 200,
    "data": "{ \"phone_numbers\": [ \"+1-111-111-111\" ] }"
}
Encabezados
Extraiga el texto de los encabezados desde H1 hasta H6 en HTML.
ejemplo:outputs=headings
{
    "code": 200,
    "data": "{\"headings\":[\"Example Domain\"]}"
}
Imágenes
Extraiga de las etiquetas img las fuentes de imagen. Devuelva src como único atributo.
ejemplo:outputs=images
{
    "code": 200,
    "data": "{\"images\":[\"https://www.scrapeless.com/_next/image?url=%2Fassets%2Fimages%2Ftoolkit%2Flight%2Fimg-2.png&w=750&q=100\"]}"
}
Audios
Extraiga las fuentes de audio de los elementos source contenidos en las etiquetas audio y devuelva únicamente src como atributo.
ejemplo: outputs=audios
{
    "code": 200,
    "data": "{\"audios\":[\"https://example.com/audio.mp3\"]}"
}
Vídeos
Extraiga las fuentes de video de los elementos source dentro de las etiquetas video . Devuelva únicamente el atributo src .
ejemplo: outputs=videos
{
    "code": 200,
    "data": "{\"videos\":[\"https://example.com/video.mp4\"]}"
}
Enlaces
Extraiga las URLs de las etiquetas a . Devuelva únicamente el atributo href .
ejemplo: outputs=links
{
    "code": 200,
    "data": "{\"links\":[\"https://app.scrapeless.com/landing/guide\",\"https://www.scrapeless.com/en\",\"https://www.scrapeless.com/en/pricing\",\"https://docs.scrapeless.com/\",\"https://backend.scrapeless.com/app/api\",\"https://www.producthunt.com/posts/scrapeless-deep-serpapi\",\"https://www.g2.com/products/scrapeless/reviews\",\"https://www.trustpilot.com/review/scrapeless.com\",\"https://slashdot.org/software/p/Scrapeless/\",\"https://tekpon.com/software/scrapeless/reviews/\",\"https://www.scrapeless.com/en/product/deep-serp-api\",\"https://www.scrapeless.com/en/product/scraping-browser\",\"https://www.scrapeless.com/en/product/scraping-api\",\"https://www.scrapeless.com/en/product/universal-scraping-api\",\"https://www.scrapeless.com/en/solutions/e-commerce\",\"https://www.scrapeless.com/en/solutions/seo\",\"https://www.scrapeless.com/en/solutions/real-estate\",\"https://www.scrapeless.com/en/solutions/travel-hotel-airline\",\"https://www.scrapeless.com/en/solutions/social-media\",\"https://www.scrapeless.com/en/solutions/market-research\",\"https://www.scrapeless.com/en/blog\",\"https://www.scrapeless.com/en/blog/deep-serp-api-online\",\"https://www.scrapeless.com/en/blog/scrapeless-web-scraping-toolkit\",\"https://www.scrapeless.com/en/blog/google-shopping-scrape\",\"https://backend.scrapeless.com/app/api/v1/public/links/github\",\"https://backend.scrapeless.com/app/api/v1/public/links/youtube\",\"mailto:market@scrapeless.com\",\"https://www.scrapeless.com/en/ai-agent\",\"https://browserless.scrapeless.com/\",\"https://www.scrapeless.com/en/solutions/temu\",\"https://www.scrapeless.com/en/solutions/walmart\",\"https://www.scrapeless.com/en/solutions/shopee\",\"https://www.scrapeless.com/en/solutions/lazada\",\"https://www.scrapeless.com/en/solutions/amazon\",\"https://www.scrapeless.com/en/solutions/google-trends\",\"https://www.scrapeless.com/en/solutions/google-search\",\"https://www.scrapeless.com/en/solutions/airbnb\",\"https://www.scrapeless.com/en/solutions/scoot\",\"https://www.scrapeless.com/en/solutions/latam\",\"https://www.scrapeless.com/en/solutions/localiza\",\"https://www.scrapeless.com/en/solutions/tiktok\",\"https://www.scrapeless.com/en/solutions/instagram\",\"https://www.scrapeless.com/en/integration\",\"https://www.scrapeless.com/en/faq\",\"https://www.scrapeless.com/en/glossary\",\"https://www.scrapeless.com/en/legal/privacy-policy\",\"https://www.scrapeless.com/en/legal/terms\",\"https://www.scrapeless.com/en/legal/terms#refund-policy\",\"https://www.scrapeless.com/en/legal/check-your-data\",\"https://backend.scrapeless.com/app/api/v1/public/links/discord\"]}"
}
Menús
Extraiga los elementos del menú de los elementos li dentro de las etiquetas de menú.
ejemplo: outputs=menus
{
    "code": 200,
    "data": "{\"links\":[ \"Coffee\", \"Tea\", \"Milk\" ]}"
}
Hashtags
Extraiga formatos de hashtags utilizando expresiones regulares para coincidir con patrones típicos de hashtags, como #example.
ejemplo: outputs = hashtags
{
    "code": 200,
    "data": "{\"hashtags\":[\"#docsearch\",\"#search\"]}"
}
Metadatos
Extraiga la información meta de las etiquetas meta en la sección head , devolviendo los atributos name y content en el formato
name: content.
ejemplo: outputs=metadata
{
    "code": 200,
    "data": "{\"metadata\":[\"viewport: width=device-width, initial-scale=1\",\"description: Scrapeless is the best full-stack web scraping toolkit offering Scraping API, Agent Browser\"]}"
}
Tablas
Extraiga datos de elementos de tabla y devuelva los datos de la tabla en formato JSON, incluyendo dimensiones, encabezados y contenido.
ejemplo: outputs=tables
{
    "code": 200,
    "data": "{\"tables\":[{\"dimensions\":{\"rows\":7,\"columns\":3,\"heading\":true},\"heading\":[\"Company\",\"Contact\",\"Country\"],\"content\":[{\"Company\":\"Alfreds Futterkiste\",\"Contact\":\"Maria Anders\",\"Country\":\"Germany\"},{\"Company\":\"Centro comercial Moctezuma\",\"Contact\":\"Francisco Chang\",\"Country\":\"Mexico\"},{\"Company\":\"Ernst Handel\",\"Contact\":\"Roland Mendel\",\"Country\":\"Austria\"},{\"Company\":\"Island Trading\",\"Contact\":\"Helen Bennett\",\"Country\":\"UK\"},{\"Company\":\"Laughing Bacchus Winecellars\",\"Contact\":\"Yoshi Tannamuri\",\"Country\":\"Canada\"},{\"Company\":\"Magazzini Alimentari Riuniti\",\"Contact\":\"Giovanni Rovelli\",\"Country\":\"Italy\"}]},{\"dimensions\":{\"rows\":11,\"columns\":2,\"heading\":true},\"heading\":[\"Tag\",\"Description\"],\"content\":[{\"Tag\":\"<table>\",\"Description\":\"Defines a table\"},{\"Tag\":\"<th>\",\"Description\":\"Defines a header cell in a table\"},{\"Tag\":\"<tr>\",\"Description\":\"Defines a row in a table\"},{\"Tag\":\"<td>\",\"Description\":\"Defines a cell in a table\"},{\"Tag\":\"<caption>\",\"Description\":\"Defines a table caption\"},{\"Tag\":\"<colgroup>\",\"Description\":\"Specifies a group of one or more columns in a table for formatting\"},{\"Tag\":\"<col>\",\"Description\":\"Specifies column properties for each column within a <colgroup> element\"},{\"Tag\":\"<thead>\",\"Description\":\"Groups the header content in a table\"},{\"Tag\":\"<tbody>\",\"Description\":\"Groups the body content in a table\"},{\"Tag\":\"<tfoot>\",\"Description\":\"Groups the footer content in a table\"}]}]}"
}
Favicon
Extraiga la URL del favicon del elemento link en la sección HTML head .
ejemplo: outputs=favicon
{
    "code": 200,
    "data": "{\"favicon\":\"https://www.scrapeless.com/favicon.ico\"}"
}
Control de recursos
Sistema de control de carga de recursos para optimizar el rendimiento y el uso del ancho de banda.
{
  "actor": "unlocker.webunlocker",
  "proxy": {
    "country": "ANY",
    "url": ""
  },
  "input": {
    "url": "string",
    "jsRender": {
      "enabled": true,
      "block": {
        "resources": [
          "Image",
          "Font",
          "Stylesheet",
          "Script"
        ],
        "urls": [
          // Optional, URL pattern-based blocking
          "*.analytics.com/*",
          "*/ads/*"
        ]
      }
    }
  }
}
Referencia completa de tipos de recursos:
| Tipo de recurso | Descripción | Impacto |
|---|---|---|
Document | Documento principal y iframes | Contenido principal de la página |
Stylesheet | Archivos CSS | Estilos y diseño de la página |
Image | Imágenes e iconos | Contenido visual |
Media | Recursos de audio y video | Contenido multimedia |
Font | Fuentes web | Representación de texto |
Script | Archivos JavaScript | Funcionalidad de la página |
TextTrack | Subtítulos y subtítulos para videos | Accesibilidad multimedia |
XHR | Llamadas XMLHttpRequest | Solicitudes asíncronas heredadas |
Fetch | Solicitudes de la API Fetch | Solicitudes asíncronas modernas |
Prefetch | Recursos prefijados | Optimización de rendimiento |
EventSource | Eventos enviados por el servidor | Actualizaciones en tiempo real |
WebSocket | Conexiones WebSocket | Comunicación bidireccional |
Manifest | Manifiestos de aplicaciones web | Configuración de PWA |
SignedExchange | Intercambios HTTP firmados | Autenticidad del contenido |
Ping | Solicitudes de ping | Analíticas y seguimiento |
CSPViolationReport | Informes de violaciones de CSP | Supervisión de seguridad |
Preflight | Solicitudes previas CORS | Seguridad entre orígenes |
Other | Recursos no clasificados | Varios |
Ejemplo de uso:
{
  "actor": "unlocker.webunlocker",
  "proxy": {
    "country": "ANY",
    "url": ""
  },
  "input": {
    "url": "string",
    "jsRender": {
      "enabled": true,
      "block": {
        "resources": [
          "Image",
          "Font",
          "Stylesheet",
          "Script",
          "Media",
          "Ping",
          "Prefetch"
        ]
      }
    }
  }
}
Buenas prácticas para el bloqueo de recursos:
-
Optimización del rendimiento
- Utilice el bloqueo de recursos con criterio; bloquee recursos no esenciales para una carga más rápida
- Considere bloquear
PrefetchyPingpara reducir el uso de la red - Mantenga
Documenty recursos críticosScriptdesbloqueados
-
Gestión del ancho de banda
- Bloquee
ImageyMediaen páginas que consuman mucho ancho de banda - Considere bloquear
Fontpara usar fuentes del sistema en su lugar
- Bloquee
-
Mejora de la estabilidad
- Implemente mecanismos de reintento de solicitudes
- Agregue lógica de manejo de errores
- Utilice
waitForen lugar dewaitfijos
-
Eficiencia en el uso de recursos
- Cargue recursos bajo demanda
- Cierre conexiones innecesarias de inmediato
Nota: Las cadenas de tipo de recurso distinguen entre mayúsculas y minúsculas. Use coincidencias exactas como se muestra en la tabla de referencia.