Crawl4AI
Crawl4AI es una herramienta de rastreo y extracción de datos web de código abierto diseñada para integrarse perfectamente con Modelos de Lenguaje Grande (LLMs), Agentes de IA y tuberías de datos. Permite la extracción de datos en tiempo real y a alta velocidad, manteniéndose flexible y fácil de implementar.
Las características clave para la extracción de datos impulsada por IA incluyen:
- Diseñado para LLMs: Genera Markdown estructurado optimizado para la generación aumentada por recuperación (RAG) y el ajuste fino.
- Control flexible del navegador: Admite gestión de sesiones, uso de proxies y ganchos personalizados.
- Inteligencia heurística: Utiliza algoritmos inteligentes para optimizar el análisis de datos.
- Totalmente de código abierto: No requiere clave de API; se puede implementar mediante Docker y plataformas en la nube.
Más información en la documentación oficial.
¿Por qué usar Scrapeless con Crawl4AI?
Crawl4AI destaca en la extracción estructurada de datos web y admite análisis impulsado por LLM y extracción basada en patrones. Sin embargo, aún puede enfrentar desafíos al tratar con mecanismos avanzados anti-bot, como:
- Navegadores locales bloqueados por Cloudflare, AWS WAF o reCAPTCHA
- Cuellos de botella de rendimiento durante rastreos concurrentes a gran escala, con inicio lento del navegador
- Procesos complejos de depuración que dificultan el seguimiento de problemas
El Navegador en la Nube Scrapeless resuelve perfectamente estos inconvenientes:
- Salto de un clic sobre protecciones anti-bot: Maneja automáticamente reCAPTCHA, Cloudflare Turnstile/Challenge, AWS WAF y más. Combinado con la potencia de extracción estructurada de Crawl4AI, aumenta significativamente las tasas de éxito.
- Escalado ilimitado concurrente: Lanza 50–1000+ instancias de navegador por tarea en segundos, eliminando los límites de rendimiento del rastreo local y maximizando la eficiencia de Crawl4AI.
- Reducción de costos del 40%–80%: En comparación con servicios en la nube similares, los costos totales se reducen al 20%–60%. El modelo de pago por uso lo hace asequible incluso para proyectos pequeños.
- Herramientas visuales de depuración: Utilice Reproducción de Sesión y Supervisión en Vivo de URL para observar tareas de Crawl4AI en tiempo real, identificar rápidamente las causas de fallo y reducir la sobrecarga de depuración.
- Integración sin costo: Compatible nativamente con Playwright (utilizado por Crawl4AI), requiriendo solo una línea de código para conectar Crawl4AI a la nube; no se necesita refactorización de código.
- Servicio de Nodos de Borde (ENS): Varios nodos globales ofrecen velocidad y estabilidad de inicio 2–3× más rápido que otros navegadores en la nube, acelerando la ejecución de Crawl4AI.
- Entornos aislados y sesiones persistentes: Cada perfil de Scrapeless se ejecuta en su propio entorno con inicio de sesión persistente y aislamiento de identidad, evitando interferencias entre sesiones y mejorando la estabilidad a gran escala.
- Gestión flexible de huellas digitales: Scrapeless puede generar huellas digitales de navegador aleatorias o usar configuraciones personalizadas, reduciendo efectivamente los riesgos de detección y mejorando la tasa de éxito de Crawl4AI.
Inicio rápido
1. Obtenga su clave de API de Scrapeless
Inicie sesión en Scrapeless y obtenga su Token de API.
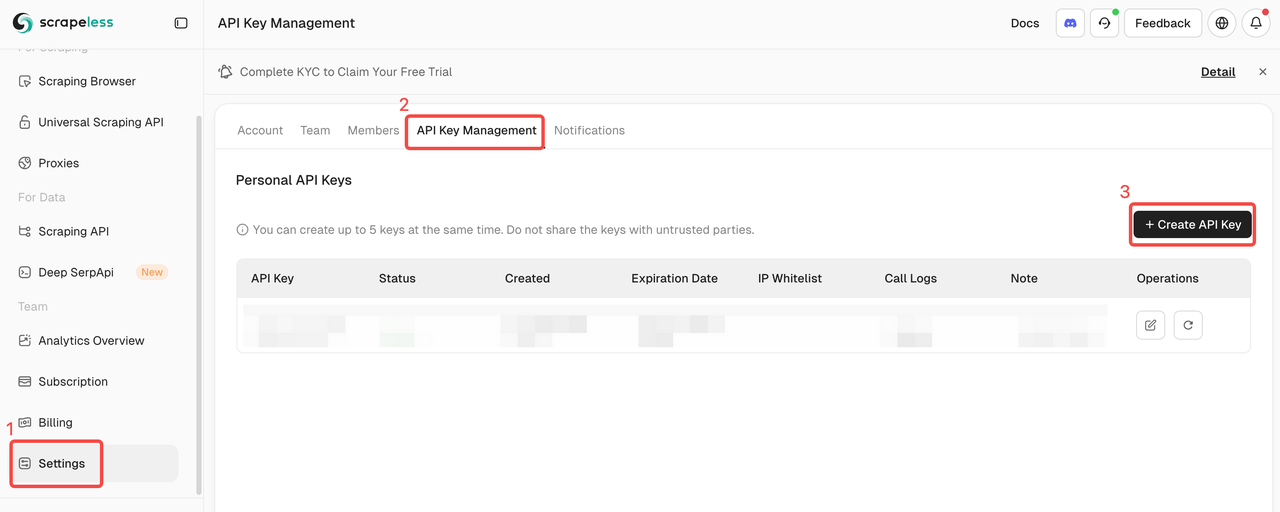
2. Inicio rápido
El ejemplo siguiente muestra cómo conectar rápida y fácilmente Crawl4AI al Navegador en la Nube Scrapeless:
Para más funciones e instrucciones detalladas, consulte la introducción.
scrapeless_params = {
    "token": "get your token from https://www.scrapeless.com",
    "sessionName": "Scrapeless browser",
    "sessionTTL": 1000,
}

query_string = urlencode(scrapeless_params)
scrapeless_connection_url = f"wss://browser.scrapeless.com/api/v2/browser?{query_string}"

AsyncWebCrawler(
    config=BrowserConfig(
        headless=False,
        browser_mode="cdp",
        cdp_url=scrapeless_connection_url
    )
)
Después de la configuración, Crawl4AI se conecta al Navegador en la Nube Scrapeless mediante el modo CDP (Protocolo Chrome DevTools) , permitiendo la extracción de datos web sin necesidad de un entorno de navegador local. Los usuarios pueden configurar además proxies, huellas digitales, reutilización de sesionesy otras características para satisfacer las demandas de escenarios con alta concurrencia y mecanismos anti-bot complejos.
3. Rotación automática global de proxies
Scrapeless admite IPs residenciales en 195 países. Los usuarios pueden configurar la región objetivo usando proxycountry, permitiendo que las solicitudes se envíen desde ubicaciones específicas. Las IPs se rotan automáticamente, evitando eficazmente bloqueos.
import asyncio
from urllib.parse import urlencode
from crawl4ai import CrawlerRunConfig, BrowserConfig, AsyncWebCrawler

async def main():
    scrapeless_params = {
        "token": "your token",
        "sessionTTL": 1000,
        "sessionName": "Proxy Demo",
# Sets the target country/region for the proxy, sending requests via an IP address from that region. You can specify a country code (e.g., US for the United States, GB for the United Kingdom, ANY for any country). See country codes for all supported options."proxyCountry": "ANY",
    }
    query_string = urlencode(scrapeless_params)
    scrapeless_connection_url = f"wss://browser.scrapeless.com/api/v2/browser?{query_string}"async with AsyncWebCrawler(
        config=BrowserConfig(
            headless=False,
            browser_mode="cdp",
            cdp_url=scrapeless_connection_url,
        )
    ) as crawler:
        result = await crawler.arun(
            url="https://www.scrapeless.com/en",
            config=CrawlerRunConfig(
                wait_for="css:.content",
                scan_full_page=True,
            ),
        )
        print("-" * 20)
        print(f'Status Code: {result.status_code}')
        print("-" * 20)
        print(f'Title: {result.metadata["title"]}')
        print(f'Description: {result.metadata["description"]}')
        print("-" * 20)
asyncio.run(main())
4. Huellas digitales personalizadas del navegador
Para imitar el comportamiento de usuarios reales, Scrapeless admite huellas digitales de navegador generadas aleatoriamente y también permite parámetros de huella digital personalizados. Esto reduce eficazmente el riesgo de ser detectado por sitios web objetivo.
import json
import asyncio
from urllib.parse import quote, urlencode
from crawl4ai import CrawlerRunConfig, BrowserConfig, AsyncWebCrawler

async def main():
# customize browser fingerprint
    fingerprint = {
        "userAgent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/134.1.2.3 Safari/537.36",
        "platform": "Windows",
        "screen": {
            "width": 1280, "height": 1024
        },
        "localization": {
            "languages": ["zh-HK", "en-US", "en"], "timezone": "Asia/Hong_Kong",
        }
    }

    fingerprint_json = json.dumps(fingerprint)
    encoded_fingerprint = quote(fingerprint_json)

    scrapeless_params = {
        "token": "your token",
        "sessionTTL": 1000,
        "sessionName": "Fingerprint Demo",
        "fingerprint": encoded_fingerprint,
    }
    query_string = urlencode(scrapeless_params)
    scrapeless_connection_url = f"wss://browser.scrapeless.com/api/v2/browser?{query_string}"async with AsyncWebCrawler(
        config=BrowserConfig(
            headless=False,
            browser_mode="cdp",
            cdp_url=scrapeless_connection_url,
        )
    ) as crawler:
        result = await crawler.arun(
            url="https://www.scrapeless.com/en",
            config=CrawlerRunConfig(
                wait_for="css:.content",
                scan_full_page=True,
            ),
        )
        print("-" * 20)
        print(f'Status Code: {result.status_code}')
        print("-" * 20)
        print(f'Title: {result.metadata["title"]}')
        print(f'Description: {result.metadata["description"]}')
        print("-" * 20)
asyncio.run(main())
5. Reutilización de perfiles
Scrapeless asigna a cada perfil su propio entorno de navegador independiente, permitiendo inicios de sesión persistentes y aislamiento de identidad. Los usuarios simplemente pueden proporcionar el profileId para reutilizar una sesión anterior.
import asyncio
from urllib.parse import urlencode
from crawl4ai import CrawlerRunConfig, BrowserConfig, AsyncWebCrawler

async def main():
    scrapeless_params = {
        "token": "your token",
        "sessionTTL": 1000,
        "sessionName": "Profile Demo",
        "profileId": "your profileId",# create profile on scrapeless
    }
    query_string = urlencode(scrapeless_params)
    scrapeless_connection_url = f"wss://browser.scrapeless.com/api/v2/browser?{query_string}"async with AsyncWebCrawler(
        config=BrowserConfig(
            headless=False,
            browser_mode="cdp",
            cdp_url=scrapeless_connection_url,
        )
    ) as crawler:
        result = await crawler.arun(
            url="https://www.scrapeless.com",
            config=CrawlerRunConfig(
                wait_for="css:.content",
                scan_full_page=True,
            ),
        )
        print("-" * 20)
        print(f'Status Code: {result.status_code}')
        print("-" * 20)
        print(f'Title: {result.metadata["title"]}')
        print(f'Description: {result.metadata["description"]}')
        print("-" * 20)
asyncio.run(main())