Crawl4AI
Crawl4AI एक ओपन-सोर्स वेब क्रॉलिंग और स्क्रैपिंग उपकरण है जिसे बड़े भाषा मॉडल (LLMs), एआई एजेंट्स और डेटा पाइपलाइन्स के साथ चिकनी तरह से एकीकृत करने के लिए डिज़ाइन किया गया है। यह उच्च गति, वास्तविक समय डेटा निकासी को सक्षम करता है जबकि लचीला और तैनात करने में आसान बना रहता है।
एआई-संचालित वेब स्क्रैपिंग के लिए प्रमुख विशेषताएँ शामिल हैं:
- LLMs के लिए बनाया गया: RAG (पुनर्प्राप्ति-वर्धित उत्पन्न) और फाइन-ट्यूनिंग के लिए अनुकूलित संरचित मार्कडाउन उत्पन्न करता है।
- लचीला ब्राउज़र नियंत्रण: सत्र प्रबंधन, प्रॉक्सी उपयोग और कस्टम हुक्स का समर्थन करता है।
- ह्यूरिस्टिक बुद्धिमत्ता: डेटा पार्सिंग को अनुकूलित करने के लिए स्मार्ट एल्गोरिदम का उपयोग करता है।
- पूरी तरह ओपन-सोर्स: कोई API कुंजी की आवश्यकता नहीं है; डॉकर और क्लाउड प्लेटफॉर्म के माध्यम से तैनात करने योग्य।
आधिकारिक प्रलेखन में अधिक जानें।
Crawl4AI के साथ Scrapeless का उपयोग क्यों करें?
Crawl4AI संरचित वेब डेटा निकासी में उत्कृष्ट है और एलएलएम-संचालित पार्सिंग और पैटर्न-आधारित स्क्रैपिंग का समर्थन करता है। हालांकि, उन्नत एंटी-बॉट तंत्र जैसे निम्नलिखित के सामने आने पर यह अभी भी चुनौतियों का सामना कर सकता है:
- Cloudflare, AWS WAF, या reCAPTCHA द्वारा ब्लॉक किए जा रहे स्थानीय ब्राउज़र
- बड़े पैमाने पर एक साथ क्रॉलिंग के दौरान प्रदर्शन की समस्याएँ, धीमी ब्राउज़र स्टार्टअप के साथ
- मुश्किल ट्रैकिंग के लिए जटिल डिबगिंग प्रक्रियाएँ
Scrapeless Cloud Browser इन समस्याओं को पूरी तरह से हल करता है:
- एक-क्लिक एंटी-बॉट बायपास: स्वचालित रूप से reCAPTCHA, Cloudflare Turnstile/Challenge, AWS WAF और अन्य को संभालता है। Crawl4AI की संरचित निष्कर्षण शक्ति के साथ संयोजित होने पर यह सफलता की दर में काफी वृद्धि करता है।
- असीमित समवर्ती स्केलिंग: कुछ ही सेकंड में प्रति कार्य 50–1000+ ब्राउज़र उदाहरण लॉन्च करें, स्थानीय क्रॉलिंग प्रदर्शन सीमाओं को हटा दें और Crawl4AI दक्षता को अधिकतम करें।
- 40%–80% लागत में कमी: समान क्लाउड सेवाओं की तुलना में, कुल लागत घटकर केवल 20%–60% रह जाती है। पे-एज़-यू-गो मूल्य निर्धारण छोटे पैमाने के प्रोजेक्ट्स के लिए भी किफायती बनाता है।
- विज़ुअल डिबगिंग उपकरण: सत्र पुनर्प्रस्तुति और लाइव URL निगरानी का उपयोग करके वास्तविक समय में Crawl4AI कार्यों को देखें, विफलता के कारणों को जल्दी पहचानें और डिबगिंग के अतिरिक्त खर्च को कम करें।
- शून्य लागत एकीकरण: Crawl4AI द्वारा उपयोग किए जाने वाले Playwright के साथ नेटिव रूप से संगत, केवल एक पंक्ति कोड की आवश्यकता होती है जो Crawl4AI को क्लाउड से जोड़ता है — कोड पुनर्गठन की आवश्यकता नहीं है।
- एज नोड सेवा (ENS): वैश्विक स्तर पर कई नोड्स प्रारंभ गति और स्थिरता प्रदान करते हैं जो अन्य क्लाउड ब्राउज़रों की तुलना में 2–3× तेज़ होते हैं, Crawl4AI निष्पादन को तेज करते हैं।
- पृथक वातावरण और स्थायी सत्र: प्रत्येक Scrapeless प्रोफ़ाइल अपने स्वयं के वातावरण में चलती है जिसमें स्थायी लॉगिन और पहचान अलगाव होता है, सत्र हस्तक्षेप को रोकता है और बड़े पैमाने पर स्थिरता में सुधार करता है।
- लचीला फिंगरप्रिंट प्रबंधन: Scrapeless यादृच्छिक ब्राउज़र फिंगरप्रिंट उत्पन्न कर सकता है या कस्टम कॉन्फ़िगरेशन का उपयोग कर सकता है, प्रभावी ढंग से पता लगाए जाने के जोखिम को कम करता है और Crawl4AI की सफलता दर में सुधार करता है।
शुरुआत करना
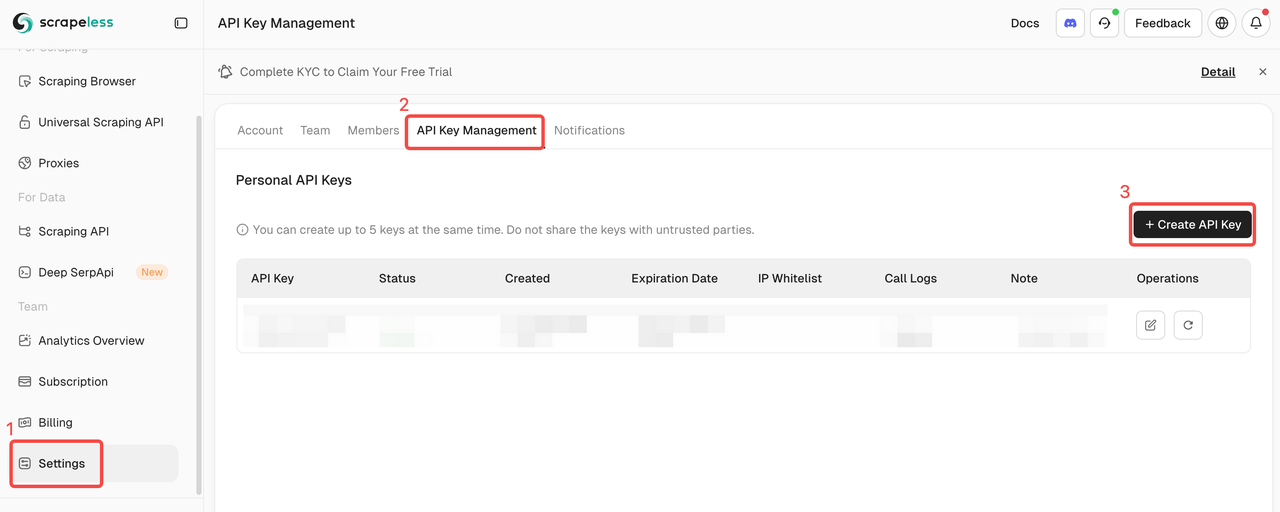
1. अपनी Scrapeless API कुंजी प्राप्त करें
Scrapeless में लॉग इन करें और अपनी API टोकन प्राप्त करें।
2. त्वरित शुरुआत
नीचे दिया गया उदाहरण दर्शाता है कि कैसे Crawl4AI को Scrapeless क्लाउड ब्राउज़र से जल्दी और आसानी से जोड़ा जाए:
अधिक सुविधाओं और विस्तृत निर्देशों के लिए, परिचय देखें।
scrapeless_params = {
    "token": "get your token from https://www.scrapeless.com",
    "sessionName": "Scrapeless browser",
    "sessionTTL": 1000,
}

query_string = urlencode(scrapeless_params)
scrapeless_connection_url = f"wss://browser.scrapeless.com/api/v2/browser?{query_string}"

AsyncWebCrawler(
    config=BrowserConfig(
        headless=False,
        browser_mode="cdp",
        cdp_url=scrapeless_connection_url
    )
)
कॉन्फ़िगरेशन के बाद, Crawl4AI CDP (Chrome DevTools प्रोटोकॉल) मोड के माध्यम से Scrapeless क्लाउड ब्राउज़र से जुड़ता है, जो स्थानीय ब्राउज़र वातावरण के बिना वेब स्क्रैपिंग को सक्षम करता है। उपयोगकर्ता उच्च-समवर्ती और जटिल एंटी-बॉट परिदृश्यों की मांगों को पूरा करने के लिए प्रॉक्सी, फिंगरप्रिंट, सत्र पुन: उपयोग और अन्य सुविधाओं को आगे कॉन्फ़िगर कर सकते हैं।
3. वैश्विक स्वचालित प्रॉक्सी रोटेशन
Scrapeless 195 देशों में रेजिडेंशियल आईपी का समर्थन करता है। उपयोगकर्ता लक्ष्य क्षेत्र को proxycountry का उपयोग करके कॉन्फ़िगर कर सकते हैं, जिससे विशिष्ट स्थानों से अनुरोध भेजे जा सकते हैं। आईपी स्वचालित रूप से घूमते हैं, प्रभावी ढंग से अवरोधों से बचा जा सकता है।
import asyncio
from urllib.parse import urlencode
from crawl4ai import CrawlerRunConfig, BrowserConfig, AsyncWebCrawler

async def main():
    scrapeless_params = {
        "token": "your token",
        "sessionTTL": 1000,
        "sessionName": "Proxy Demo",
# Sets the target country/region for the proxy, sending requests via an IP address from that region. You can specify a country code (e.g., US for the United States, GB for the United Kingdom, ANY for any country). See country codes for all supported options."proxyCountry": "ANY",
    }
    query_string = urlencode(scrapeless_params)
    scrapeless_connection_url = f"wss://browser.scrapeless.com/api/v2/browser?{query_string}"async with AsyncWebCrawler(
        config=BrowserConfig(
            headless=False,
            browser_mode="cdp",
            cdp_url=scrapeless_connection_url,
        )
    ) as crawler:
        result = await crawler.arun(
            url="https://www.scrapeless.com/en",
            config=CrawlerRunConfig(
                wait_for="css:.content",
                scan_full_page=True,
            ),
        )
        print("-" * 20)
        print(f'Status Code: {result.status_code}')
        print("-" * 20)
        print(f'Title: {result.metadata["title"]}')
        print(f'Description: {result.metadata["description"]}')
        print("-" * 20)
asyncio.run(main())
4. कस्टम ब्राउज़र फिंगरप्रिंट
वास्तविक उपयोगकर्ता व्यवहार की नकल करने के लिए, Scrapeless यादृच्छिक रूप से उत्पन्न ब्राउज़र फिंगरप्रिंट का समर्थन करता है और कस्टम फिंगरप्रिंट पैरामीटर की अनुमति भी देता है। यह प्रभावी ढंग से लक्ष्य वेबसाइट द्वारा पता लगाए जाने के जोखिम को कम करता है।
import json
import asyncio
from urllib.parse import quote, urlencode
from crawl4ai import CrawlerRunConfig, BrowserConfig, AsyncWebCrawler

async def main():
# customize browser fingerprint
    fingerprint = {
        "userAgent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/134.1.2.3 Safari/537.36",
        "platform": "Windows",
        "screen": {
            "width": 1280, "height": 1024
        },
        "localization": {
            "languages": ["zh-HK", "en-US", "en"], "timezone": "Asia/Hong_Kong",
        }
    }

    fingerprint_json = json.dumps(fingerprint)
    encoded_fingerprint = quote(fingerprint_json)

    scrapeless_params = {
        "token": "your token",
        "sessionTTL": 1000,
        "sessionName": "Fingerprint Demo",
        "fingerprint": encoded_fingerprint,
    }
    query_string = urlencode(scrapeless_params)
    scrapeless_connection_url = f"wss://browser.scrapeless.com/api/v2/browser?{query_string}"async with AsyncWebCrawler(
        config=BrowserConfig(
            headless=False,
            browser_mode="cdp",
            cdp_url=scrapeless_connection_url,
        )
    ) as crawler:
        result = await crawler.arun(
            url="https://www.scrapeless.com/en",
            config=CrawlerRunConfig(
                wait_for="css:.content",
                scan_full_page=True,
            ),
        )
        print("-" * 20)
        print(f'Status Code: {result.status_code}')
        print("-" * 20)
        print(f'Title: {result.metadata["title"]}')
        print(f'Description: {result.metadata["description"]}')
        print("-" * 20)
asyncio.run(main())
5. प्रोफ़ाइल पुन: उपयोग
Scrapeless प्रत्येक प्रोफ़ाइल को अपना स्वतंत्र ब्राउज़र वातावरण देता है, जो स्थायी लॉगिन और पहचान अलगाव को सक्षम करता है। उपयोगकर्ता बस पिछले सत्र को पुन: उपयोग करने के लिए profileId प्रदान कर सकते हैं।
import asyncio
from urllib.parse import urlencode
from crawl4ai import CrawlerRunConfig, BrowserConfig, AsyncWebCrawler

async def main():
    scrapeless_params = {
        "token": "your token",
        "sessionTTL": 1000,
        "sessionName": "Profile Demo",
        "profileId": "your profileId",# create profile on scrapeless
    }
    query_string = urlencode(scrapeless_params)
    scrapeless_connection_url = f"wss://browser.scrapeless.com/api/v2/browser?{query_string}"async with AsyncWebCrawler(
        config=BrowserConfig(
            headless=False,
            browser_mode="cdp",
            cdp_url=scrapeless_connection_url,
        )
    ) as crawler:
        result = await crawler.arun(
            url="https://www.scrapeless.com",
            config=CrawlerRunConfig(
                wait_for="css:.content",
                scan_full_page=True,
            ),
        )
        print("-" * 20)
        print(f'Status Code: {result.status_code}')
        print("-" * 20)
        print(f'Title: {result.metadata["title"]}')
        print(f'Description: {result.metadata["description"]}')
        print("-" * 20)
asyncio.run(main())