Bypass do Cloudflare em web scraping
Agent Browser e Cloudflare
Este documento técnico explica como usar as ferramentas Scrapeless Agent Browser e Scrapeless Web Unlocker para lidar com os diversos desafios de segurança configurados pelo Cloudflare. Os principais recursos incluem contornar o Cloudflare JS Challenge, o Cloudflare Turnstile e executar renderização de JavaScript para acessar conteúdo protegido pelo Cloudflare. Este documento fornecerá conhecimento de contexto relevante, apresentação de recursos, etapas operacionais e explicações de exemplos de código.
Entendendo os desafios e as camadas de segurança do Cloudflare
O Cloudflare, um popular serviço de segurança e desempenho web, protege principalmente sites contra tráfego malicioso ou inesperado, como bots e scanners. Para isso, o Cloudflare implementa vários mecanismos de detecção e defesa, incluindo, mas não se limitando a:
1. JS Challenge (Desafio de JavaScript): Exige que o navegador do visitante execute um código JavaScript específico para verificar se é um ambiente de navegador legítimo com funcionalidade padrão.
2. Alternativa ao CAPTCHA Turnstile: Um mecanismo de verificação menos intrusivo para distinguir entre usuários humanos e bots.
3. Fingerprinting do Navegador: Coleta e analisa características técnicas do navegador e do dispositivo (por exemplo, User-Agent, resolução de tela, fontes instaladas, plugins) para identificar e rastrear visitantes.
4. Limitação de Taxa (Rate Limiting): Monitora e limita o número de requisições de uma única origem (por exemplo, endereço IP) dentro de um período específico para evitar ataques de força bruta ou abuso de recursos.
Essas camadas de segurança impedem que bibliotecas básicas de requisições HTTP, scripts simples ou navegadores headless configurados incorretamente acessem sites protegidos pelo Cloudflare, resultando em falhas de verificação e negação de acesso.
Diferenças entre o Cloudflare JS Challenge e outros desafios
A singularidade do Cloudflare JS Challenge está em seu método de verificação. Ele não apenas exige que os usuários concluam uma tarefa interativa simples (por exemplo, reconhecimento de imagem); ele exige que o ambiente do cliente (navegador) analise e execute com sucesso um código JavaScript gerado dinamicamente, frequentemente ofuscado, do Cloudflare. Esse código realiza verificações de ambiente, tarefas computacionalmente intensivas ou outras lógicas para verificar as capacidades de comportamento complexo do cliente, imitando um navegador real.
Passar com sucesso pelo JS Challenge envolve a geração de um token de liberação válido (geralmente na forma de um cookie cf_clearance). Esse token comprova que o cliente passou pela verificação de capacidade de execução de JavaScript. Muitas ferramentas de automação não possuem um mecanismo completo de execução de JavaScript nem uma simulação realista do ambiente do navegador, falhando, portanto, nesses desafios.
Contornando o Cloudflare JS Challenge com o Scrapeless Agent Browser
O Scrapeless Agent Browser foi projetado para lidar com medidas complexas de proteção de sites, incluindo o Cloudflare JS Challenge.
Etapas e exemplo de código
Configuração do ambiente
Crie uma pasta para o projeto
Crie uma nova pasta para o projeto, por exemplo: scrapeless-bypass.
Navegue até a pasta no seu terminal:
cd path/to/scrapeless-bypassInicialize o projeto Node.js
Execute o comando a seguir para criar um arquivo package.json:
npm init -yInstale as dependências necessárias
Instale o Puppeteer-core, que permite a conexão remota com instâncias do navegador:
npm install puppeteer-coreSe o Puppeteer ainda não estiver instalado no seu sistema, instale a versão completa:
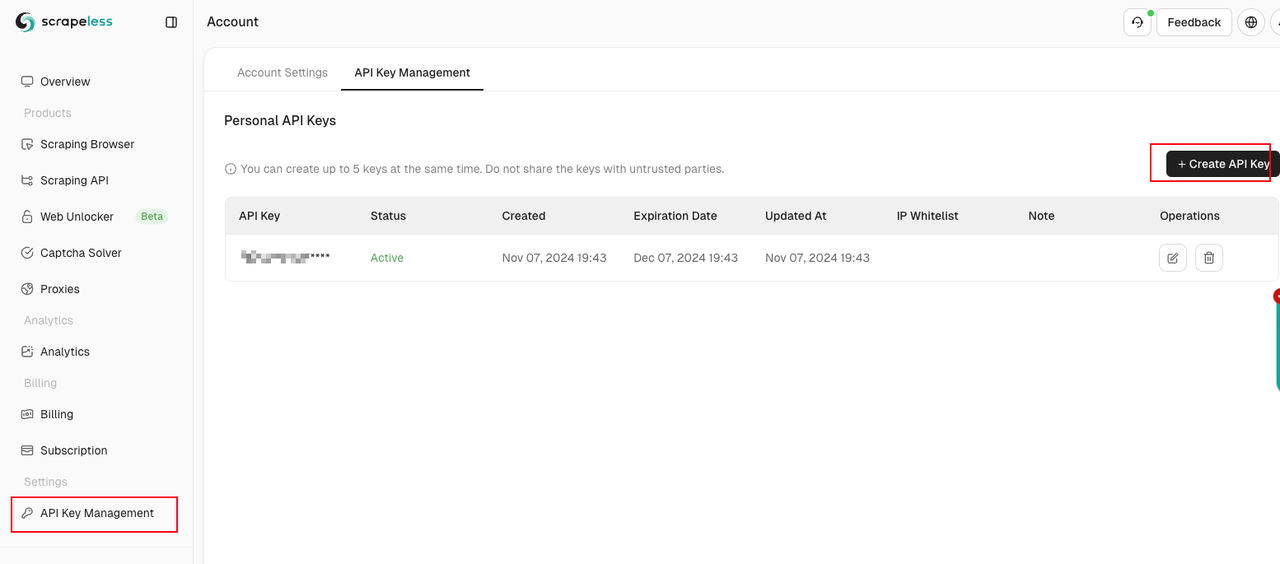
npm install puppeteer puppeteer-coreObtenha e configure sua chave de API do Scrapeless.
Conecte-se e garanta que o CAPTCHA seja resolvido com sucesso
O Scrapeless detecta e resolve CAPTCHAs automaticamente ao se conectar ao navegador para acessar o site de destino. No entanto, precisamos garantir que o CAPTCHA seja resolvido com sucesso. O Scrapeless Agent Browser estende o CDP (Chrome DevTools Protocol) padrão com um poderoso conjunto de capacidades personalizadas. O status do solucionador de CAPTCHA pode ser observado diretamente verificando os resultados retornados pela API do CDP:
Captcha.detected: CAPTCHA detectadoCaptcha.solveFinished: CAPTCHA resolvido com sucessoCaptcha.solveFailed: falha ao resolver o CAPTCHA
import puppeteer from "puppeteer-core";
import EventEmitter from 'events';
import { Scrapeless } from '@scrapeless-ai/sdk';

const emitter = new EventEmitter();

const client = new Scrapeless({ apiKey: 'API Key' });

const { browserWSEndpoint } = client.browser.create({
    sessionName: 'sdk_test',
    sessionTTL: 180,
    proxyCountry: 'ANY',
    sessionRecording: true,
    fingerprint,
});

export async function example(url) {
  const browser = await puppeteer.connect({
    browserWSEndpoint,
    defaultViewport: null
  });
  console.log("Verbonden met Scrapeless browser");
  try {
    const page = await browser.newPage();
    // Listen for captcha events
    console.debug("addCaptchaListener: Start listening for captcha events");
    await addCaptchaListener(page);
    console.log("Navigated to URL:", url);
    await page.goto(url, { waitUntil: "domcontentloaded", timeout: 30000 });
    console.log("onCaptchaFinished: Waiting for captcha solving to finish...");
    await onCaptchaFinished()
    // Screenshot for debugging
    console.debug("Taking screenshot of the final page...");
    await page.screenshot({ path: 'screenshot.png', fullPage: true });
  } catch (error) {
    console.error(error);
  } finally {
    await browser.close();
    console.log("Browser closed");
  }
}

async function addCaptchaListener(page) {
  const client = await page.createCDPSession();
  client.on("Captcha.detected", (msg) => {
    console.debug("Captcha.detected: ", msg);
  });
  client.on("Captcha.solveFinished", async (msg) => {
    console.debug("Captcha.solveFinished: ", msg);
    emitter.emit("Captcha.solveFinished", msg);
    client.removeAllListeners()
  });
}

async function onCaptchaFinished(timeout = 60_000) {
  return Promise.race([
    new Promise((resolve) => {
      emitter.on("Captcha.solveFinished", (msg) => {
        resolve(msg);
      });
    }),
    new Promise((_, reject) => setTimeout(() => reject('Timeout'), timeout))
  ])
}Este fluxo de trabalho de exemplo acessa o site de destino e confirma que o CAPTCHA foi resolvido com sucesso ao ouvir o evento CDP Captcha.solveFinished. Por fim, ele captura uma captura de tela da página para verificação.
Este exemplo define dois métodos principais:
addCaptchaListener: para ouvir eventos de CAPTCHA dentro da sessão do navegadoronCaptchaFinished: para aguardar até que o CAPTCHA tenha sido resolvido
O código de exemplo acima pode ser usado para ouvir eventos CDP de três tipos comuns de CAPTCHA discutidos neste artigo: reCAPTCHA v2, Cloudflare Turnstile e Cloudflare 5s Challenge.
Observe que o Cloudflare 5s Challenge é um pouco especial. Às vezes ele não dispara um desafio real, e depender apenas da detecção de eventos CDP para determinar o sucesso pode levar a timeouts. Portanto, aguardar que um elemento específico apareça na página após o desafio é uma solução mais estável.
Conectando ao WebSocket do Scrapeless Browserless
O Scrapeless fornece uma conexão WebSocket, permitindo que o Puppeteer interaja diretamente com o navegador headless, contornando os desafios do Cloudflare.
O endereço completo da conexão WebSocket:
wss://browser.scrapeless.com/api/v2/browser?token=APIKey&sessionTTL=180&proxyCountry=ANYExemplo de código: contornando o desafio do Cloudflare
Precisamos apenas do código a seguir para conectar ao serviço browserless do Scrapeless.
import puppeteer from 'puppeteer-core';

const API_KEY = 'your_api_key'
const host = 'wss://browser.scrapeless.com/api/v2';
const query = new URLSearchParams({
  token: API_KEY,
  sessionTTL: '180', // The life cycle of a browser session, in seconds
  proxyCountry: 'GB', // Agent country
  proxySessionId: 'test_session_id', // The proxy session id is used to keep the proxy ip unchanged. The session time is 3 minutes by default, based on the proxySessionDuration setting.
  proxySessionDuration: '5' // Agent session time, unit minutes
}).toString();

const connectionURL = `${host}/browser?${query}`;
const browser = await puppeteer.connect({
    browserWSEndpoint: connectionURL,
    defaultViewport: null,
});
console.log('Connected!')
Acessando sites protegidos pelo Cloudflare e verificação por captura de tela
Em seguida, usamos o scrapeless browserless para acessar diretamente o site de teste cloudflare-challenge e adicionamos uma captura de tela, permitindo a verificação visual. Antes de fazer a captura de tela, observe que você precisa usar waitForSelector para aguardar os elementos na página, garantindo que o desafio do Cloudflare tenha sido contornado com sucesso.
const page = await browser.newPage();
await page.goto('https://www.scrapingcourse.com/cloudflare-challenge', {waitUntil: 'domcontentloaded'});
// By waiting for elements in the site page, ensuring that the Cloudflare challenge has been successfully bypassed.
await page.waitForSelector('main.page-content .challenge-info', {timeout: 30 * 1000})
await page.screenshot({path: 'challenge-bypass.png'});
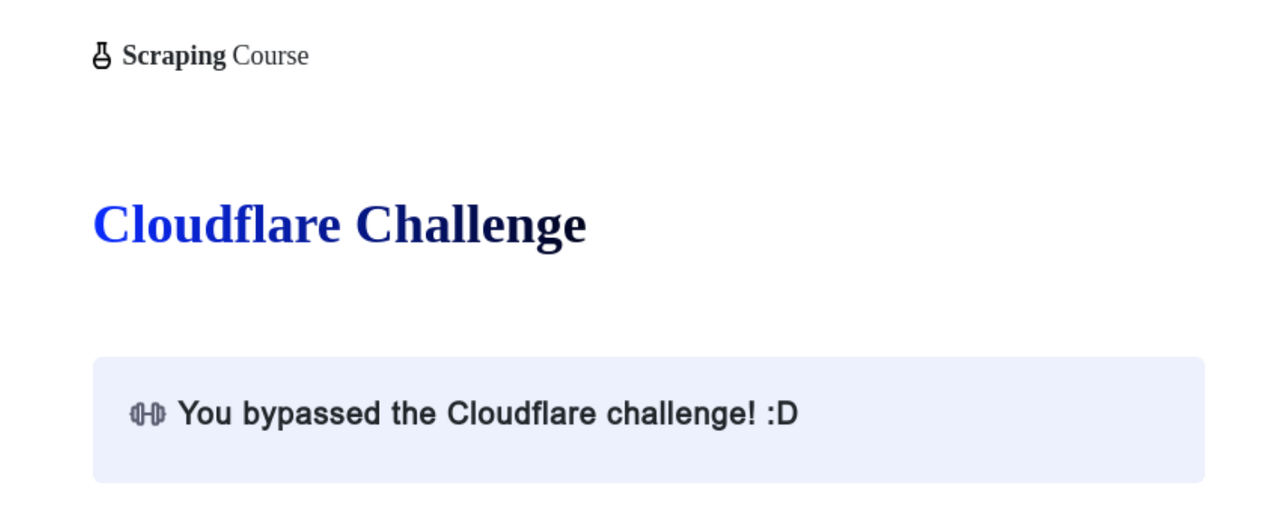
Neste ponto, você contornou o desafio do Cloudflare usando o Scrapeless Browserless.
Recuperando o cookie e o cabeçalho cf_clearance
Após passar pelo desafio do Cloudflare, você pode recuperar os cabeçalhos da requisição e o cookie cf_clearance da página bem-sucedida.
const cookies = await browser.cookies()
const cfClearance = cookies.find(cookie => cookie.name === 'cf_clearance')?.value
Habilite a interceptação de requisições para capturar os cabeçalhos da requisição e corresponder às requisições da página após o desafio do Cloudflare.
await page.setRequestInterception(true);
page.on('request', request => {
  // Match page requests after cloudflare challenge
  if (request.url().includes('https://www.scrapingcourse.com/cloudflare-challenge') && request.headers()?.['origin']) {
    const accessRequestHeaders = request.headers();
    console.log('[access_request_headers] =>', accessRequestHeaders);
  }
  request.continue();
});
Contornando o Cloudflare Turnstile com o Scrapeless Agent Browser
O Scrapeless Agent Browser também lida com os desafios do Cloudflare Turnstile.
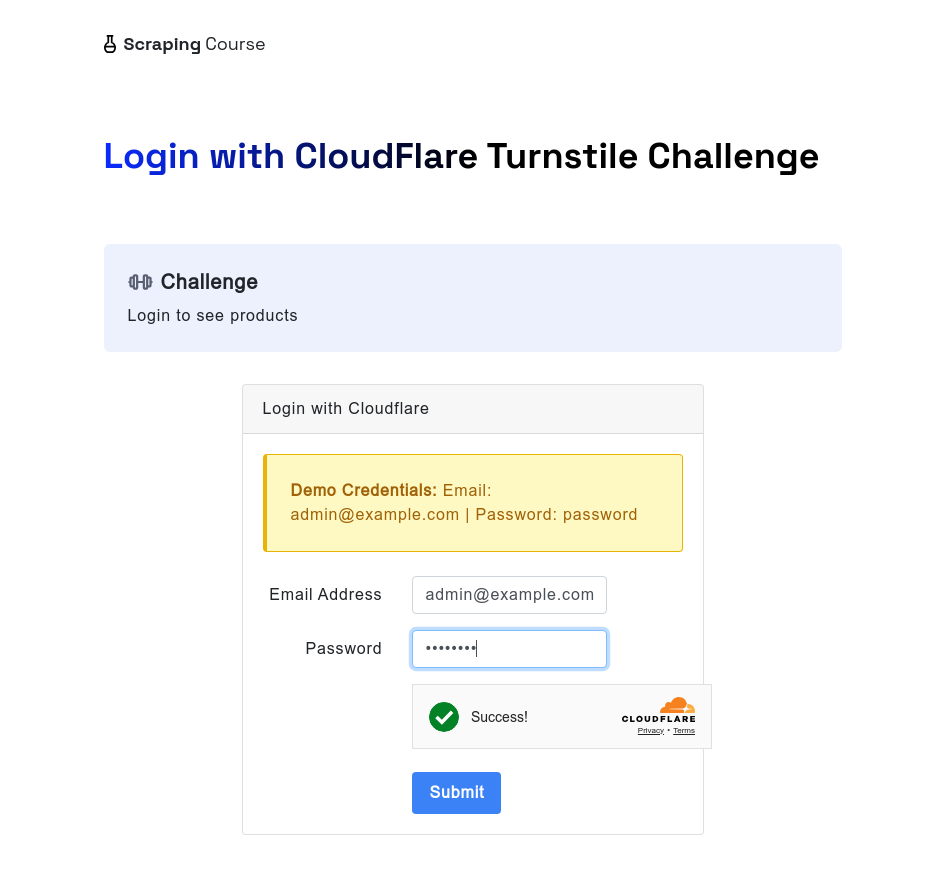
Da mesma forma, ao enfrentar o Cloudflare Turnstile, o agent browser browserless ainda consegue lidar com ele automaticamente. O exemplo a seguir acessa o site de teste cloudflare-turnstile. Após inserir o nome de usuário e a senha, ele usa o método waitForFunction para aguardar os dados de window.turnstile.getResponse(), garantindo que o desafio seja contornado com sucesso. Em seguida, ele faz uma captura de tela e clica no botão de login para navegar até a próxima página.
Etapas e exemplo de código:
const page = await browser.newPage();
await page.goto('https://www.scrapingcourse.com/login/cf-turnstile', { waitUntil: 'domcontentloaded' });
await page.locator('input[type="email"]').fill('admin@example.com')
await page.locator('input[type="password"]').fill('password')
// Wait for turnstile to unlock successfully
await page.waitForFunction(() => {
  return window.turnstile && window.turnstile.getResponse();
});
await page.screenshot({ path: 'challenge-bypass-success.png' });
await page.locator('button[type="submit"]').click()
await page.waitForNavigation()
await page.screenshot({ path: 'next-page.png' });
Após executar este script, você verá o efeito de desbloqueio por meio de capturas de tela.
Usando o Scrapeless Web Unlocker para renderização de JavaScript
Para sites protegidos pelo Cloudflare cujo conteúdo principal depende da execução de JavaScript no lado do cliente para carregar e exibir completamente, o Scrapeless Web Unlocker fornece uma solução dedicada.
A API Universal do Scrapeless permite a renderização de JavaScript e a interação dinâmica, tornando-se uma ferramenta eficaz para contornar o Cloudflare.
Renderização de JavaScript
A renderização de JavaScript suporta o processamento de conteúdo carregado dinamicamente e de SPAs (aplicações de página única). Ela oferece suporte a um ambiente de navegador completo, lidando com interações de página e requisitos de renderização mais complexos.
Com input.jsRender.enabled=true, usaremos o navegador para a requisição
{
  "actor": "unlocker.webunlocker",
  "input": {
    "url": "https://www.google.com/",
    "jsRender": {
      "enabled": true
    }
  },
  "proxy": {
    "country": "US"
  }
}
Instruções de JavaScript
Fornece um amplo conjunto de instruções de JavaScript, permitindo a interação dinâmica com páginas web.
Essas instruções permitem clicar em elementos, preencher formulários, enviar formulários ou aguardar que elementos específicos apareçam, oferecendo flexibilidade para tarefas como clicar em um botão “Ler mais” ou enviar um formulário.
{
  "actor": "unlocker.webunlocker",
  "input": {
    "url": "https://example.com",
    "jsRender": {
      "enabled": true,
      "instructions": [
        {
          "waitFor": [
            ".dynamic-content",
            30000
          ]
          // Wait for element
        },
        {
          "click": [
            "#load-more",
            1000
          ]
          // Click element
        },
        {
          "fill": [
            "#search-input",
            "search term"
          ]
          // Fill form
        },
        {
          "keyboard": [
            "press",
            "Enter"
          ]
          // Simulate key press
        },
        {
          "evaluate": "window.scrollTo(0, document.body.scrollHeight)"
          // Execute custom JS
        }
      ]
    }
  }
}
Exemplo de bypass do desafio
O exemplo a seguir usa o axios para enviar uma requisição ao serviço Web Unlocker do Scrapeless. Ele habilita input.jsRender.enabled e usa a instrução waitFor no parâmetro input.jsRender.instructions para aguardar um elemento na página após contornar o desafio do Cloudflare:
import axios from 'axios'

async function sendRequest() {
  const host = "api.scrapeless.com";
  const url = `https://${host}/api/v2/unlocker/request`;
  const API_KEY = 'your_api_key'

  const payload = {
    actor: "unlocker.webunlocker",
    proxy: {
      country: "US"
    },
    input: {
      url: "https://www.scrapingcourse.com/cloudflare-challenge",
      jsRender: {
        enabled: true,
        instructions: [
          {
            waitFor: [
              "main.page-content .challenge-info",
              30000
            ]
          }
        ]
      }
    }
  }

  try {
    const response = await axios.post(url, payload, {
      headers: {
        'Content-Type': 'application/json',
        'x-api-token': API_KEY
      }
    });
    console.log("[page_html_body] =>", response.data);
  } catch (error) {
    console.error('Error:', error);
  }
}
sendRequest();
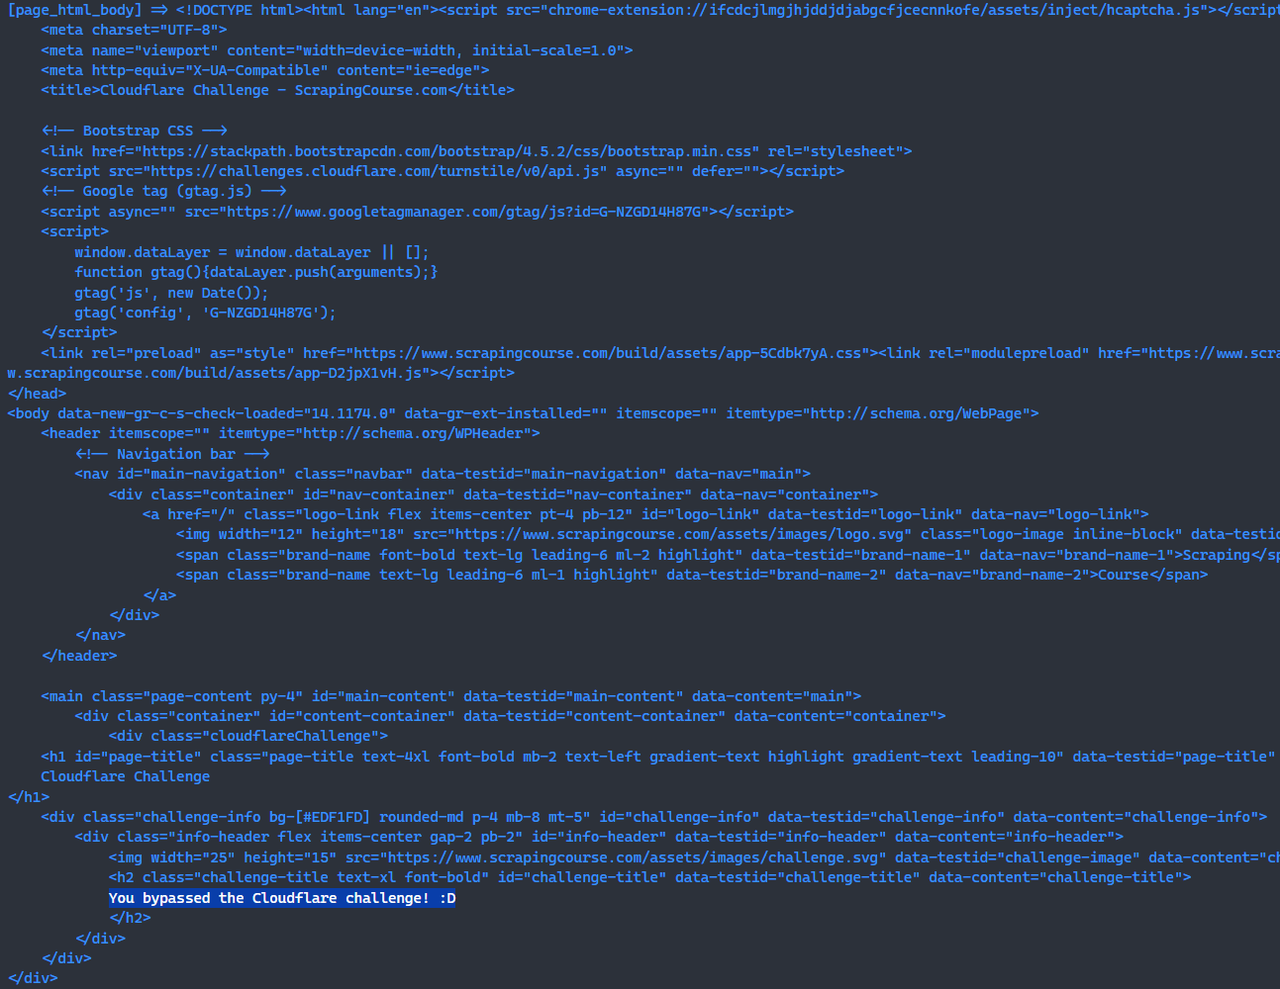
Após executar o script acima, você poderá ver no console o HTML da página que contornou com sucesso o desafio do Cloudflare.