Visão geral
O Scrapeless MCP Server é a integração oficial do Model Context Protocol para o Scrapeless. Ele dá a LLMs, agentes de IA e ferramentas nativas de IA — ChatGPT, Claude, Cursor, Windsurf e qualquer cliente compatível com MCP — acesso em tempo real à web por meio de um único servidor unificado.
Com um único servidor você pode:
- Pesquisar SERPs do Google, Trends, Scholar, Flights e muito mais
- Fazer scraping de qualquer página como HTML, Markdown ou uma captura de tela — contornando o Cloudflare e outras proteções anti-bot
- Fazer crawling de sites inteiros com profundidade configurável e segmentação de URL delimitada
- Automatizar um navegador na nuvem escalável: navegar, clicar, digitar, rolar e extrair
Por que o Scrapeless MCP
Ao contrário dos servidores MCP de automação de navegador local, o Scrapeless roda inteiramente na nuvem, oferecendo a desenvolvedores e agentes de IA escala e confiabilidade de nível de produção:
- Zero configuração local — sem binários de navegador, drivers ou configuração headless para manter.
- Concorrência ilimitada — inicie mais de 50–1000 sessões paralelas com infraestrutura de escalonamento automático.
- Anti-detecção integrada — reCAPTCHA, Cloudflare Turnstile e AWS WAF tratados automaticamente.
- Cobertura global de IP — pools residenciais, de ISP e ilimitados em mais de 195 países.
- Um único token de API — uma única chave Scrapeless desbloqueia todos os produtos por meio do mesmo servidor.
Scrapeless MCP vs. MCPs de navegador de terceiros
O Scrapeless MCP é o próprio servidor multiproduto do Scrapeless. Ele é distinto dos servidores MCP de navegador de terceiros que se conectam ao Scrapeless Cloud Browser como backend:
| MCP Server | Stack tecnológica | Melhor para |
|---|---|---|
| Scrapeless MCP | Serviço na nuvem | Pesquisa, scraping, crawling e automação de navegador em todos os produtos Scrapeless a partir de qualquer cliente MCP. |
| Chrome DevTools MCP | Node.js / Puppeteer | Automação de CI/CD, fluxos de trabalho entre IDEs e auditorias de desempenho aprofundadas. |
| Playwright MCP | Node.js / Playwright | Automação determinística baseada em árvore de acessibilidade que resiste a pequenas mudanças de UI. |
O Chrome DevTools MCP e o Playwright MCP são integrações que executam um MCP de terceiros contra o Scrapeless Cloud Browser. Esta seção documenta o próprio servidor MCP do Scrapeless. Consulte Integrações relacionadas para as opções de terceiros.
O que há nesta seção
- Guia rápido — conecte um cliente em menos de dois minutos.
- Ferramentas por produto — o catálogo completo de ferramentas agrupado por Browser, Crawl, AI Scraper, Web Unlocker, Scraping API e Proxies.
- Autenticação e transportes — tokens de API além dos modos Stdio e Streamable HTTP.
- Configuração do cliente — guias passo a passo para Claude, Cursor, Cline, Codex, Windsurf e clientes personalizados.
- Configuração — opções de sessão, perfil e comportamento.
Vitrine
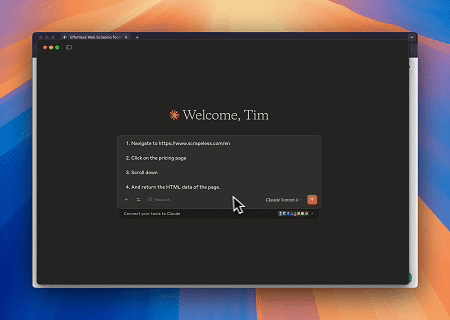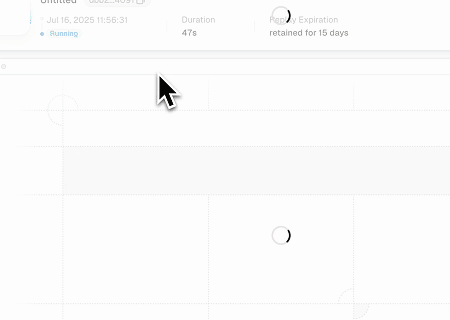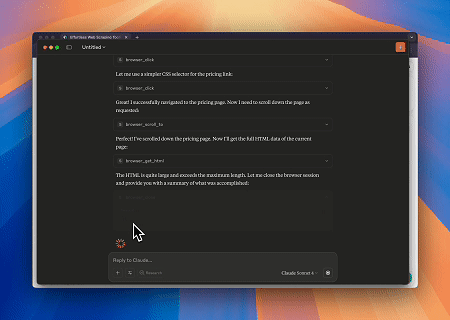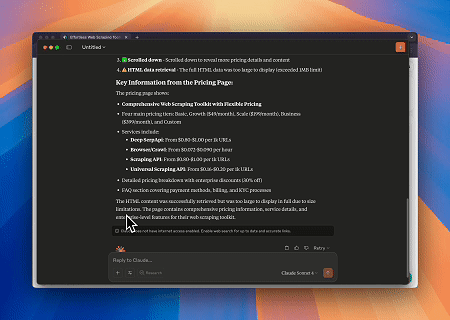
Caso 1: Interação com a web e extração de dados com o Claude
Usando o Scrapeless MCP Server, o Claude pode executar operações complexas na web — navegação, cliques, rolagem e scraping de dados — por meio de comandos conversacionais, com pré-visualização de execução em tempo real via sessões ao vivo.
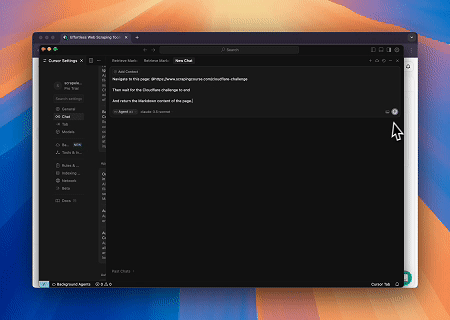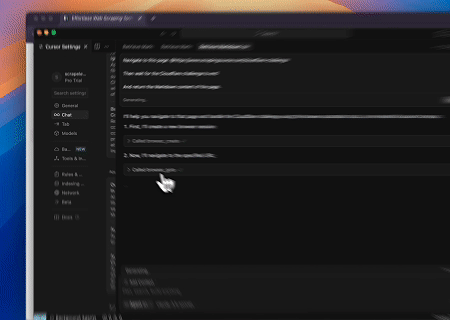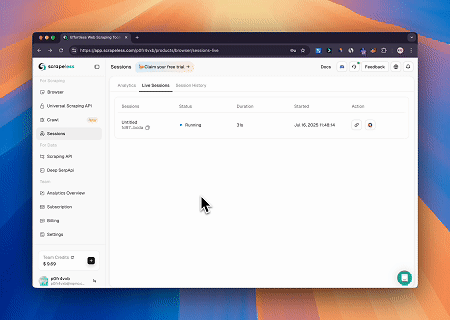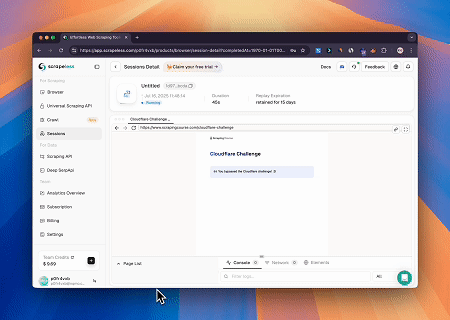
Caso 2: Contornando o Cloudflare para recuperar o conteúdo da página de destino
Usando o Scrapeless MCP Server, páginas protegidas por Cloudflare são acessadas automaticamente e, ao concluir, o conteúdo da página é extraído e retornado em formato Markdown.