Crawl4AI
Crawl4AI é uma ferramenta de rastreamento e extração de dados da web de código aberto, projetada para se integrar perfeitamente com Modelos de Linguagem de Grande Escala (LLMs), Agentes de IA e pipelines de dados. Ela permite a extração de dados em alta velocidade e em tempo real, mantendo-se flexível e fácil de implantar.
Os principais recursos para extração de dados da web com IA incluem:
- Construído para LLMs: Gera Markdown estruturado otimizado para Geração Aumentada por Recuperação (RAG) e ajuste fino (fine-tuning).
- Controle flexível do navegador: Suporta gerenciamento de sessões, uso de proxy e hooks personalizados.
- Inteligência heurística: Usa algoritmos inteligentes para otimizar a análise de dados.
- Totalmente de código aberto: Não requer chave de API; pode ser implantado via Docker e plataformas de nuvem.
Saiba mais na documentação oficial.
Por que usar o Scrapeless com o Crawl4AI?
O Crawl4AI se destaca na extração estruturada de dados da web e suporta análise orientada por LLM e extração baseada em padrões. No entanto, ele ainda pode enfrentar desafios ao lidar com mecanismos avançados anti-bot, como:
- Navegadores locais sendo bloqueados por Cloudflare, AWS WAF ou reCAPTCHA
- Gargalos de desempenho durante rastreamento concorrente em larga escala, com inicialização lenta do navegador
- Processos de depuração complexos que dificultam o rastreamento de problemas
O Scrapeless Cloud Browser resolve esses pontos problemáticos perfeitamente:
- Bypass anti-bot com um clique: Lida automaticamente com reCAPTCHA, Cloudflare Turnstile/Challenge, AWS WAF e muito mais. Combinado com o poder de extração estruturada do Crawl4AI, aumenta significativamente as taxas de sucesso.
- Escalabilidade concorrente ilimitada: Inicie de 50 a mais de 1000 instâncias de navegador por tarefa em segundos, removendo os limites de desempenho do rastreamento local e maximizando a eficiência do Crawl4AI.
- Redução de custos de 40% a 80%: Comparado a serviços de nuvem similares, os custos totais caem para apenas 20% a 60%. O modelo de pagamento por uso o torna acessível mesmo para projetos de pequena escala.
- Ferramentas de depuração visual: Use o Session Replay e o Live URL Monitoring para acompanhar as tarefas do Crawl4AI em tempo real, identificar rapidamente as causas de falhas e reduzir o esforço de depuração.
- Integração de custo zero: Nativamente compatível com o Playwright (usado pelo Crawl4AI), exigindo apenas uma linha de código para conectar o Crawl4AI à nuvem — sem necessidade de refatoração de código.
- Edge Node Service (ENS): Vários nós globais oferecem velocidade de inicialização e estabilidade 2 a 3 vezes mais rápidas do que outros navegadores em nuvem, acelerando a execução do Crawl4AI.
- Ambientes isolados e sessões persistentes: Cada perfil do Scrapeless roda em seu próprio ambiente com login persistente e isolamento de identidade, evitando interferência entre sessões e melhorando a estabilidade em larga escala.
- Gerenciamento flexível de fingerprints: O Scrapeless pode gerar fingerprints de navegador aleatórios ou usar configurações personalizadas, reduzindo efetivamente os riscos de detecção e melhorando a taxa de sucesso do Crawl4AI.
Primeiros Passos
1. Obtenha sua Chave de API do Scrapeless
Faça login no Scrapeless e obtenha seu API Token.
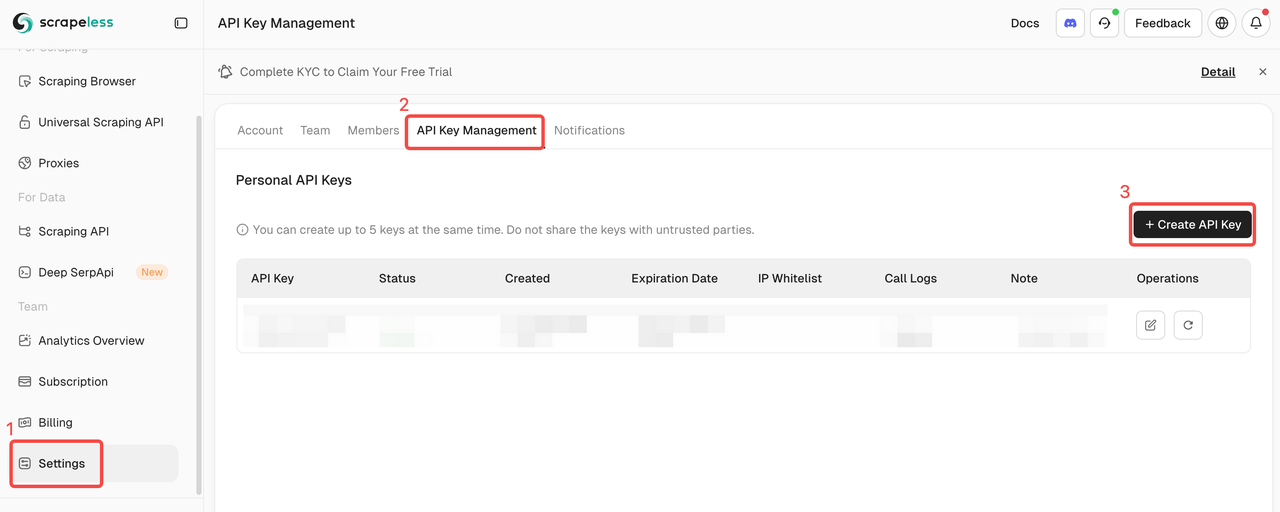
2. Início Rápido
O exemplo abaixo mostra como conectar o Crawl4AI ao Scrapeless Cloud Browser de forma rápida e fácil:
Para mais recursos e instruções detalhadas, consulte a introdução.
scrapeless_params = {
    "token": "get your token from https://www.scrapeless.com",
    "sessionName": "Scrapeless browser",
    "sessionTTL": 1000,
}

query_string = urlencode(scrapeless_params)
scrapeless_connection_url = f"wss://browser.scrapeless.com/api/v2/browser?{query_string}"

AsyncWebCrawler(
    config=BrowserConfig(
        headless=False,
        browser_mode="cdp",
        cdp_url=scrapeless_connection_url
    )
)
Após a configuração, o Crawl4AI se conecta ao Scrapeless Cloud Browser via modo CDP (Chrome DevTools Protocol), permitindo a extração de dados da web sem um ambiente de navegador local. Os usuários podem configurar ainda mais proxies, fingerprints, reutilização de sessão e outros recursos para atender às demandas de cenários de alta concorrência e anti-bot complexos.
3. Rotação Automática Global de Proxy
O Scrapeless suporta IPs residenciais em 195 países. Os usuários podem configurar a região de destino usando proxycountry, permitindo que as requisições sejam enviadas de locais específicos. Os IPs são rotacionados automaticamente, evitando bloqueios de forma eficaz.
import asyncio
from urllib.parse import urlencode
from crawl4ai import CrawlerRunConfig, BrowserConfig, AsyncWebCrawler

async def main():
    scrapeless_params = {
        "token": "your token",
        "sessionTTL": 1000,
        "sessionName": "Proxy Demo",
# Sets the target country/region for the proxy, sending requests via an IP address from that region. You can specify a country code (e.g., US for the United States, GB for the United Kingdom, ANY for any country). See country codes for all supported options."proxyCountry": "ANY",
    }
    query_string = urlencode(scrapeless_params)
    scrapeless_connection_url = f"wss://browser.scrapeless.com/api/v2/browser?{query_string}"async with AsyncWebCrawler(
        config=BrowserConfig(
            headless=False,
            browser_mode="cdp",
            cdp_url=scrapeless_connection_url,
        )
    ) as crawler:
        result = await crawler.arun(
            url="https://www.scrapeless.com/en",
            config=CrawlerRunConfig(
                wait_for="css:.content",
                scan_full_page=True,
            ),
        )
        print("-" * 20)
        print(f'Status Code: {result.status_code}')
        print("-" * 20)
        print(f'Title: {result.metadata["title"]}')
        print(f'Description: {result.metadata["description"]}')
        print("-" * 20)
asyncio.run(main())
4. Fingerprints de Navegador Personalizados
Para imitar o comportamento de um usuário real, o Scrapeless suporta fingerprints de navegador gerados aleatoriamente e também permite parâmetros de fingerprint personalizados. Isso reduz efetivamente o risco de ser detectado pelos sites de destino.
import json
import asyncio
from urllib.parse import quote, urlencode
from crawl4ai import CrawlerRunConfig, BrowserConfig, AsyncWebCrawler

async def main():
# customize browser fingerprint
    fingerprint = {
        "userAgent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/134.1.2.3 Safari/537.36",
        "platform": "Windows",
        "screen": {
            "width": 1280, "height": 1024
        },
        "localization": {
            "languages": ["zh-HK", "en-US", "en"], "timezone": "Asia/Hong_Kong",
        }
    }

    fingerprint_json = json.dumps(fingerprint)
    encoded_fingerprint = quote(fingerprint_json)

    scrapeless_params = {
        "token": "your token",
        "sessionTTL": 1000,
        "sessionName": "Fingerprint Demo",
        "fingerprint": encoded_fingerprint,
    }
    query_string = urlencode(scrapeless_params)
    scrapeless_connection_url = f"wss://browser.scrapeless.com/api/v2/browser?{query_string}"async with AsyncWebCrawler(
        config=BrowserConfig(
            headless=False,
            browser_mode="cdp",
            cdp_url=scrapeless_connection_url,
        )
    ) as crawler:
        result = await crawler.arun(
            url="https://www.scrapeless.com/en",
            config=CrawlerRunConfig(
                wait_for="css:.content",
                scan_full_page=True,
            ),
        )
        print("-" * 20)
        print(f'Status Code: {result.status_code}')
        print("-" * 20)
        print(f'Title: {result.metadata["title"]}')
        print(f'Description: {result.metadata["description"]}')
        print("-" * 20)
asyncio.run(main())
5. Reutilização de Perfil
O Scrapeless atribui a cada perfil seu próprio ambiente de navegador independente, permitindo logins persistentes e isolamento de identidade. Os usuários podem simplesmente fornecer o profileId para reutilizar uma sessão anterior.
import asyncio
from urllib.parse import urlencode
from crawl4ai import CrawlerRunConfig, BrowserConfig, AsyncWebCrawler

async def main():
    scrapeless_params = {
        "token": "your token",
        "sessionTTL": 1000,
        "sessionName": "Profile Demo",
        "profileId": "your profileId",# create profile on scrapeless
    }
    query_string = urlencode(scrapeless_params)
    scrapeless_connection_url = f"wss://browser.scrapeless.com/api/v2/browser?{query_string}"async with AsyncWebCrawler(
        config=BrowserConfig(
            headless=False,
            browser_mode="cdp",
            cdp_url=scrapeless_connection_url,
        )
    ) as crawler:
        result = await crawler.arun(
            url="https://www.scrapeless.com",
            config=CrawlerRunConfig(
                wait_for="css:.content",
                scan_full_page=True,
            ),
        )
        print("-" * 20)
        print(f'Status Code: {result.status_code}')
        print("-" * 20)
        print(f'Title: {result.metadata["title"]}')
        print(f'Description: {result.metadata["description"]}')
        print("-" * 20)
asyncio.run(main())