ウェブスクレイピングにおけるCloudflareバイパス
Scraping BrowserおよびCloudflare
本技術ドキュメントでは、Scrapeless Scraping BrowserおよびScrapeless Web Unlockerのツールを使用してCloudflareによって設定されたさまざまなセキュリティ課題を処理する方法について説明します。主な機能には、Cloudflare JS Challenge、Cloudflare Turnstileのバイパス、およびCloudflareによって保護されたコンテンツへのアクセスのためのJavaScriptレンダリングの実行が含まれます。本ドキュメントでは、関連する背景知識、機能の紹介、操作手順、およびコード例の説明を提供します。
Cloudflareの課題とセキュリティ層の理解
Cloudflareは、人気のあるウェブセキュリティおよびパフォーマンスサービスであり、主にボットやスキャナーなどの悪意のあるまたは予期しないトラフィックからウェブサイトを保護します。この目的のために、Cloudflareは以下に限定されないさまざまな検出および防御メカニズムを実装しています:
1. JSチャレンジ(JavaScriptチャレンジ): 標準的な機能を持つ正当なブラウザ環境であることを確認するために、訪問者のブラウザに特定のJavaScriptコードを実行させる必要があります。
2. TurnstileCAPTCHA代替: 人間のユーザーとボットを区別するための、より侵襲性の低い検証メカニズム。
3. ブラウザフィンガープリント: ブラウザおよびデバイスの技術的特徴(例:User-Agent、画面解像度、インストールされたフォント、プラグインなど)を収集・分析し、訪問者を識別および追跡します。
4. レート制限: 特定の時間内に単一のソース(例:IPアドレス)から送信されるリクエスト数を監視および制限し、ブルートフォース攻撃やリソースの乱用を防止します。
これらのセキュリティ層により、基本的なHTTPリクエストライブラリ、単純なスクリプト、または不適切に設定されたヘッドレスブラウザがCloudflareで保護されたウェブサイトにアクセスできなくなり、検証に失敗してアクセスが拒否されます。
Cloudflare JS Challengeと他のチャレンジの違い
Cloudflare JS Challengeの特異性は、その検証方法にあります。単純なインタラクティブタスク(例:画像認識)を完了させるだけでなく、クライアント環境(ブラウザ)がCloudflareから動的に生成され、しばしば難読化されたJavaScriptコードを正常に解析および実行できることが求められます。このコードは、環境チェック、計算量の多いタスク、またはその他のロジックを実行し、クライアントの複雑な動作能力を検証することで、実際のブラウザを模倣します。
JSチャレンジに成功して通過するには、有効なクリアランストークン(通常は cf_clearance クッキーの形式)を生成する必要があります。このトークンは、クライアントがJavaScript実行能力の検証に合格したことを証明します。多くの自動化ツールは完全なJavaScript実行エンジンや現実的なブラウザ環境のシミュレーションを備えていないため、このようなチャレンジに失敗します。
Scrapeless Scraping Browserを使用したCloudflare JS Challengeのバイパス
Scrapeless Scraping Browserは、Cloudflare JS Challengeを含む複雑なウェブサイト保護対策を処理するように設計されています。
手順とコード例
環境設定
プロジェクトフォルダの作成
scrapeless-bypassなど、プロジェクト用の新しいフォルダを作成します。
ターミナルでそのフォルダに移動します:
cd path/to/scrapeless-bypassNode.jsプロジェクトの初期化
package.jsonファイルを作成するために、以下のコマンドを実行します:
npm init -y必要な依存関係のインストール
ブラウザインスタンスにリモート接続できるようにするPuppeteer-coreをインストールします:
npm install puppeteer-corePuppeteerがまだシステムにインストールされていない場合は、フルバージョンをインストールします:
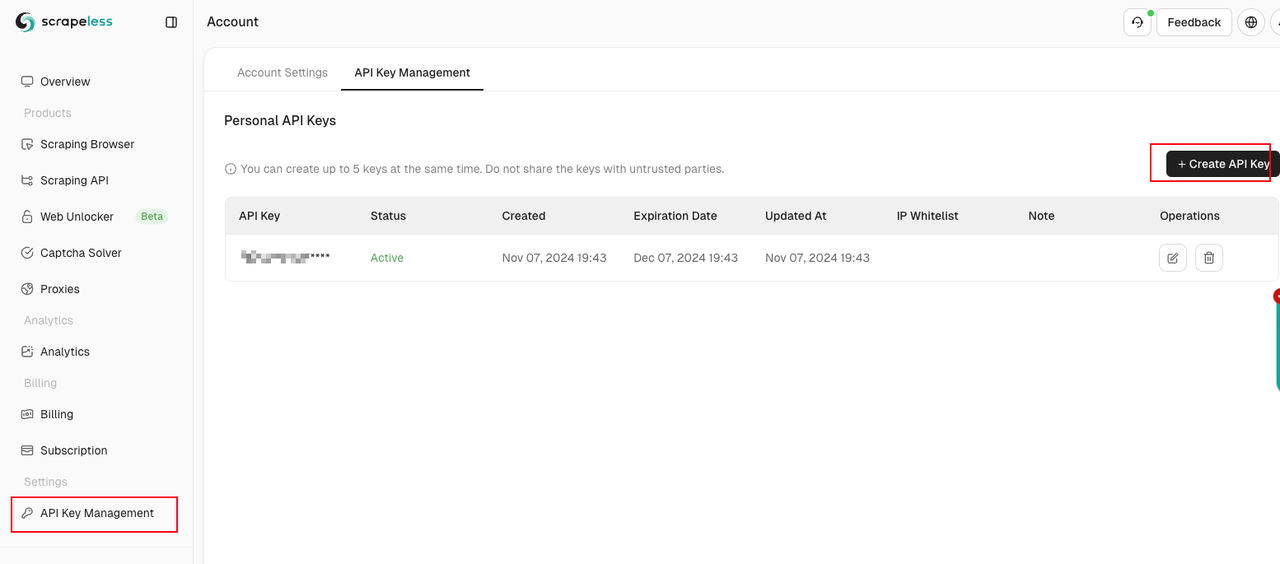
npm install puppeteer puppeteer-coreご自身のScrapeless APIキーを取得して設定します。
接続し、CAPTCHAが正常に解決されたことを確認
Scrapelessは、ターゲットウェブサイトにアクセスするためにブラウザに接続する際にCAPTCHAを自動的に検出し解決します。ただし、CAPTCHAが正常に解決されたことを確認する必要があります。Scrapeless Scraping Browserは、標準のCDP(Chrome DevTools Protocol)を強力なカスタム機能で拡張しています。CAPTCHAソルバーのステータスは、CDP APIから返される結果を確認することで直接観察できます:
Captcha.detected: CAPTCHAが検出されましたCaptcha.solveFinished: CAPTCHAが正常に解決されましたCaptcha.solveFailed: CAPTCHAの解決に失敗しました
import puppeteer from "puppeteer-core";
import EventEmitter from 'events';
import { Scrapeless } from '@scrapeless-ai/sdk';

const emitter = new EventEmitter();

const client = new Scrapeless({ apiKey: 'API Key' });

const { browserWSEndpoint } = client.browser.create({
    sessionName: 'sdk_test',
    sessionTTL: 180,
    proxyCountry: 'ANY',
    sessionRecording: true,
    fingerprint,
});

export async function example(url) {
  const browser = await puppeteer.connect({
    browserWSEndpoint,
    defaultViewport: null
  });
  console.log("Verbonden met Scrapeless browser");
  try {
    const page = await browser.newPage();
    // Listen for captcha events
    console.debug("addCaptchaListener: Start listening for captcha events");
    await addCaptchaListener(page);
    console.log("Navigated to URL:", url);
    await page.goto(url, { waitUntil: "domcontentloaded", timeout: 30000 });
    console.log("onCaptchaFinished: Waiting for captcha solving to finish...");
    await onCaptchaFinished()
    // Screenshot for debugging
    console.debug("Taking screenshot of the final page...");
    await page.screenshot({ path: 'screenshot.png', fullPage: true });
  } catch (error) {
    console.error(error);
  } finally {
    await browser.close();
    console.log("Browser closed");
  }
}

async function addCaptchaListener(page) {
  const client = await page.createCDPSession();
  client.on("Captcha.detected", (msg) => {
    console.debug("Captcha.detected: ", msg);
  });
  client.on("Captcha.solveFinished", async (msg) => {
    console.debug("Captcha.solveFinished: ", msg);
    emitter.emit("Captcha.solveFinished", msg);
    client.removeAllListeners()
  });
}

async function onCaptchaFinished(timeout = 60_000) {
  return Promise.race([
    new Promise((resolve) => {
      emitter.on("Captcha.solveFinished", (msg) => {
        resolve(msg);
      });
    }),
    new Promise((_, reject) => setTimeout(() => reject('Timeout'), timeout))
  ])
}この例では、ターゲットウェブサイトにアクセスし、Captcha.solveFinished CDPイベントをリッスンすることでCAPTCHAが正常に解決されたことを確認します。最後に、ページのスクリーンショットを取得して検証します。
この例では、2つの主要なメソッドを定義しています:
addCaptchaListener: ブラウザセッション内のCAPTCHAイベントをリッスンするためのメソッドonCaptchaFinished: CAPTCHAが解決されるまで待機するためのメソッド
上記のサンプルコードは、この記事で説明している3つの一般的なCDPタイプに関するCAPTCHAイベントをリッスンするために使用できます: reCAPTCHA v2、CloudflareTurnstile、およびCloudflare5s Challenge。
注意してください。 Cloudflare5s Challenge はやや特殊です。場合によっては実際のチャレンジが発生せず、成功の判定を純粋にCDPイベントの検出に頼るとタイムアウトが発生する可能性があります。そのため、チャレンジ後にページ上に特定の要素が出現するのを待つことが、より安定した解決策です。
Scrapeless Browserless WebSocketへの接続
Scrapeless は、WebSocket接続を提供し、Puppeteerがヘッドレスブラウザと直接対話できるようにして、Cloudflareチャレンジをバイパスします。
完全なWebSocket接続アドレス:
wss://browser.scrapeless.com/api/v2/browser?token=APIKey&sessionTTL=180&proxyCountry=ANYコード例:Cloudflareチャレンジのバイパス
Scrapelessのbrowserlessサービスに接続するには、以下のコードのみが必要です。
import puppeteer from 'puppeteer-core';

const API_KEY = 'your_api_key'
const host = 'wss://browser.scrapeless.com/api/v2';
const query = new URLSearchParams({
  token: API_KEY,
  sessionTTL: '180', // The life cycle of a browser session, in seconds
  proxyCountry: 'GB', // Agent country
  proxySessionId: 'test_session_id', // The proxy session id is used to keep the proxy ip unchanged. The session time is 3 minutes by default, based on the proxySessionDuration setting.
  proxySessionDuration: '5' // Agent session time, unit minutes
}).toString();

const connectionURL = `${host}/browser?${query}`;
const browser = await puppeteer.connect({
    browserWSEndpoint: connectionURL,
    defaultViewport: null,
});
console.log('Connected!')
Cloudflareで保護されたウェブサイトへのアクセスとスクリーンショットによる検証
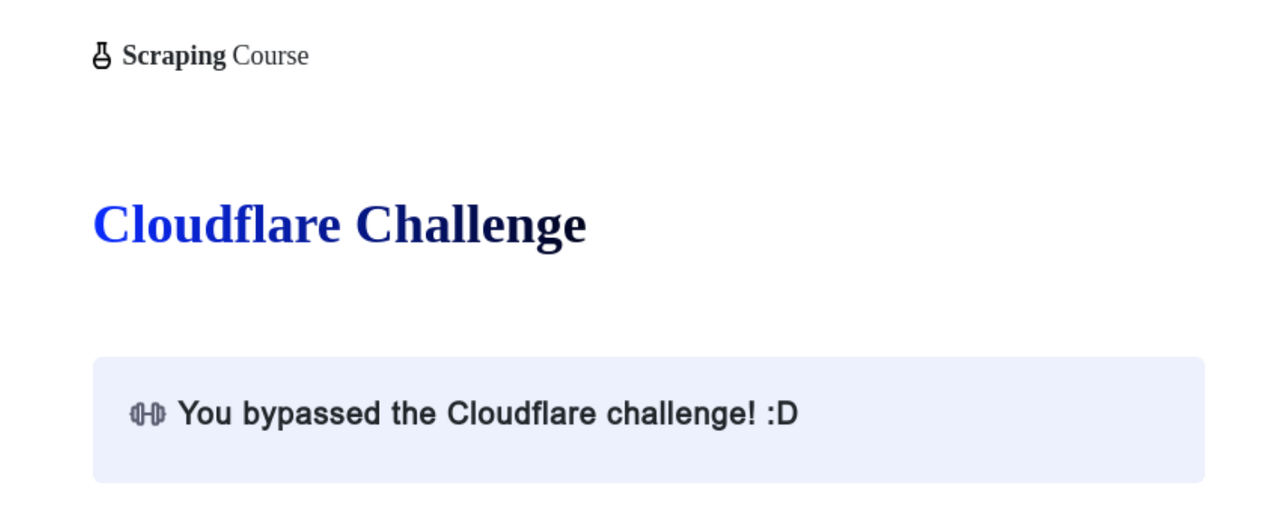
次に、 scrapeless browserless を使用して cloudflare-challengeテストサイト に直接アクセスし、スクリーンショットを追加して視覚的な検証を可能にします。スクリーンショットを撮る前に、ページ上の要素が表示されるのを待つために waitForSelector を使用する必要があることに注意してください。これにより、Cloudflareチャレンジが正常にバイパスされたことを確認できます。
const page = await browser.newPage();
await page.goto('https://www.scrapingcourse.com/cloudflare-challenge', {waitUntil: 'domcontentloaded'});
// By waiting for elements in the site page, ensuring that the Cloudflare challenge has been successfully bypassed.
await page.waitForSelector('main.page-content .challenge-info', {timeout: 30 * 1000})
await page.screenshot({path: 'challenge-bypass.png'});
これで、Scrapeless Browserlessを使用してCloudflareチャレンジをバイパスしました。
cf_clearance Cookieとヘッダーの取得
Cloudflareチャレンジを通過した後、成功したページからリクエストヘッダーとcf_clearance cookieを取得できます。
const cookies = await browser.cookies()
const cfClearance = cookies.find(cookie => cookie.name === 'cf_clearance')?.value
リクエストのインターセプトを有効にしてリクエストヘッダーをキャプチャし、Cloudflareチャレンジ後のページリクエストと照合します。
await page.setRequestInterception(true);
page.on('request', request => {
  // Match page requests after cloudflare challenge
  if (request.url().includes('https://www.scrapingcourse.com/cloudflare-challenge') && request.headers()?.['origin']) {
    const accessRequestHeaders = request.headers();
    console.log('[access_request_headers] =>', accessRequestHeaders);
  }
  request.continue();
});
Scrapeless Scraping Browserを使用したCloudflare Turnstileのバイパス
Scrapeless Scraping BrowserはCloudflare Turnstileチャレンジも処理できます。
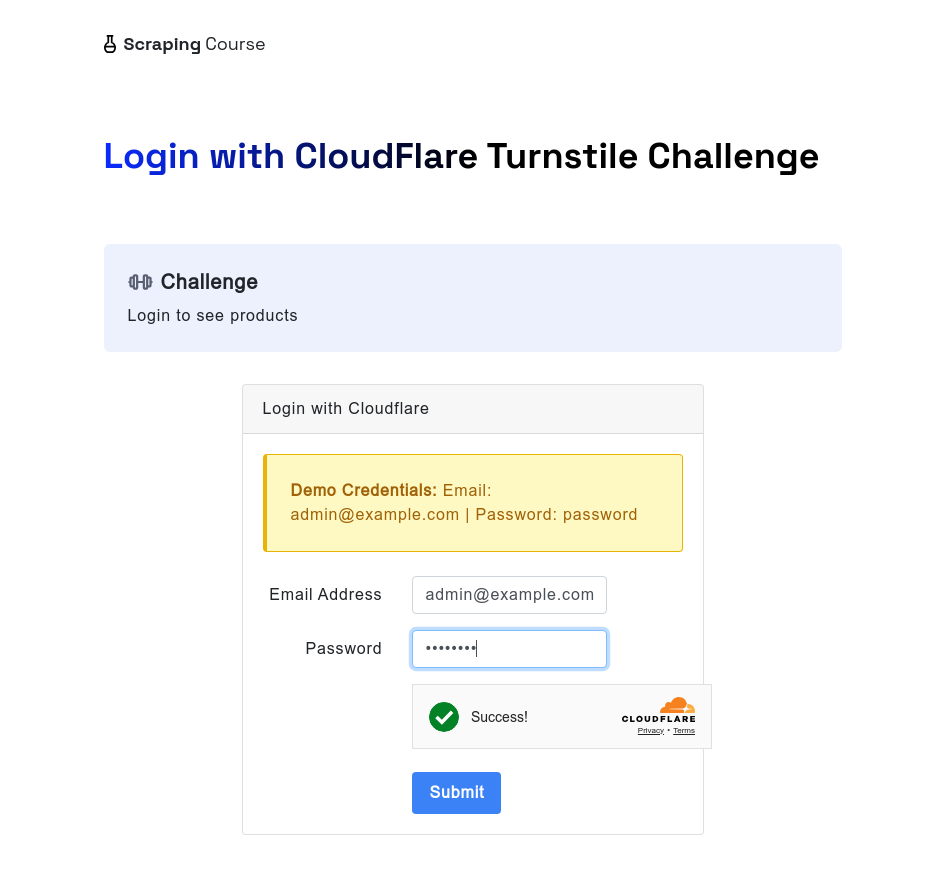
同様に、CloudflareTurnstileに直面した場合でも、browserlessスクラピングブラウザは依然として自動的に処理できます。以下の例では、cloudflare-turnstileテストサイトにアクセスしています。ユーザー名とパスワードを入力した後、 waitForFunction メソッドを使用して window.turnstile.getResponse()からのデータを待機し、チャレンジが正常にバイパスされたことを保証します。その後、スクリーンショットを撮影し、ログインボタンをクリックして次のページに移動します。
手順とコード例:
const page = await browser.newPage();
await page.goto('https://www.scrapingcourse.com/login/cf-turnstile', { waitUntil: 'domcontentloaded' });
await page.locator('input[type="email"]').fill('admin@example.com')
await page.locator('input[type="password"]').fill('password')
// Wait for turnstile to unlock successfully
await page.waitForFunction(() => {
  return window.turnstile && window.turnstile.getResponse();
});
await page.screenshot({ path: 'challenge-bypass-success.png' });
await page.locator('button[type="submit"]').click()
await page.waitForNavigation()
await page.screenshot({ path: 'next-page.png' });
このスクリプトを実行すると、スクリーンショットで解除効果を確認できます。
Scrapeless Web Unlocker を使用した JavaScript レンダリング
コアコンテンツがクライアントサイドの JavaScript 実行に依存して完全に読み込まれ表示される、Cloudflare で保護されたウェブサイト向けに、Scrapeless Web Unlocker は専用のソリューションを提供します。
Scrapeless UniversalAPIは、JavaScriptレンダリングと動的インタラクションを可能にし、Cloudflareをバイパスするための効果的なツールとなっています。
JavaScript レンダリング
JavaScript レンダリングは、動的に読み込まれるコンテンツやSPA(シングルページアプリケーション)の処理をサポートします。完全なブラウザ環境を備えており、より複雑なページのインタラクションやレンダリング要件に対応可能です。
input.jsRender.enabled=trueを使用して、ブラウザでリクエストを行います
{
  "actor": "unlocker.webunlocker",
  "input": {
    "url": "https://www.google.com/",
    "jsRender": {
      "enabled": true
    }
  },
  "proxy": {
    "country": "US"
  }
}
JavaScript インストラクション
幅広い JavaScript インストラクションを提供し、ウェブページとの動的なインタラクションが可能になります。
これらのインストラクションにより、要素のクリック、フォームの入力、フォームの送信、特定の要素の出現を待機することが可能になり、「もっと読む」ボタンのクリックやフォーム送信などのタスクに柔軟性を提供します。
{
  "actor": "unlocker.webunlocker",
  "input": {
    "url": "https://example.com",
    "jsRender": {
      "enabled": true,
      "instructions": [
        {
          "waitFor": [
            ".dynamic-content",
            30000
          ]
          // Wait for element
        },
        {
          "click": [
            "#load-more",
            1000
          ]
          // Click element
        },
        {
          "fill": [
            "#search-input",
            "search term"
          ]
          // Fill form
        },
        {
          "keyboard": [
            "press",
            "Enter"
          ]
          // Simulate key press
        },
        {
          "evaluate": "window.scrollTo(0, document.body.scrollHeight)"
          // Execute custom JS
        }
      ]
    }
  }
}
チャレンジバイパスの例
次の例では、axiosを使用してScrapelessのWeb Unlockerサービスにリクエストを送信します。設定で input.jsRender.enabled を有効にし、 waitFor 命令を input.jsRender.instructions パラメータに指定することで、Cloudflareチャレンジを回避した後にページ内の要素を待機します:
import axios from 'axios'

async function sendRequest() {
  const host = "api.scrapeless.com";
  const url = `https://${host}/api/v2/unlocker/request`;
  const API_KEY = 'your_api_key'

  const payload = {
    actor: "unlocker.webunlocker",
    proxy: {
      country: "US"
    },
    input: {
      url: "https://www.scrapingcourse.com/cloudflare-challenge",
      jsRender: {
        enabled: true,
        instructions: [
          {
            waitFor: [
              "main.page-content .challenge-info",
              30000
            ]
          }
        ]
      }
    }
  }

  try {
    const response = await axios.post(url, payload, {
      headers: {
        'Content-Type': 'application/json',
        'x-api-token': API_KEY
      }
    });
    console.log("[page_html_body] =>", response.data);
  } catch (error) {
    console.error('Error:', error);
  }
}
sendRequest();
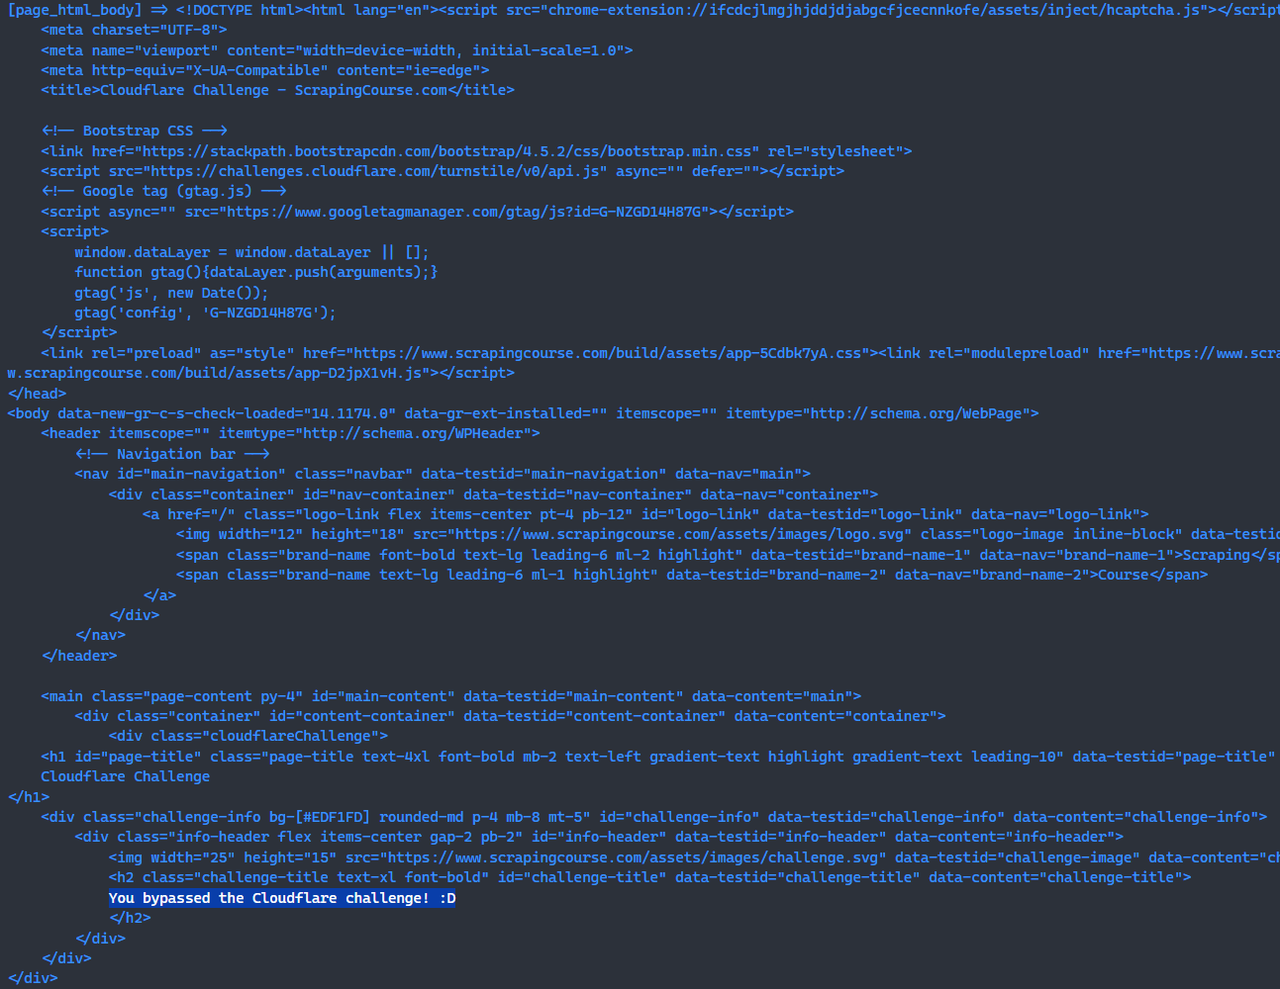
上記のスクリプトを実行後、コンソールで Cloudflare チャレンジを正常にバイパスしたページの HTML を確認できます。