JS Render
Web Unlocker APIは、複雑なWebページのレンダリングと インタラクションシナリオをサポートする強力なWebコンテンツ取得サービスです。
詳細な内容については、当社の APIドキュメント を参照してください。
リクエスト構造
{
  "actor": "unlocker.webunlocker",
  "proxy": {
    "country": "ANY",
    "url": ""
  },
  "input": {
    "url": "string",
    "jsRender": {
      "enabled": true,
      "headless": true,
      "waitUntil": "domcontentloaded",
      "instructions": [],
      "block": {
        "resources": [],
        "urls": []
      },
      "response": {
        "type": "html",
        "options": {}
      }
    }
  }
}
主な機能
JavaScript レンダリング
JavaScriptレンダリングにより、動的に読み込まれるコンテンツやSPA(シングルページアプリケーション)の処理が可能になります。より複雑なページのインタラクションやレンダリング要件に対応するため、 完全なブラウザ環境を提供します。
input.jsRender.enabled=true、ブラウザを使用してリクエストを行います。
{
  "actor": "unlocker.webunlocker",
  "proxy": {
    "country": "ANY"
  },
  "input": {
    "url": "https://example.com/",
    "jsRender": {
      "enabled": true
    }
  }
}
JavaScript インストラクション
Webページと動的にやり取りできるよう、豊富なJavaScriptディレクティブを提供します。
これらのディレクティブにより、要素のクリック、フォームの入力、フォームの送信、特定の要素の出現待ちなどが可能になります。 「続きを読む」ボタンのクリックやフォーム送信などのタスクに柔軟に対応できます。
{
  "actor": "unlocker.webunlocker",
  "input": {
    "url": "https://example.com",
    "jsRender": {
      "enabled": true,
      "instructions": [
        {
          "waitFor": [
            ".dynamic-content",
            30000
          ]
          // Wait for element
        },
        {
          "click": [
            "#load-more",
            1000
          ]
          // Click element
        },
        {
          "fill": [
            "#search-input",
            "search term"
          ]
          // Fill form
        },
        {
          "keyboard": [
            "press",
            "Enter"
          ]
          // Simulate key press
        },
        {
          "evaluate": "window.scrollTo(0, document.body.scrollHeight)"
          // Execute custom JS
        }
      ]
    }
  }
}
以下は、JavaScriptインストラクションで実行できる一般的な操作の例です:
JavaScriptインストラクションリファレンス
| インストラクション | 構文 | 説明 | 例 |
|---|---|---|---|
waitFor | [selector, timeout] | 要素が表示されるのを待つ | {"waitFor": [".content", 30000]} |
click | [selector, delay] | 要素をクリック | {"click": [".button", 1000]} |
fill | [selector, value] | フォームに値を入力 | {"fill": ["#input", "text"]} |
wait | milliseconds | 固定の待機時間 | {"wait": 2000} |
evaluate | javascript code | JSコードを実行 | {"evaluate": "console.log('test')"} |
keyboard | [action, value, delay?] | キーボード操作 | 以下のキーボード操作テーブルを参照 |
キーボード操作
| 操作 | 構文 | 説明 | 例 |
|---|---|---|---|
| キーを押す | ["press", keyInput] | 特定の キーを入力 | {"keyboard": ["press", "Enter"]} |
| テキストを入力 | ["type", text, delay?] | オプションの遅延付きでテキストを入力 | {"keyboard": ["type", "Hello", 20]} |
| キーを押したまま | ["down", key] | キーを押し続ける | {"keyboard": ["down", "Shift"]} |
| キーを離す | ["up", key] | キーを離す | {"keyboard": ["up", "Shift"]} |
サポートされている特殊なkeyInputタイプ: https://pptr.dev/api/puppeteer.keyinput
レスポンスタイプ
パラメータ input.jsRender.response.typeでレスポンスタイプを指定できます。指定可能な値は次の通りです:
html | plaintext | markdown | png | jpeg | network | content、デフォルト値は htmlです:
| タイプ | 説明 |
|---|---|
| html | ページのエスケープ済みHTML文字列。CSSセレクタをサポート |
| plaintext | ページのプレーンテキスト文字列。CSSセレクタをサポート |
| markdown | ページのエスケープ済みMarkdown文字列。CSSセレクタをサポート |
| png | png 形式のページのbase64エンコードされた文字列。CSSセレクタをサポート |
| jpeg | jpeg 形式のページのbase64エンコードされた文字列。CSSセレクタをサポート |
| network | ネットワークリクエストのキャプチャを有効化します。ページ読み込み中に発生したすべての XHR および fetch リクエストを収集し、エスケープされたJSON文字列形式でその詳細を返します。CSSセレクタはサポートしません |
| content | ページコンテンツからデータをフィルタリングします。結果はエスケープ済みJSON文字列形式で返されます |
詳細は以下の通りです
HTML
ページのHTMLコンテンツを抽出するために使用され、純粋に静的なページに最適です。エスケープ済み HTML文字列形式でコンテンツを返します。
リクエストに input.jsRender.response.type=html を追加:
const axios = require('axios');
const fs = require('fs');

(async () => {
    const payload = {
        actor: "unlocker.webunlocker",
        proxy: {
            country: "ANY"
        },
        input: {
            url: "https://www.example.com",
            jsRender: {
                enabled: true,
                response: {
                    type: "html"
                }
            }
        }
    };

    const response = await axios.post("https://api.scrapeless.com/api/v2/unlocker/request", payload, {
        headers: {
            "x-api-token": "API Key",
            "Content-Type": "application/json"
        },
        timeout: 60000
    });

    if (response.data?.code === 200) {
        fs.writeFileSync('response.html', response.data.data, 'utf8');
    }
})();HTML形式でテキストコンテンツを返します。
{
    "code": 200,
    "data": "<!DOCTYPE html><html><head>\n    <title>Example Domain</title>\n\n    <meta charset=\"utf-8\">\n    <meta http-equiv=\"Content-type\" content=\"text/html; charset=utf-8\">\n    <meta name=\"viewport\" content=\"width=device-width, initial-scale=1\">\n    <style type=\"text/css\">\n    body {\n        background-color: #f0f0f2;\n        margin: 0;\n        padding: 0;\n        font-family: -apple-system, system-ui, BlinkMacSystemFont, \"Segoe UI\", \"Open Sans\", \"Helvetica Neue\", Helvetica, Arial, sans-serif;\n        \n    }\n    div {\n        width: 600px;\n        margin: 5em auto;\n        padding: 2em;\n        background-color: #fdfdff;\n        border-radius: 0.5em;\n        box-shadow: 2px 3px 7px 2px rgba(0,0,0,0.02);\n    }\n    a:link, a:visited {\n        color: #38488f;\n        text-decoration: none;\n    }\n    @media (max-width: 700px) {\n        div {\n            margin: 0 auto;\n            width: auto;\n        }\n    }\n    </style>    \n</head>\n\n<body>\n<div>\n    <h1>Example Domain</h1>\n    <p>This domain is for use in illustrative examples in documents. You may use this\n    domain in literature without prior coordination or asking for permission.</p>\n    <p><a href=\"https://www.iana.org/domains/example\">More information...</a></p>\n</div>\n\n\n</body></html>"
}
保存後のHTMLファイルの例コンテンツ:
<!DOCTYPE html><html><head>
    <title>Example Domain</title>

    <meta charset="utf-8">
    <meta http-equiv="Content-type" content="text/html; charset=utf-8">
    <meta name="viewport" content="width=device-width, initial-scale=1">
    <style type="text/css">
    body {
        background-color: #f0f0f2;
        margin: 0;
        padding: 0;
        font-family: -apple-system, system-ui, BlinkMacSystemFont, "Segoe UI", "Open Sans", "Helvetica Neue", Helvetica, Arial, sans-serif;

    }
    div {
        width: 600px;
        margin: 5em auto;
        padding: 2em;
        background-color: #fdfdff;
        border-radius: 0.5em;
        box-shadow: 2px 3px 7px 2px rgba(0,0,0,0.02);
    }
    a:link, a:visited {
        color: #38488f;
        text-decoration: none;
    }
    @media (max-width: 700px) {
        div {
            margin: 0 auto;
            width: auto;
        }
    }
    </style>
</head>

<body>
<div>
    <h1>Example Domain</h1>
    <p>This domain is for use in illustrative examples in documents. You may use this
    domain in literature without prior coordination or asking for permission.</p>
    <p><a href="https://www.iana.org/domains/example">More information...</a></p>
</div>

</body></html>
プレーンテキスト
プレーンテキスト機能は、スクレイピングしたコンテンツをHTMLや Markdown形式ではなく、プレーンテキスト形式で返す出力オプションです。この機能は、HTMLタグや Markdownの書式が一切含まれない、クリーンでフォーマットされていないコンテンツバージョンが必要な場合に非常に実用的です。これによりコンテンツ抽出プロセスが合理化され、テキストの処理や分析がより 便利になります。
リクエストに input.jsRender.response.type=plaintext を追加:
const axios = require('axios');
const fs = require('fs');

(async () => {
    const payload = {
        actor: "unlocker.webunlocker",
        proxy: {
            country: "ANY"
        },
        input: {
            url: "https://www.example.com",
            jsRender: {
                enabled: true,
                response: {
                    type: "plaintext"
                }
            }
        }
    };

    const response = await axios.post("https://api.scrapeless.com/api/v2/unlocker/request", payload, {
        headers: {
            "x-api-token": "API Key",
            "Content-Type": "application/json"
        },
        timeout: 60000
    });

    if (response.data?.code === 200) {
        fs.writeFileSync('response.txt', response.data.data, 'utf8');
    }
})();ページのプレーンテキストコンテンツを文字列として返します。以下の例を参照してください。
{
    "code": 200,
    "data": "Example Domain\n\nThis domain is for use in illustrative examples in documents. You may use this domain in literature without prior coordination or asking for permission.\n\nMore information..."
}
保存後のtxtファイルの例の内容:
Example Domain

This domain is for use in illustrative examples in documents. You may use this domain in literature without prior coordination or asking for permission.

More information...
Markdown
Markdown形式でページコンテンツを抽出する場合、純粋に静的なMarkdownページが最適です。Web Unlocker APIは コンテンツをMarkdown形式で返します。 これにより、読みやすくなり、処理も容易になります。
リクエストに input.jsRender.response.type=markdown を追加します:
const axios = require('axios');
const fs = require('fs');

(async () => {
    const payload = {
        actor: "unlocker.webunlocker",
        proxy: {
            country: "ANY"
        },
        input: {
            url: "https://www.example.com",
            jsRender: {
                enabled: true,
                response: {
                    type: "markdown"
                }
            }
        }
    };

    const response = await axios.post("https://api.scrapeless.com/api/v2/unlocker/request", payload, {
        headers: {
            "x-api-token": "API Key",
            "Content-Type": "application/json"
        },
        timeout: 60000
    });

    if (response.data?.code === 200) {
        fs.writeFileSync('response.md', response.data.data, 'utf8');
    }
})();テキストコンテンツをMarkdown形式で返します。
{
    "code": 200,
    "data": "# Example Domain\n\nThis domain is for use in illustrative examples in documents. You may use this domain in literature without prior coordination or asking for permission.\n\n[More information...](https://www.iana.org/domains/example)"
}
Markdownファイルを保存した後の例の内容:
# Example Domain

This domain is for use in illustrative examples in documents. You may use this domain in literature without prior coordination or asking for permission.

[More information...](https://www.iana.org/domains/example)
PNG/JPEG
対象ページのスクリーンショットを取得し、
PNG形式の画像を
またはJPEG形式で返すことができます。レスポンス結果をPNGまたはJPEGに設定した場合、
input.jsRender.response.options.fullPage=true
パラメータを使用して、返される結果がページ全体のスクリーンショットかどうかを指定できます。
リクエストに input.jsRender.response.type=png or jpeg を追加することで:
const axios = require('axios');
const fs = require('fs');

(async () => {
    const payload = {
        actor: "unlocker.webunlocker",
        proxy: {
            country: "ANY"
        },
        input: {
            url: "https://www.example.com",
            jsRender: {
                enabled: true,
                response: {
                    type: "png" // png or jpeg
                }
            }
        }
    };

    const response = await axios.post("https://api.scrapeless.com/api/v2/unlocker/request", payload, {
        headers: {
            "x-api-token": "API Key",
            "Content-Type": "application/json"
        },
        timeout: 60000
    });

    if (response.data?.code === 200) {
        fs.writeFileSync('response.png', Buffer.from(response.data.data, 'base64'));
    }
})();PNGまたはJPEG形式のbase64エンコードされた文字列を返します。
{
    "code": 200,
    "data": "JVBERi0xLjQKJdPr6eEKM..."
}
png/jpeg形式で保存した後の例のファイル:
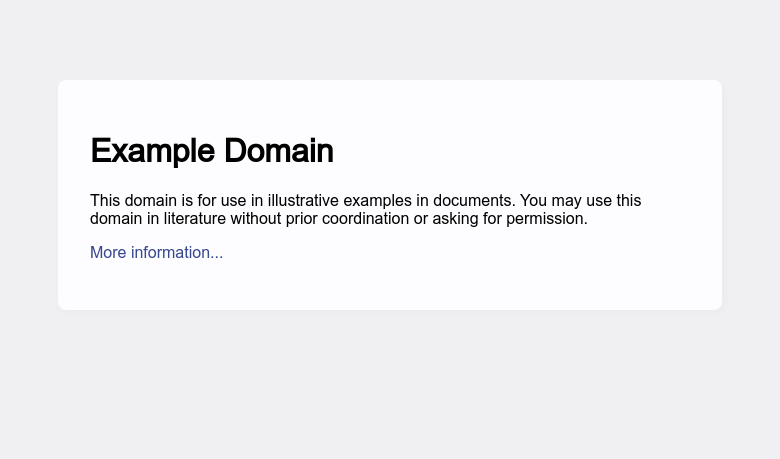
ネットワーク
input.jsRender.response.type=networkの場合、 XHR および fetch タイプのすべてのネットワークリクエストがキャプチャされます。
その後、
ネットワークリクエストデータはエスケープされたJSON文字列形式で返されます。このレスポンスデータには、URL、リクエスト
メソッド、レスポンスステータスコード、ヘッダー、レスポンスボディなどが含まれます。
リクエストまたはレスポンスボディにバイナリコンテンツ、大きすぎるレスポンスボディ、またはテキスト以外のデータが含まれる場合、元の
コンテンツは直接返されません。代わりに、プレースホルダ文字列 [Preview not available ...]
でマークされます。URL、リクエストメソッド、ステータスコードの条件を使用して結果をフィルタリングできます。
input.jsRender.response.options
パラメータを有効にします。
const axios = require('axios');
const fs = require('fs');

(async () => {
    const payload = {
        actor: "unlocker.webunlocker",
        proxy: {
            country: "ANY"
        },
        input: {
            url: "https://www.example.com",
            jsRender: {
                enabled: true,
                response: {
                    type: "network",
                    options: {
                        "urls": [
                            "/example"
                        ],
                        "status": [
                            200
                        ],
                        "methods": [
                            "get"
                        ]
                    }
                }
            }
        }
    };

    const response = await axios.post("https://api.scrapeless.com/api/v2/unlocker/request", payload, {
        headers: {
            "x-api-token": "API Key",
            "Content-Type": "application/json"
        },
        timeout: 60000
    });

    if (response.data?.code === 200) {
        fs.writeFileSync('response.json', response.data.data, 'utf8');
    }
})();エスケープされたJSON文字列でデータを返します:
{
    "code": 200,
    "data": "[{\"url\":\"https://www.tiktok.com/api/explore/item_list/...]"
}
JSONの例の結果は次のようになります:
[
{
"url": "https://www.tiktok.com/api/explore/item_list/?WebIdLastTime=1752724401&aid=1988&app_language=en&app_name=tiktok_web&browser_language=en&browser_name=Mozilla&browser_online=true&browser_platform=Win32&browser_version=5.0%20%28Windows%20NT%2010.0%3B%20Win64%3B%20x64%29%20AppleWebKit%2F537.36%20%28KHTML%2C%20like%20Gecko%29%20Chrome%2F135.0.0.0%20Safari%2F537.36&categoryType=120&channel=tiktok_web&clientABVersions=70508271%2C73485602%2C73547759%2C73720540%2C73810951%2C73814854%2C73848867%2C73866686%2C73944035%2C73969557%2C73990102%2C74048200%2C74129613%2C74148345%2C74157215%2C74163128%2C74176097%2C74195789%2C74213192%2C74241848%2C70405643%2C71057832%2C71200802%2C72361743%2C73171280%2C73208420&cookie_enabled=true&count=8&data_collection_enabled=false&device_id=7527893946556515853&device_platform=web_pc&enable_cache=true&focus_state=true&history_len=2&is_fullscreen=false&is_page_visible=true&language=en&odinId=7527893969448764429&os=windows&priority_region=&referer=®ion=US&screen_height=1440&screen_width=3440&tz_name=America%2FNew_York&user_is_login=false&webcast_language=en",
"method": "GET",
"resourceType": "fetch",
"status": 200,
"timestamp": 1752724403206,
"payload": null,
"requestReaders": {
"sec-ch-ua-platform": "\"Windows\"",
"referer": "https://www.tiktok.com/explore",
"user-agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/135.0.0.0 Safari/537.36",
"sec-ch-ua": "\"Google Chrome\";v=\"135\", \"Not-A.Brand\";v=\"8\", \"Chromium\";v=\"135\"",
"sec-ch-ua-mobile": "?0",
"accept": "*/*",
"cookie": "tt_csrf_token=KO5LUsj8-r2G0Lcbmx_RqngSiFd_VRcPiaeY; ttwid=1%7CQapzXhCnEqiLXypjvNK3iX65g9iXPk_Jpj4GGLdqNRY%7C1752724401%7Cfb5daf3940529652ba613376c011e990b0afede828ad52c4e0c14f1c422bea61; tt_chain_token=jIGTF0ppLEuXKFGayjhpyg=="
},
"responseHeaders": {
"access-control-expose-headers": "x-tt-traceflag,x-tt-logid",
"bd-tt-error-code": "0",
"cache-control": "max-age=1800, must-revalidate",
"content-encoding": "br",
"content-length": "30900",
"content-type": "application/json; charset=utf-8",
"date": "Thu, 17 Jul 2025 03:53:23 GMT",
"expires": "Thu, 17 Jul 2025 03:53:23 GMT",
"pragma": "no-cache",
"server": "nginx",
"server-timing": "cdn-cache; desc=HIT, edge; dur=0, origin; dur=0\ninner; dur=387",
"tt_stable": "1",
"x-akamai-request-id": "42a8e99d",
"x-cache": "TCP_MEM_HIT from a23-47-221-69.deploy.akamaitechnologies.com (AkamaiGHost/22.2.0-c471f2b4819e3aa253dfcc21bfdfd452) (-)",
"x-ms-token": "YAOuylbpReZ5gTM1PP8mwsmWMCxWprQ4oHRNuZQgKsADY7HTftSBu6W9raVm6PKyp-1mXt9Q6CIs0BHLRxozI_uNNEOWSvkaxFyunXX-54aBUvkuHBe2id6bY0cB",
"x-tt-logid": "20250717035100C13E2314287BF101E7D9",
"x-tt-trace-host": "0102b37aa413a15dcf9191a3f676ab4b78d5ba03a6d109c921ad21a607e80d7a40dbc340eb8c009458e52488a06a1b874047a91b63eb21ce08d01175dca60742a8bdf12f766710e93ed82ca68be07bf95a053639c5cedca212d37246317d611b65",
"x-tt-trace-id": "00-250717035100C13E2314287BF101E7D9-729F56051B790290-00",
"x-tt-trace-tag": "id=16;cdn-cache=hit;type=static"
},
"responseBody": {
"data": "omitted"
},
"responseSize": 249297,
"error": null
}
]コンテンツ
input.jsRender.response.type=contentの場合、ページコンテンツからJSON形式のデータがフィルタリングされ、レスポンスは
JSON形式の
文字列形式になります。 input.jsRender.response.options.outputs パラメータを使用すると、どのデータ型を正確に定義するかが可能になります。
必要な情報のみを効率的に取得できます。これにより、処理時間を短縮し、使用事例に最も関連するデータに集中できます。
効率的な取得が可能になります。
最も関連するデータに集中できます。
input.jsRender.response.options.outputs が空の場合、すべての出力が返されます。オプションの出力には以下が含まれます:
phone_numbers, headings, images, audios, videos, links, menus, hashtags, emails, metadata, tables,
favicon.
詳細な使用方法は、以下のコードを確認してください。
const axios = require('axios');
const fs = require('fs');

(async () => {
    // Configuration
    const url = "https://api.scrapeless.com/api/v2/unlocker/request";
    const token = "API Key";

    const headers = {"x-api-token": token, "Content-Type": "application/json"};

    const payload = {
        actor: "unlocker.webunlocker",
        proxy: {
            country: "ANY"
        },
        input: {
            url: "https://www.example.com",
            jsRender: {
                enabled: true,
                response: {
                    type: "content",
                    options: {
                        outputs: [
                            "phone_numbers",
                            "headings",
                            "images",
                            "audios",
                            "videos",
                            "links",
                            "menus",
                            "hashtags",
                            "emails",
                            "metadata",
                            "tables",
                            "favicon"
                        ]
                    }
                }
            }
        }
    };

    try {
        const response = await axios.post(url, payload, {headers, timeout: 60000});

        if (response.status !== 200) {
            throw newError(`HTTP Error: ${response.status}`);
        }

        const data = response.data;
        if (data.code !== 200) {
            throw newError(`API Error: ${data}`);
        }

        const content = data.data || '';

        // Save and return result
        fs.writeFileSync('response.json', content, 'utf8');
        console.log('✅ Success! Content saved as response.json');

        returnJSON.parse(content);

    } catch (error) {
        console.error('❌ Error:', error.message);
        throw error;
    }
})()以下にいくつかの例を示します:
メールアドレス
CSSセレクタと正規表現を使用して、例として example@example.comのような標準形式のメールアドレスを抽出します。
{
    "code": 200,
    "data": "{\"emails\":[\"market@scrapeless.com\"]}"
}
電話番号
CSSセレクタと正規表現を使用して電話番号を抽出します。特に tel:
プロトコルを含むリンクに注目します。
例:outputs=phone_numbers
{
    "code": 200,
    "data": "{ \"phone_numbers\": [ \"+1-111-111-111\" ] }"
}
見出し
H1 から H6 までのHTMLの見出しテキストを抽出します。
例:outputs=headings
{
    "code": 200,
    "data": "{\"headings\":[\"Example Domain\"]}"
}
画像
img タグから画像ソースを抽出します。 src 属性のみを返します。
例:outputs=images
{
    "code": 200,
    "data": "{\"images\":[\"https://www.scrapeless.com/_next/image?url=%2Fassets%2Fimages%2Ftoolkit%2Flight%2Fimg-2.png&w=750&q=100\"]}"
}
音声
メニュー内の source 要素から音声ソースを抽出します。 audio タグ内にあるものに限定し、 src 属性のみを返します。
例:outputs=audios
{
    "code": 200,
    "data": "{\"audios\":[\"https://example.com/audio.mp3\"]}"
}
動画
メニュー内の source 要素から動画ソースを抽出します。 video タグ内にあるものに限定し、 src 属性のみを返します。
例:outputs=videos
{
    "code": 200,
    "data": "{\"videos\":[\"https://example.com/video.mp4\"]}"
}
リンク
抽出するURLsは a タグから取得します。返されるのは href 属性のみです。
例:outputs=links
{
    "code": 200,
    "data": "{\"links\":[\"https://app.scrapeless.com/landing/guide\",\"https://www.scrapeless.com/en\",\"https://www.scrapeless.com/en/pricing\",\"https://docs.scrapeless.com/\",\"https://backend.scrapeless.com/app/api\",\"https://www.producthunt.com/posts/scrapeless-deep-serpapi\",\"https://www.g2.com/products/scrapeless/reviews\",\"https://www.trustpilot.com/review/scrapeless.com\",\"https://slashdot.org/software/p/Scrapeless/\",\"https://tekpon.com/software/scrapeless/reviews/\",\"https://www.scrapeless.com/en/product/deep-serp-api\",\"https://www.scrapeless.com/en/product/scraping-browser\",\"https://www.scrapeless.com/en/product/scraping-api\",\"https://www.scrapeless.com/en/product/universal-scraping-api\",\"https://www.scrapeless.com/en/solutions/e-commerce\",\"https://www.scrapeless.com/en/solutions/seo\",\"https://www.scrapeless.com/en/solutions/real-estate\",\"https://www.scrapeless.com/en/solutions/travel-hotel-airline\",\"https://www.scrapeless.com/en/solutions/social-media\",\"https://www.scrapeless.com/en/solutions/market-research\",\"https://www.scrapeless.com/en/blog\",\"https://www.scrapeless.com/en/blog/deep-serp-api-online\",\"https://www.scrapeless.com/en/blog/scrapeless-web-scraping-toolkit\",\"https://www.scrapeless.com/en/blog/google-shopping-scrape\",\"https://backend.scrapeless.com/app/api/v1/public/links/github\",\"https://backend.scrapeless.com/app/api/v1/public/links/youtube\",\"mailto:market@scrapeless.com\",\"https://www.scrapeless.com/en/ai-agent\",\"https://browserless.scrapeless.com/\",\"https://www.scrapeless.com/en/solutions/temu\",\"https://www.scrapeless.com/en/solutions/walmart\",\"https://www.scrapeless.com/en/solutions/shopee\",\"https://www.scrapeless.com/en/solutions/lazada\",\"https://www.scrapeless.com/en/solutions/amazon\",\"https://www.scrapeless.com/en/solutions/google-trends\",\"https://www.scrapeless.com/en/solutions/google-search\",\"https://www.scrapeless.com/en/solutions/airbnb\",\"https://www.scrapeless.com/en/solutions/scoot\",\"https://www.scrapeless.com/en/solutions/latam\",\"https://www.scrapeless.com/en/solutions/localiza\",\"https://www.scrapeless.com/en/solutions/tiktok\",\"https://www.scrapeless.com/en/solutions/instagram\",\"https://www.scrapeless.com/en/integration\",\"https://www.scrapeless.com/en/faq\",\"https://www.scrapeless.com/en/glossary\",\"https://www.scrapeless.com/en/legal/privacy-policy\",\"https://www.scrapeless.com/en/legal/terms\",\"https://www.scrapeless.com/en/legal/terms#refund-policy\",\"https://www.scrapeless.com/en/legal/check-your-data\",\"https://backend.scrapeless.com/app/api/v1/public/links/discord\"]}"
}
メニュー
メニュー内の li 要素からメニュー項目を抽出します。
例:outputs=menus
{
    "code": 200,
    "data": "{\"links\":[ \"Coffee\", \"Tea\", \"Milk\" ]}"
}
ハッシュタグ
正規表現を使用して典型的なハッシュタグパターン(例: #example)に一致するハッシュタグ形式を抽出します。
例:outputs = hashtags
{
    "code": 200,
    "data": "{\"hashtags\":[\"#docsearch\",\"#search\"]}"
}
メタデータ
メタ情報の取得元は meta タグで、 head セクション内にあるものを対象とします。返される name 属性と content 属性は、次の形式です:
形式 name: contentで返します。
例:outputs=metadata
{
    "code": 200,
    "data": "{\"metadata\":[\"viewport: width=device-width, initial-scale=1\",\"description: Scrapeless is the best full-stack web scraping toolkit offering Scraping API, Scraping Browser\"]}"
}
テーブル
テーブル要素からデータを抽出し、次元、ヘッダー、コンテンツを含むテーブルデータをJSON形式で返す。
例:outputs=tables
{
    "code": 200,
    "data": "{\"tables\":[{\"dimensions\":{\"rows\":7,\"columns\":3,\"heading\":true},\"heading\":[\"Company\",\"Contact\",\"Country\"],\"content\":[{\"Company\":\"Alfreds Futterkiste\",\"Contact\":\"Maria Anders\",\"Country\":\"Germany\"},{\"Company\":\"Centro comercial Moctezuma\",\"Contact\":\"Francisco Chang\",\"Country\":\"Mexico\"},{\"Company\":\"Ernst Handel\",\"Contact\":\"Roland Mendel\",\"Country\":\"Austria\"},{\"Company\":\"Island Trading\",\"Contact\":\"Helen Bennett\",\"Country\":\"UK\"},{\"Company\":\"Laughing Bacchus Winecellars\",\"Contact\":\"Yoshi Tannamuri\",\"Country\":\"Canada\"},{\"Company\":\"Magazzini Alimentari Riuniti\",\"Contact\":\"Giovanni Rovelli\",\"Country\":\"Italy\"}]},{\"dimensions\":{\"rows\":11,\"columns\":2,\"heading\":true},\"heading\":[\"Tag\",\"Description\"],\"content\":[{\"Tag\":\"<table>\",\"Description\":\"Defines a table\"},{\"Tag\":\"<th>\",\"Description\":\"Defines a header cell in a table\"},{\"Tag\":\"<tr>\",\"Description\":\"Defines a row in a table\"},{\"Tag\":\"<td>\",\"Description\":\"Defines a cell in a table\"},{\"Tag\":\"<caption>\",\"Description\":\"Defines a table caption\"},{\"Tag\":\"<colgroup>\",\"Description\":\"Specifies a group of one or more columns in a table for formatting\"},{\"Tag\":\"<col>\",\"Description\":\"Specifies column properties for each column within a <colgroup> element\"},{\"Tag\":\"<thead>\",\"Description\":\"Groups the header content in a table\"},{\"Tag\":\"<tbody>\",\"Description\":\"Groups the body content in a table\"},{\"Tag\":\"<tfoot>\",\"Description\":\"Groups the footer content in a table\"}]}]}"
}
ファビコン
ファビコンのURLを link 要素から抽出します。対象はHTMLの head セクションにある要素です。
例:outputs=favicon
{
    "code": 200,
    "data": "{\"favicon\":\"https://www.scrapeless.com/favicon.ico\"}"
}
リソース制御
パフォーマンスと帯域使用量の最適化のためのリソース読み込み制御システム。
{
  "actor": "unlocker.webunlocker",
  "proxy": {
    "country": "ANY",
    "url": ""
  },
  "input": {
    "url": "string",
    "jsRender": {
      "enabled": true,
      "block": {
        "resources": [
          "Image",
          "Font",
          "Stylesheet",
          "Script"
        ],
        "urls": [
          // Optional, URL pattern-based blocking
          "*.analytics.com/*",
          "*/ads/*"
        ]
      }
    }
  }
}
リソースタイプ完全リファレンス:
| リソースタイプ | 説明 | 影響 |
|---|---|---|
Document | メインドキュメントおよびiframe | コアページコンテンツ |
Stylesheet | CSSファイル | ページのスタイリングおよびレイアウト |
Image | 画像およびアイコン | ビジュアルコンテンツ |
Media | オーディオおよびビデオリソース | マルチメディアコンテンツ |
Font | Webフォント | テキストレンダリング |
Script | JavaScriptファイル | ページ機能 |
TextTrack | ビデオの字幕およびキャプション | メディアアクセシビリティ |
XHR | XMLHttpRequest呼び出し | レガシー非同期リクエスト |
Fetch | Fetch APIリクエスト | モダンな非同期リクエスト |
Prefetch | 事前取得されたリソース | パフォーマンス最適化 |
EventSource | サーバー送信イベント | リアルタイム更新 |
WebSocket | WebSocket接続 | 双方向通信 |
Manifest | Webアプリマニフェスト | PWA設定 |
SignedExchange | 署名済みHTTP交換 | コンテンツの真正性 |
Ping | Pingリクエスト | 分析およびトラッキング |
CSPViolationReport | CSP違反レポート | セキュリティ監視 |
Preflight | CORSプリフライトリクエスト | クロスオリジンセキュリティ |
Other | 未分類リソース | その他 |
使用例:
{
  "actor": "unlocker.webunlocker",
  "proxy": {
    "country": "ANY",
    "url": ""
  },
  "input": {
    "url": "string",
    "jsRender": {
      "enabled": true,
      "block": {
        "resources": [
          "Image",
          "Font",
          "Stylesheet",
          "Script",
          "Media",
          "Ping",
          "Prefetch"
        ]
      }
    }
  }
}
リソースブロッキングのベストプラクティス:
-
パフォーマンス最適化
- リソースブロッキングは賢く使用し、読み込みを高速化するために非必須リソースをブロック
- ネットワーク使用量を削減するために、
PrefetchとPingのブロックを検討してください。 - システムの重要な機能を維持するため、
Documentと重要なScriptリソースはブロックしないでください。
-
帯域管理
- 帯域幅を大量に消費するページでは、
ImageとMediaをブロックしてください。 - システムフォントを使用するために、
Fontのブロックを検討してください。
- 帯域幅を大量に消費するページでは、
-
安定性の向上
- リクエストの再試行メカニズムを実装
- エラー処理ロジックを追加
- 固定値ではなく
waitForを使用します。wait
-
リソース効率
- 必要に応じてリソースをオンデマンドで読み込む
- 不要な接続はすぐに閉じる
注意: リソースタイプの文字列は大文字小文字を区別します。参照テーブルに示されている通りに正確に一致させる必要があります。