概要
この Scrapeless MCPサーバー は、公式の Model Context Protocol 連携をScrapelessに提供します。LLM、AIエージェント、ChatGPT、Claude、Cursor、WindsurfなどのAIを活用したツール、および任意のMCP対応クライアントが、単一の統合サーバーを通じてウェブにリアルタイムでアクセスできます。
1つのサーバーで以下のことが可能です:
- 検索 GoogleのSERP、Trends、Scholar、Flightsなどを検索
- スクレイピング — 任意のページをHTML、Markdown、またはスクリーンショットとして取得し、Cloudflareなどのボット対策を回避します
- クロール — 深さや対象URLの範囲を設定してサイト全体をクロールします
- 自動化 スケーラブルなクラウドブラウザ:ナビゲート、クリック、入力、スクロール、抽出を実行
なぜScrapeless MCPなのか
ローカルでブラウザを自動化するMCPサーバーとは異なり、Scrapelessは完全に クラウドで動作し、開発者やAIエージェントに本番運用に適した拡張性と信頼性を提供します:
- ローカル設定が不要 — ブラウザのバイナリ、ドライバー、ヘッドレス設定を管理する必要がありません。
- 同時実行数に制限なし — 自動スケーリングするインフラにより、50~1,000以上のセッションを並列に実行できます。
- 検出回避機能を内蔵 — reCAPTCHA、Cloudflare Turnstile、AWS WAFに自動的に対応します。
- 世界各地のIPをカバー — 195か国以上の住宅用、ISP、無制限プロキシプールに対応します。
- 単一のAPIトークン — 1つのScrapelessキーで、同じサーバーを通じてすべての製品を利用できます。
Scrapeless MCPとサードパーティのブラウザMCPの比較
Scrapeless MCPは、Scrapeless独自の複数製品に対応するサーバーです。サードパーティのブラウザ用MCPサーバーが Scrapeless Cloud Browser をバックエンドとして接続する構成とは異なります:
| MCPサーバー | 技術スタック | 最適な用途 |
|---|---|---|
| Scrapeless MCP | クラウドサービス | 任意のMCPクライアントから、すべてのScrapeless製品にまたがる検索、スクレイピング、クローリング、ブラウザ自動化を実行。 |
| Chrome DevTools MCP | Node.js / Puppeteer | CI/CD自動化、IDE間ワークフロー、詳細なパフォーマンス監査。 |
| Playwright MCP | Node.js / Playwright | わずかなUI変更にも耐える、決定論的なアクセシビリティツリー自動化。 |
Chrome DevTools MCPおよびPlaywright MCPは、 外部連携 としてサードパーティのMCPをScrapeless Cloud Browserに接続して実行します。このセクションでは、Scrapeless独自のMCPサーバーを説明します。サードパーティの選択肢については、 関連する外部連携 を参照してください。
このセクションの内容
- クイックスタート — 2分以内にクライアントを接続します。
- 製品別ツール — Browser、Crawl、AI Scraper、Web Unlocker、Scraping API、Proxiesごとに分類したすべてのツールを紹介します。
- 認証とトランスポート — APIトークン、およびStdioとStreamable HTTPモードについて説明します。
- クライアントのセットアップ — Claude、Cursor、Cline、Codex、Windsurf、カスタムクライアントの設定手順を説明します。
- 設定 — セッション、プロファイル、動作に関するオプションを説明します。
ショーケース
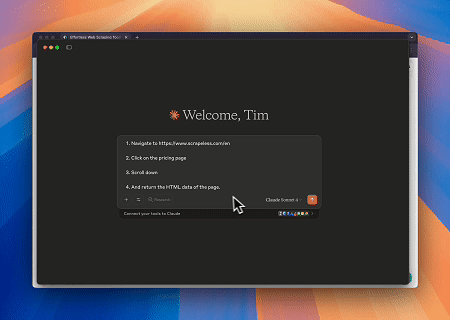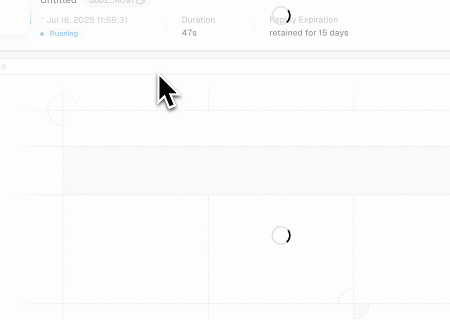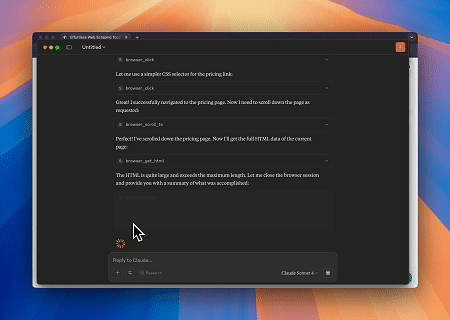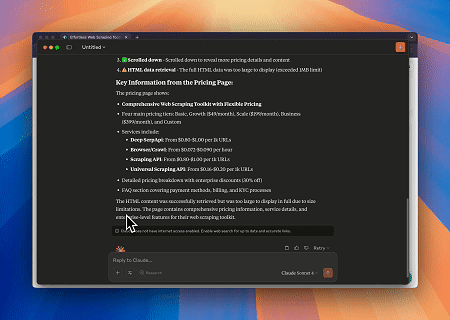
ケース1:Claudeによるウェブ操作とデータ抽出
Scrapeless MCP Serverを使用することで、Claudeはナビゲート、クリック、スクロール、データスクレイピングといった複雑なウェブ操作を会話形式のコマンドで実行でき、ライブセッションによるリアルタイム実行プレビューも可能になります。
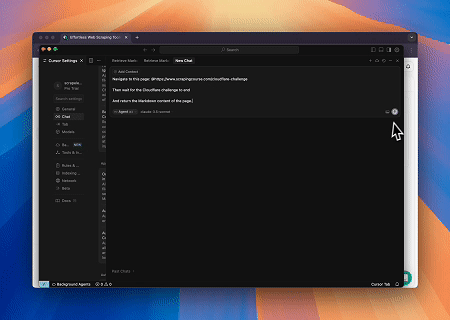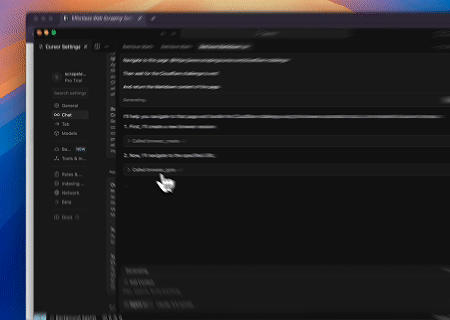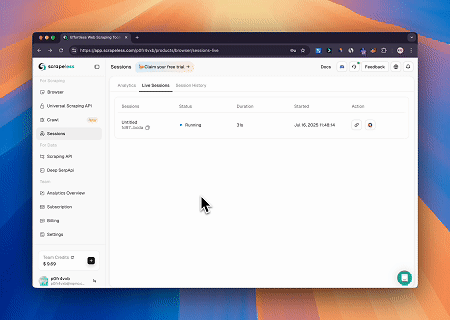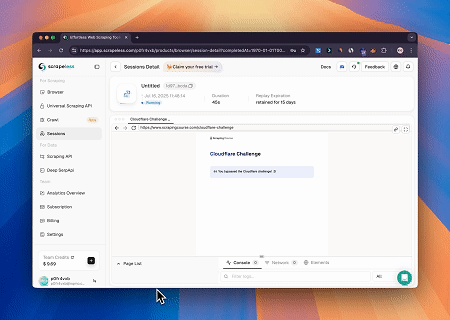
ケース2:Cloudflareをバイパスしてターゲットページのコンテンツを取得
Scrapeless MCP Serverを使用することで、Cloudflareで保護されたページに自動アクセスし、完了後にページのコンテンツを抽出してMarkdown形式で返します。