Vượt qua Cloudflare trong việc thu thập dữ liệu web
Agent Browser và Cloudflare
Tài liệu kỹ thuật này giải thích cách sử dụng các công cụ Scrapeless Agent Browser và Scrapeless Web Unlocker để xử lý nhiều thử thách bảo mật khác nhau do Cloudflare thiết lập. Các tính năng chính bao gồm vượt qua Cloudflare JS Challenge, Cloudflare Turnstile và thực thi kết xuất JavaScript để truy cập nội dung được Cloudflare bảo vệ. Tài liệu này sẽ cung cấp kiến thức nền tảng liên quan, giới thiệu tính năng, các bước thao tác và giải thích ví dụ mã.
Hiểu về các thử thách và lớp bảo mật của Cloudflare
Cloudflare, một dịch vụ bảo mật và hiệu năng web phổ biến, chủ yếu bảo vệ các trang web khỏi lưu lượng độc hại hoặc bất thường, chẳng hạn như bot và trình quét. Để làm điều này, Cloudflare triển khai nhiều cơ chế phát hiện và phòng thủ khác nhau, bao gồm nhưng không giới hạn ở:
1. JS Challenge (Thử thách JavaScript): Yêu cầu trình duyệt của khách truy cập thực thi mã JavaScript cụ thể để xác minh rằng đó là một môi trường trình duyệt hợp lệ với các chức năng tiêu chuẩn.
2. Giải pháp thay thế CAPTCHA Turnstile: Một cơ chế xác minh ít gây phiền nhiễu hơn để phân biệt giữa người dùng thật và bot.
3. Lấy dấu vân tay trình duyệt (Browser Fingerprinting): Thu thập và phân tích các đặc điểm kỹ thuật của trình duyệt và thiết bị (ví dụ: User-Agent, độ phân giải màn hình, phông chữ đã cài đặt, plugin) để nhận diện và theo dõi khách truy cập.
4. Giới hạn tần suất (Rate Limiting): Giám sát và giới hạn số lượng yêu cầu từ một nguồn duy nhất (ví dụ: địa chỉ IP) trong một khoảng thời gian cụ thể để ngăn chặn tấn công vét cạn hoặc lạm dụng tài nguyên.
Các lớp bảo mật này ngăn các thư viện yêu cầu HTTP cơ bản, các tập lệnh đơn giản hoặc các trình duyệt headless cấu hình không đúng cách truy cập các trang web được Cloudflare bảo vệ, dẫn đến việc xác minh thất bại và bị từ chối truy cập.
Sự khác biệt giữa Cloudflare JS Challenge và các thử thách khác
Điểm độc đáo của Cloudflare JS Challenge nằm ở phương pháp xác minh của nó. Nó không chỉ yêu cầu người dùng hoàn thành một tác vụ tương tác đơn giản (ví dụ: nhận dạng hình ảnh); nó đòi hỏi môi trường máy khách (trình duyệt) phải phân tích và thực thi thành công mã JavaScript được tạo động, thường bị làm rối, từ Cloudflare. Mã này thực hiện các kiểm tra môi trường, các tác vụ đòi hỏi nhiều tính toán hoặc logic khác để xác minh khả năng hành vi phức tạp của máy khách, mô phỏng một trình duyệt thật.
Việc vượt qua JS Challenge thành công liên quan đến việc tạo ra một token thông hành hợp lệ (thường ở dạng cookie cf_clearance). Token này chứng minh rằng máy khách đã vượt qua việc xác minh khả năng thực thi JavaScript. Nhiều công cụ tự động hóa thiếu một engine thực thi JavaScript hoàn chỉnh và khả năng mô phỏng môi trường trình duyệt thực tế, do đó thất bại trước các thử thách như vậy.
Vượt qua Cloudflare JS Challenge bằng Scrapeless Agent Browser
Scrapeless Agent Browser được thiết kế để xử lý các biện pháp bảo vệ trang web phức tạp, bao gồm Cloudflare JS Challenge.
Các bước và ví dụ mã
Thiết lập môi trường
Tạo thư mục dự án
Tạo một thư mục mới cho dự án, ví dụ: scrapeless-bypass.
Điều hướng đến thư mục đó trong terminal của bạn:
cd path/to/scrapeless-bypassKhởi tạo dự án Node.js
Chạy lệnh sau để tạo tệp package.json:
npm init -yCài đặt các phụ thuộc cần thiết
Cài đặt Puppeteer-core, cho phép kết nối từ xa đến các phiên bản trình duyệt:
npm install puppeteer-coreNếu Puppeteer chưa được cài đặt trên hệ thống của bạn, hãy cài đặt phiên bản đầy đủ:
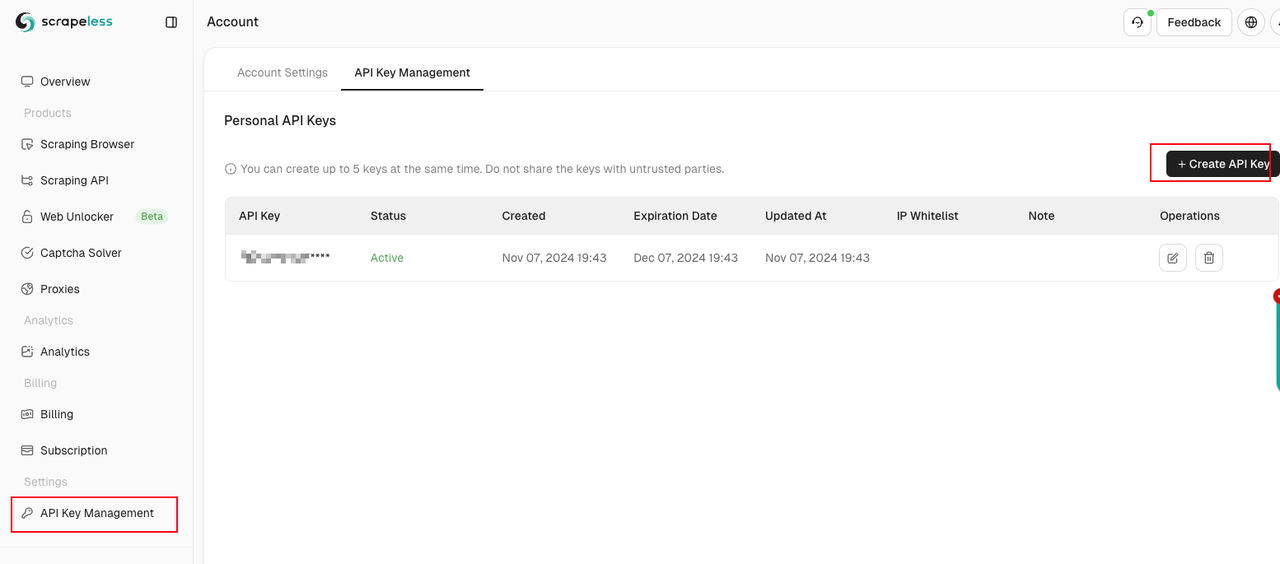
npm install puppeteer puppeteer-coreLấy và cấu hình API Key Scrapeless của bạn.
Kết nối và đảm bảo CAPTCHA được giải quyết thành công
Scrapeless tự động phát hiện và giải quyết CAPTCHA khi kết nối đến trình duyệt để truy cập trang web mục tiêu. Tuy nhiên, chúng ta cần đảm bảo CAPTCHA được giải quyết thành công. Scrapeless Agent Browser mở rộng CDP tiêu chuẩn (Chrome DevTools Protocol) với một bộ khả năng tùy chỉnh mạnh mẽ. Trạng thái của trình giải CAPTCHA có thể được quan sát trực tiếp bằng cách kiểm tra kết quả trả về từ CDP API:
Captcha.detected: Đã phát hiện CAPTCHACaptcha.solveFinished: Giải quyết CAPTCHA thành côngCaptcha.solveFailed: Giải quyết CAPTCHA thất bại
import puppeteer from "puppeteer-core";
import EventEmitter from 'events';
import { Scrapeless } from '@scrapeless-ai/sdk';

const emitter = new EventEmitter();

const client = new Scrapeless({ apiKey: 'API Key' });

const { browserWSEndpoint } = client.browser.create({
    sessionName: 'sdk_test',
    sessionTTL: 180,
    proxyCountry: 'ANY',
    sessionRecording: true,
    fingerprint,
});

export async function example(url) {
  const browser = await puppeteer.connect({
    browserWSEndpoint,
    defaultViewport: null
  });
  console.log("Verbonden met Scrapeless browser");
  try {
    const page = await browser.newPage();
    // Listen for captcha events
    console.debug("addCaptchaListener: Start listening for captcha events");
    await addCaptchaListener(page);
    console.log("Navigated to URL:", url);
    await page.goto(url, { waitUntil: "domcontentloaded", timeout: 30000 });
    console.log("onCaptchaFinished: Waiting for captcha solving to finish...");
    await onCaptchaFinished()
    // Screenshot for debugging
    console.debug("Taking screenshot of the final page...");
    await page.screenshot({ path: 'screenshot.png', fullPage: true });
  } catch (error) {
    console.error(error);
  } finally {
    await browser.close();
    console.log("Browser closed");
  }
}

async function addCaptchaListener(page) {
  const client = await page.createCDPSession();
  client.on("Captcha.detected", (msg) => {
    console.debug("Captcha.detected: ", msg);
  });
  client.on("Captcha.solveFinished", async (msg) => {
    console.debug("Captcha.solveFinished: ", msg);
    emitter.emit("Captcha.solveFinished", msg);
    client.removeAllListeners()
  });
}

async function onCaptchaFinished(timeout = 60_000) {
  return Promise.race([
    new Promise((resolve) => {
      emitter.on("Captcha.solveFinished", (msg) => {
        resolve(msg);
      });
    }),
    new Promise((_, reject) => setTimeout(() => reject('Timeout'), timeout))
  ])
}Quy trình ví dụ này truy cập trang web mục tiêu và xác nhận CAPTCHA được giải quyết thành công bằng cách lắng nghe sự kiện CDP Captcha.solveFinished. Cuối cùng, nó chụp ảnh màn hình của trang để xác minh.
Ví dụ này định nghĩa hai phương thức chính:
addCaptchaListener: để lắng nghe các sự kiện CAPTCHA trong phiên trình duyệtonCaptchaFinished: để chờ cho đến khi CAPTCHA được giải quyết
Đoạn mã ví dụ trên có thể được sử dụng để lắng nghe các sự kiện CDP cho ba loại CAPTCHA phổ biến được thảo luận trong bài viết này: reCAPTCHA v2, Cloudflare Turnstile, và Cloudflare 5s Challenge.
Lưu ý rằng Cloudflare 5s Challenge có phần đặc biệt. Đôi khi nó không kích hoạt một thử thách thực sự, và việc chỉ dựa vào phát hiện sự kiện CDP để xác định thành công có thể dẫn đến hết thời gian chờ (timeout). Do đó, việc chờ một phần tử cụ thể xuất hiện trên trang sau thử thách là một giải pháp ổn định hơn.
Kết nối đến Scrapeless Browserless WebSocket
Scrapeless cung cấp một kết nối WebSocket, cho phép Puppeteer tương tác trực tiếp với trình duyệt headless, vượt qua các thử thách của Cloudflare.
Địa chỉ kết nối WebSocket đầy đủ:
wss://browser.scrapeless.com/api/v2/browser?token=APIKey&sessionTTL=180&proxyCountry=ANYVí dụ mã: Vượt qua Cloudflare Challenge
Chúng ta chỉ cần đoạn mã sau để kết nối đến dịch vụ browserless của Scrapeless.
import puppeteer from 'puppeteer-core';

const API_KEY = 'your_api_key'
const host = 'wss://browser.scrapeless.com/api/v2';
const query = new URLSearchParams({
  token: API_KEY,
  sessionTTL: '180', // The life cycle of a browser session, in seconds
  proxyCountry: 'GB', // Agent country
  proxySessionId: 'test_session_id', // The proxy session id is used to keep the proxy ip unchanged. The session time is 3 minutes by default, based on the proxySessionDuration setting.
  proxySessionDuration: '5' // Agent session time, unit minutes
}).toString();

const connectionURL = `${host}/browser?${query}`;
const browser = await puppeteer.connect({
    browserWSEndpoint: connectionURL,
    defaultViewport: null,
});
console.log('Connected!')
Truy cập các trang web được Cloudflare bảo vệ và xác minh bằng ảnh chụp màn hình
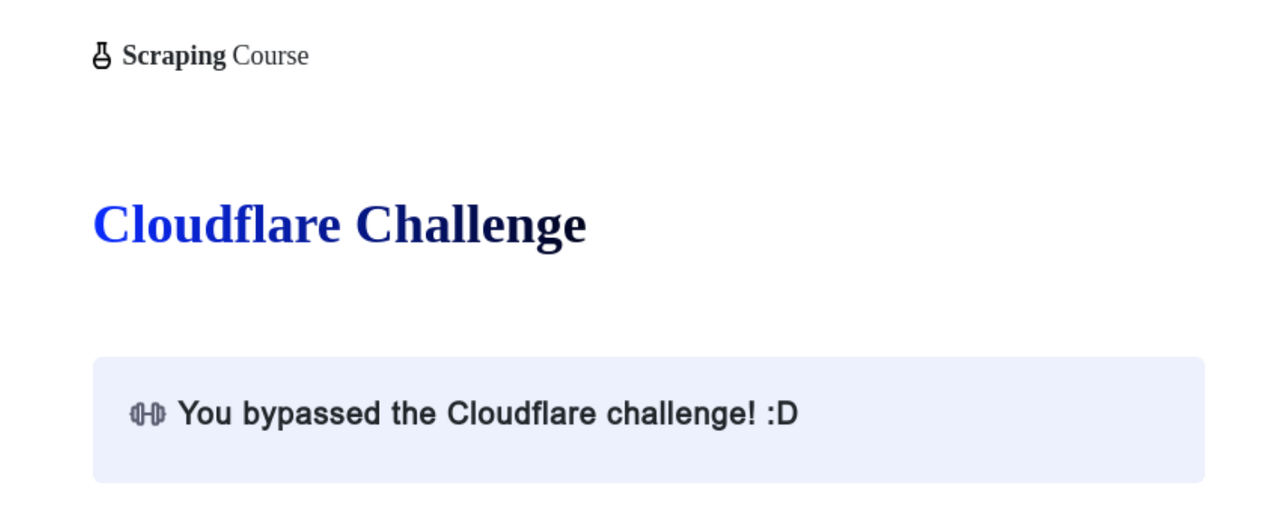
Tiếp theo, chúng ta sử dụng scrapeless browserless để truy cập trực tiếp trang thử nghiệm cloudflare-challenge và thêm một ảnh chụp màn hình, cho phép xác minh trực quan. Trước khi chụp ảnh màn hình, lưu ý rằng bạn cần sử dụng waitForSelector để chờ các phần tử trên trang, đảm bảo thử thách Cloudflare đã được vượt qua thành công.
const page = await browser.newPage();
await page.goto('https://www.scrapingcourse.com/cloudflare-challenge', {waitUntil: 'domcontentloaded'});
// By waiting for elements in the site page, ensuring that the Cloudflare challenge has been successfully bypassed.
await page.waitForSelector('main.page-content .challenge-info', {timeout: 30 * 1000})
await page.screenshot({path: 'challenge-bypass.png'});
Tại thời điểm này, bạn đã vượt qua thử thách Cloudflare bằng Scrapeless Browserless.
Lấy cookie cf_clearance và Header
Sau khi vượt qua thử thách Cloudflare, bạn có thể lấy các request header và cookie cf_clearance từ trang đã thành công.
const cookies = await browser.cookies()
const cfClearance = cookies.find(cookie => cookie.name === 'cf_clearance')?.value
Bật chặn yêu cầu (request interception) để thu thập các request header và khớp các yêu cầu của trang sau thử thách Cloudflare.
await page.setRequestInterception(true);
page.on('request', request => {
  // Match page requests after cloudflare challenge
  if (request.url().includes('https://www.scrapingcourse.com/cloudflare-challenge') && request.headers()?.['origin']) {
    const accessRequestHeaders = request.headers();
    console.log('[access_request_headers] =>', accessRequestHeaders);
  }
  request.continue();
});
Vượt qua Cloudflare Turnstile bằng Scrapeless Agent Browser
Scrapeless Agent Browser cũng xử lý các thử thách Cloudflare Turnstile.
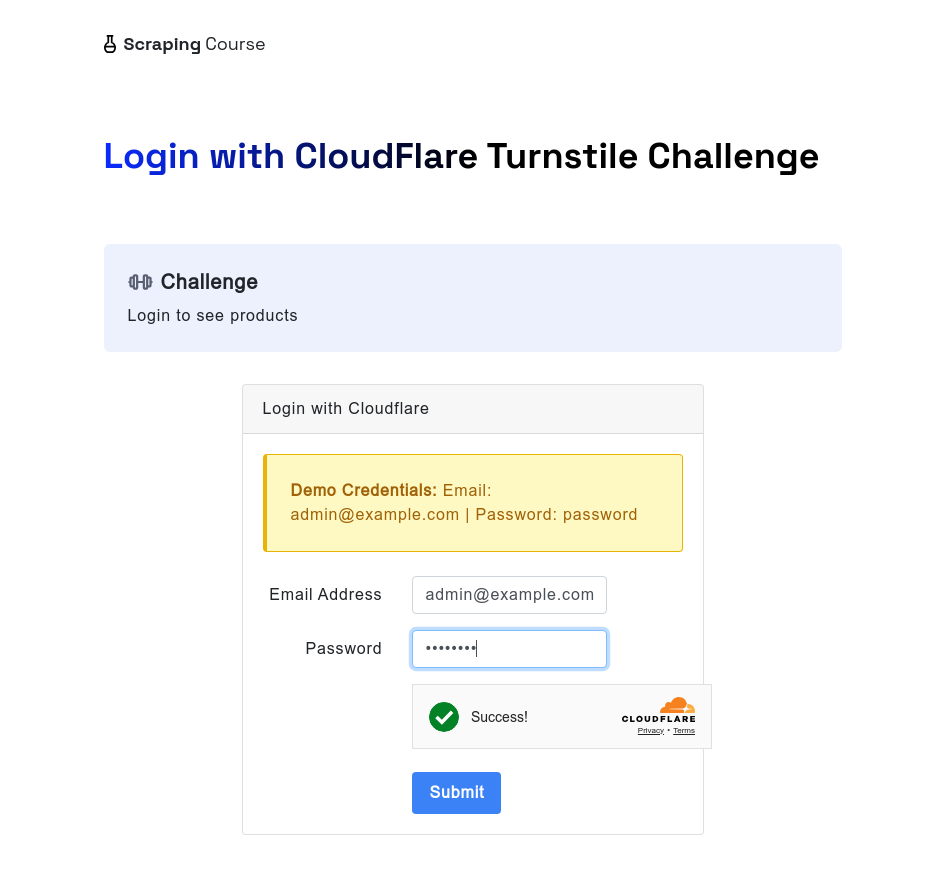
Tương tự, khi đối mặt với Cloudflare Turnstile, agent browser browserless vẫn có thể xử lý nó một cách tự động. Ví dụ sau đây truy cập trang thử nghiệm cloudflare-turnstile. Sau khi nhập tên người dùng và mật khẩu, nó sử dụng phương thức waitForFunction để chờ dữ liệu từ window.turnstile.getResponse(), đảm bảo thử thách được vượt qua thành công. Sau đó, nó chụp ảnh màn hình và nhấp vào nút đăng nhập để điều hướng đến trang tiếp theo.
Các bước và ví dụ mã:
const page = await browser.newPage();
await page.goto('https://www.scrapingcourse.com/login/cf-turnstile', { waitUntil: 'domcontentloaded' });
await page.locator('input[type="email"]').fill('admin@example.com')
await page.locator('input[type="password"]').fill('password')
// Wait for turnstile to unlock successfully
await page.waitForFunction(() => {
  return window.turnstile && window.turnstile.getResponse();
});
await page.screenshot({ path: 'challenge-bypass-success.png' });
await page.locator('button[type="submit"]').click()
await page.waitForNavigation()
await page.screenshot({ path: 'next-page.png' });
Sau khi chạy tập lệnh này, bạn sẽ thấy hiệu quả mở khóa qua các ảnh chụp màn hình.
Sử dụng Scrapeless Web Unlocker để kết xuất JavaScript
Đối với các trang web được Cloudflare bảo vệ mà nội dung cốt lõi dựa vào việc thực thi JavaScript phía máy khách để tải và hiển thị đầy đủ, Scrapeless Web Unlocker cung cấp một giải pháp chuyên dụng.
Scrapeless Universal API cho phép kết xuất JavaScript và tương tác động, biến nó thành một công cụ hiệu quả để vượt qua Cloudflare.
Kết xuất JavaScript
Kết xuất JavaScript hỗ trợ xử lý nội dung được tải động và các SPA (Ứng dụng trang đơn). Nó hỗ trợ một môi trường trình duyệt đầy đủ, xử lý các tương tác trang và yêu cầu kết xuất phức tạp hơn.
Với input.jsRender.enabled=true, chúng ta sẽ sử dụng trình duyệt cho yêu cầu
{
  "actor": "unlocker.webunlocker",
  "input": {
    "url": "https://www.google.com/",
    "jsRender": {
      "enabled": true
    }
  },
  "proxy": {
    "country": "US"
  }
}
Chỉ thị JavaScript
Cung cấp một bộ chỉ thị JavaScript phong phú, cho phép tương tác động với các trang web.
Các chỉ thị này cho phép nhấp vào các phần tử, điền biểu mẫu, gửi biểu mẫu hoặc chờ các phần tử cụ thể xuất hiện, mang lại sự linh hoạt cho các tác vụ như nhấp vào nút “Đọc thêm” hoặc gửi một biểu mẫu.
{
  "actor": "unlocker.webunlocker",
  "input": {
    "url": "https://example.com",
    "jsRender": {
      "enabled": true,
      "instructions": [
        {
          "waitFor": [
            ".dynamic-content",
            30000
          ]
          // Wait for element
        },
        {
          "click": [
            "#load-more",
            1000
          ]
          // Click element
        },
        {
          "fill": [
            "#search-input",
            "search term"
          ]
          // Fill form
        },
        {
          "keyboard": [
            "press",
            "Enter"
          ]
          // Simulate key press
        },
        {
          "evaluate": "window.scrollTo(0, document.body.scrollHeight)"
          // Execute custom JS
        }
      ]
    }
  }
}
Ví dụ vượt qua thử thách
Ví dụ sau đây sử dụng axios để gửi yêu cầu đến dịch vụ Web Unlocker của Scrapeless. Nó bật input.jsRender.enabled và sử dụng chỉ thị waitFor trong tham số input.jsRender.instructions để chờ một phần tử trên trang sau khi vượt qua thử thách Cloudflare:
import axios from 'axios'

async function sendRequest() {
  const host = "api.scrapeless.com";
  const url = `https://${host}/api/v2/unlocker/request`;
  const API_KEY = 'your_api_key'

  const payload = {
    actor: "unlocker.webunlocker",
    proxy: {
      country: "US"
    },
    input: {
      url: "https://www.scrapingcourse.com/cloudflare-challenge",
      jsRender: {
        enabled: true,
        instructions: [
          {
            waitFor: [
              "main.page-content .challenge-info",
              30000
            ]
          }
        ]
      }
    }
  }

  try {
    const response = await axios.post(url, payload, {
      headers: {
        'Content-Type': 'application/json',
        'x-api-token': API_KEY
      }
    });
    console.log("[page_html_body] =>", response.data);
  } catch (error) {
    console.error('Error:', error);
  }
}
sendRequest();
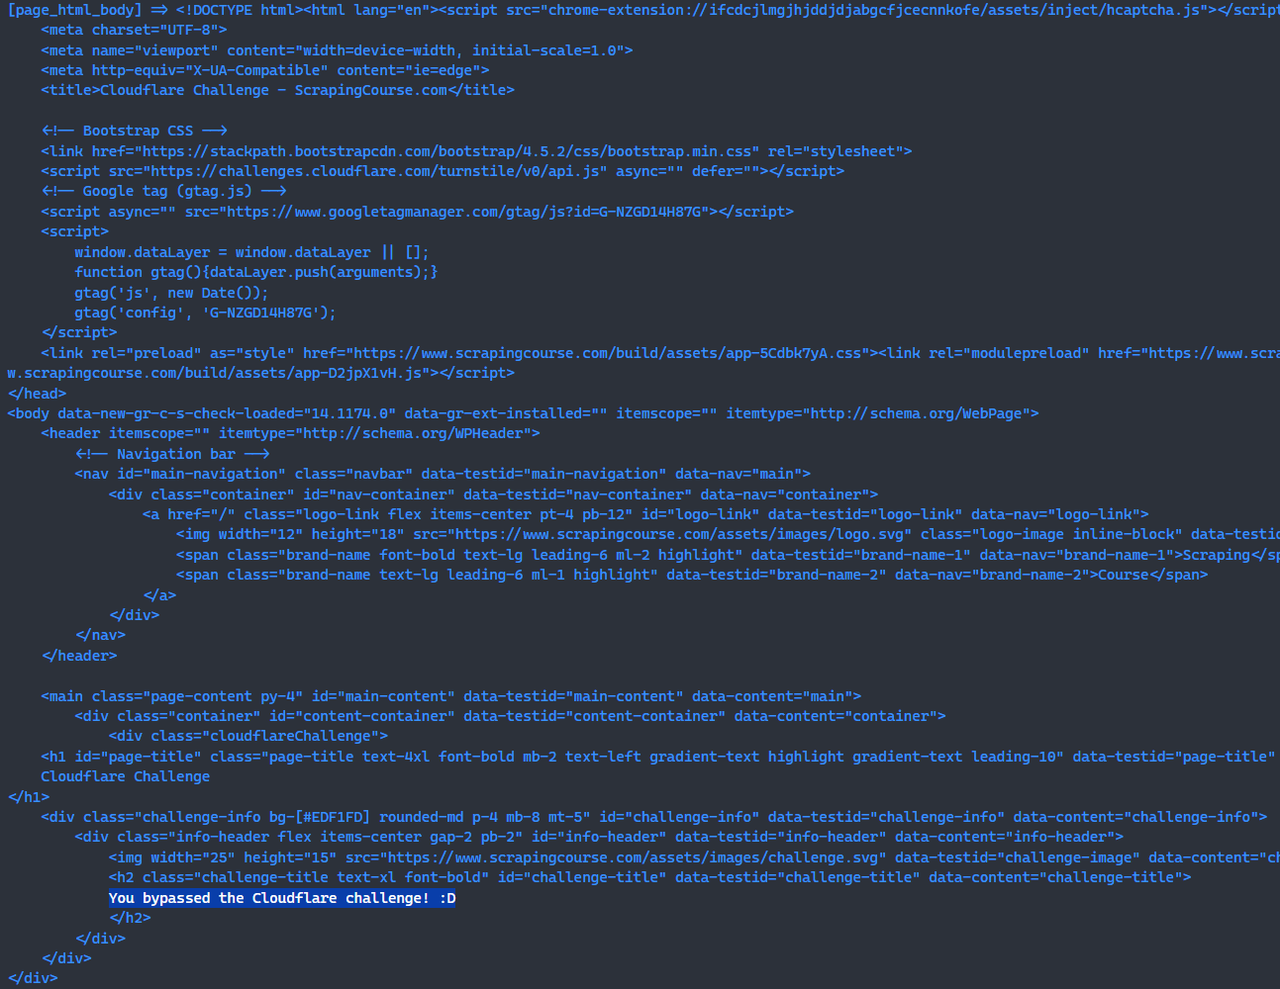
Sau khi chạy tập lệnh trên, bạn sẽ có thể thấy HTML của trang đã vượt qua thử thách Cloudflare thành công trong console.